Integracja funkcji AI z aplikacją PHP nie oznacza, że wszystkie dostępne informacje muszą opuszczać aplikację. Podsumowanie, klasyfikacja lub odpowiedź uwzględniająca kontekst często wymagają tylko części danych, które system przechowuje o danej osobie lub procesie. Decyzję należy oprzeć na konkretnym zadaniu i zweryfikować w rzeczywistym przepływie danych, a nie tylko w interfejsie, w którym wywoływany jest model.
Minimalizacja danych w integracjach AI z PHP polega na wysyłaniu wyłącznie informacji niezbędnych do określonego celu, przez czas i kanały wymagane do jego realizacji. Sama w sobie nie eliminuje zagrożeń dla prywatności: trzeba także kontrolować logi, błędy, odpowiedzi, uprawnienia i zewnętrzne zależności.
Prześledź przepływ danych, zanim zmienisz kod
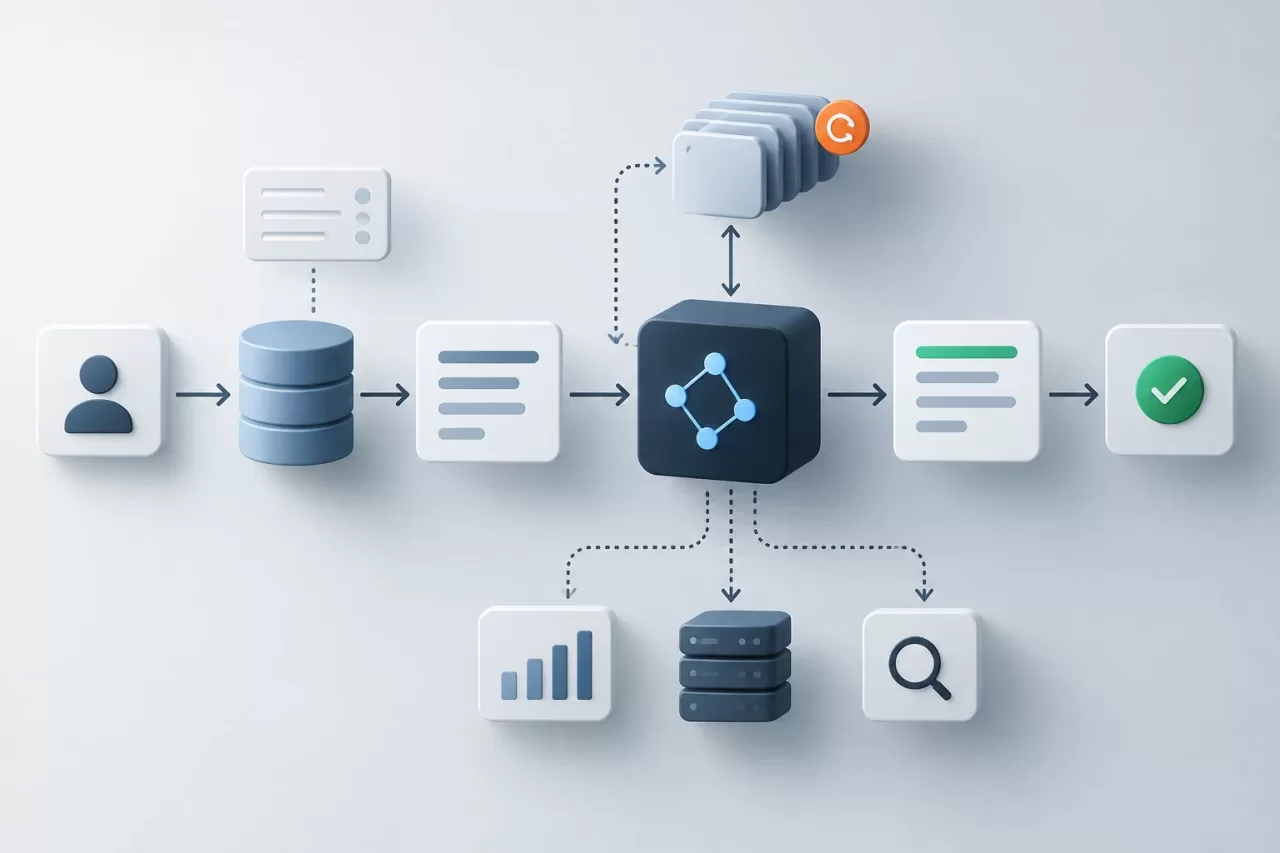
Udokumentuj, jakie dane trafiają do funkcji i co dzieje się z nimi później. Typowy przepływ obejmuje dane wejściowe użytkownika, pobranie kontekstu z bazy danych, przygotowanie wiadomości, żądanie do dostawcy lub usługi AI, odpowiedź i wewnętrzne logi. Sprawdź również, czy kolejki, ponowne próby, narzędzia obserwowalności lub wsparcia technicznego nie kopiują treści.
Dla każdego etapu określ podmiot odpowiedzialny, miejsce docelowe, cel i okres przechowywania. W PHP warto zlokalizować zarówno kod budujący żądanie, jak i miejsca, w których rejestrowane są wyjątki i zapisywane wyniki. Sprawdzenie wyłącznie wywołania HTTP pomija potencjalne kopie w śladach, danych debugowania lub zadaniach asynchronicznych.
- Jakie pola są pobierane, a które faktycznie trafiają do żądania?
- Czy żądanie zawiera kontekst wcześniejszych konwersacji lub załączniki?
- Co jest rejestrowane, jeśli połączenie zawiedzie, upłynie limit czasu lub odpowiedź będzie nieprawidłowa?
- Czy zapisywana jest cała odpowiedź, choć wystarczyłoby zachować potrzebny wynik?
Określ listę dozwolonych pól dla każdego zastosowania
Klasyfikuj pola według tego, czy są niezbędne do danego zadania, a nie według łatwości ich uzyskania. Przydatny podział obejmuje dane niezbędne, dane pomocne tylko w konkretnych przypadkach oraz dane, których nie należy wysyłać. Na przykład funkcja kategoryzująca wiadomość może potrzebować jej treści i ograniczonej listy kategorii, ale niekoniecznie imienia i nazwiska, adresu e-mail, adresu pocztowego ani pełnej historii autora.
Przełóż tę decyzję na osobną listę dozwolonych pól dla każdej funkcji. Unikaj serializowania całej encji lub bezpośredniego przekazywania obiektu domenowego do warstwy AI: takie obiekty mogą już zawierać wrażliwe pola albo zyskać je w przyszłości. Zbuduj jawny obiekt transferu danych z zatwierdzonymi wartościami i zweryfikuj jego strukturę przed utworzeniem żądania.
$input = [
    'message' => $ticket->publicMessage(),
    'allowed_categories' => $categoryNames,
];

$payload = $validator->validate($input);
Walidacja powinna nakładać limity rozmiaru i formatu, a także sprawdzać, czy nie pojawiają się pola spoza listy. Oddziel uprawnienia do odczytu informacji w aplikacji od decyzji o umieszczeniu ich w żądaniu: to, że proces PHP może uzyskać dostęp do danych, nie oznacza, że funkcja AI ich potrzebuje.
Ogranicz identyfikatory, nie polegając wyłącznie na pseudonimizacji
Jeśli zadanie wymaga rozróżniania rekordów, ale nie znajomości prawdziwej tożsamości, można zastąpić bezpośrednie identyfikatory wewnętrznymi odwołaniami lub pseudonimami. Tabelę łączącą odwołanie z osobą przechowuj w aplikacji, poza wysyłaną treścią, i ogranicz do niej dostęp. Nie wysyłaj kluczy pozwalających odtworzyć tożsamość, jeśli nie jest to niezbędne.
Pseudonimizacja nie jest równoznaczna z anonimizacją. Tekst swobodny może ujawnić tożsamość za pomocą nazwisk, stanowisk, lokalizacji, dat, szczegółów zdarzenia lub kombinacji różnych atrybutów. Tożsamość może też zostać ponownie ustalona przez zestawienie danych z innymi informacjami. Sprawdzaj treść i kontekst, a nie tylko ustrukturyzowane pola; w razie potrzeby usuń, zamaskuj lub uogólnij szczegóły przed ich wysłaniem.
Jeśli usunięcie danych obniża jakość odpowiedzi, przetestuj mniej identyfikujące rozwiązania: przedziały zamiast dokładnych wartości, kategorie zamiast opisów osobistych lub podsumowanie przygotowane przez aplikację. Informacje potrzebne do powiązania odpowiedzi z właściwym rekordem przechowuj w PHP, chyba że zadanie wymaga czegoś innego.
Informacje, których model nie potrzebuje, pozostaw pod kontrolą PHP
Oddziel przygotowanie kontekstu od logiki biznesowej. PHP może egzekwować uprawnienia, rozwiązywać relacje, wybierać pola i łączyć wynik AI z danymi, które nigdy nie zostały wysłane. Funkcja może zwrócić etykietę lub sugestię; aplikacja nadal odpowiada za sprawdzenie poprawności wyniku i podjęcie decyzji o wykonaniu działania.
Określ ograniczenia dla odpowiedzi: oczekiwany format, długość, dozwolone wartości i sposób obsługi nieoczekiwanej treści. Jeśli wynik jest wyświetlany użytkownikom, odpowiednio zakoduj go w kontekście prezentacji i nie traktuj jako zaufanej instrukcji. Jeśli może wywołać operację — na przykład zmienić rekord — wymagaj dodatkowej walidacji, a zależnie od skutków także potwierdzenia człowieka.
Błędy również są częścią projektu. Określ, co robić w razie przekroczenia limitu czasu, błędu dostawcy, pustej odpowiedzi lub formatu, którego nie można zinterpretować. Zależnie od przypadku można poprosić użytkownika o ponowną próbę, udostępnić operację ręczną albo kontynuować bez tej funkcji. Unikaj nieograniczonej liczby ponowień i nie zwracaj użytkownikowi wewnętrznych szczegółów zawierających żądania, dane uwierzytelniające lub dane osobowe.
Nie pozwól, by logi stały się drugą kopią danych
Rejestruj przydatne sygnały operacyjne — identyfikator korelacji, czas trwania, status i kod błędu — bez automatycznego zapisywania pełnego promptu i odpowiedzi. Jeśli zachowanie treści jest potrzebne do zbadania problemu, określ cel, dostęp i okres przechowywania, a także rozważ widok z usuniętymi lub zamaskowanymi danymi albo środowisko testowe z danymi syntetycznymi.
Sprawdź komunikaty wyjątków, narzędzia monitorujące, kolejki i logi audytowe. Błąd nie powinien domyślnie odtwarzać całego żądania. Ta sama zasada dotyczy tymczasowego debugowania: ogranicz możliwość jego włączenia, w miarę możliwości unikaj rzeczywistych danych i upewnij się, że nie pozostanie aktywne na produkcji.
Sprawdź użyteczność i ograniczenia na reprezentatywnych testach
Przed włączeniem przepływu przygotuj przypadki odzwierciedlające typowe dane wejściowe, sytuacje graniczne i błędy, nie używając rzeczywistych danych osobowych, chyba że jest to uzasadnione i objęte odpowiednimi zabezpieczeniami. Porównaj działanie funkcji z przewidzianym zestawem pól i jego zredukowaną wersją. Oceń, czy funkcja wykonuje zadanie, czy zmyśla lub błędnie klasyfikuje oraz czy nieprawidłowa odpowiedź może wyrządzić szkodę.
Dodaj testy automatyczne sprawdzające, czy wykluczone pola nie pojawiają się w payloadzie, duże dane wejściowe są ograniczane, dane po usunięciu lub zamaskowaniu szczegółów nie trafiają do logów, a odpowiedzi w nieoczekiwanym formacie są odrzucane lub bezpiecznie obsługiwane. Powtarzaj te kontrole po zmianie schematu danych, promptu, dostawcy lub logiki przygotowania.
Lista kontrolna przed włączeniem funkcji
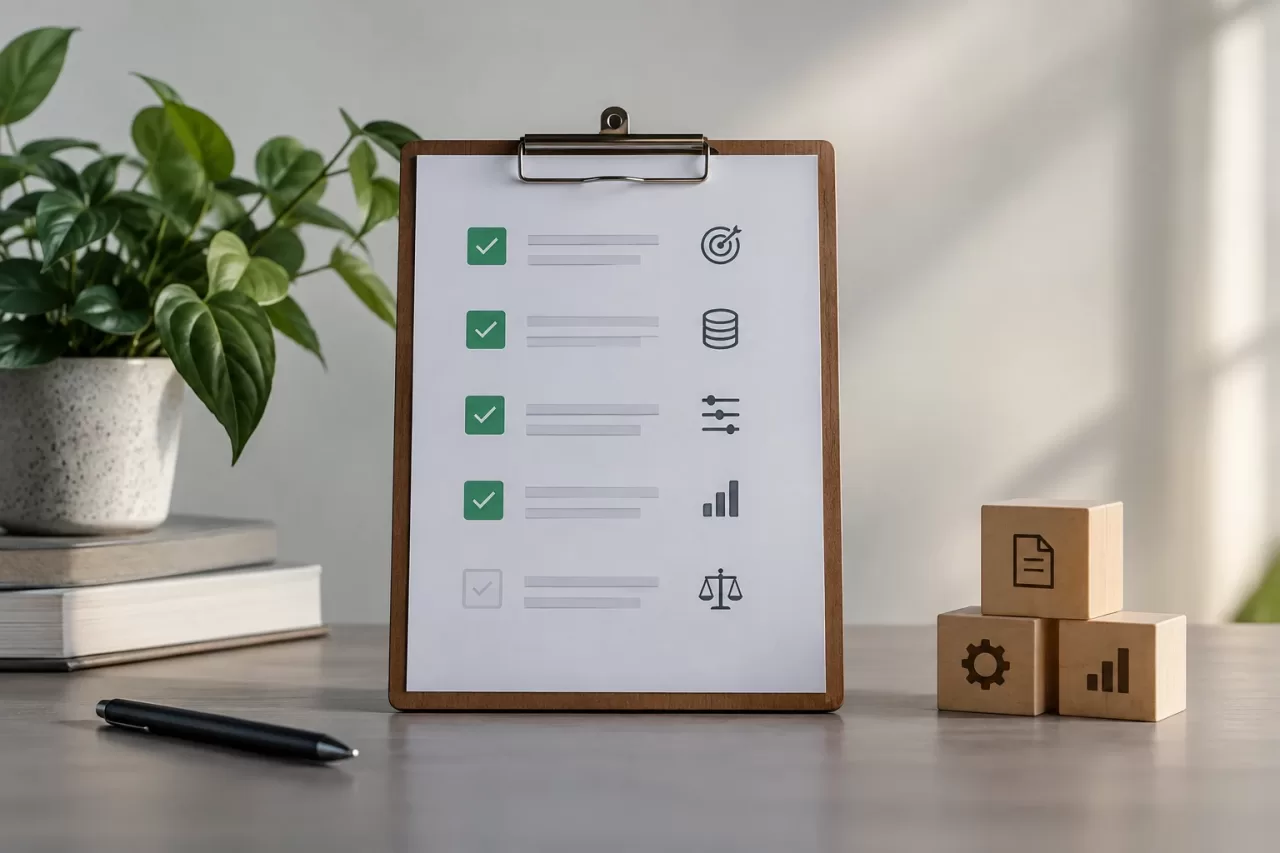
- Cel jest określony, a wysłanie każdego pola ma konkretne uzasadnienie.
- Payload jest budowany na podstawie listy dozwolonych pól, a nie całej encji.
- Identyfikatory i teksty swobodne są sprawdzane pod kątem ryzyka ponownej identyfikacji.
- Aplikacja zachowuje kontrolę nad uprawnieniami, regułami biznesowymi i danymi, których AI nie potrzebuje.
- Żądania, odpowiedzi i błędy nie są bez kontroli kopiowane do logów ani śladów.
- Obowiązują limity danych wejściowych, walidacja wyników i rozwiązanie awaryjne.
- Testy sprawdzają zarówno użyteczność, jak i brak wykluczonych pól.
- Zespół wie, które zmiany w przepływie wymagają ponownej oceny.
Właściwa decyzja nie polega ani na wysyłaniu jak największej ilości kontekstu, ani na bezrefleksyjnym usuwaniu danych. Należy uzasadnić każde pole w odniesieniu do zadania, zachować kontrolę w PHP i sprawdzić, czy ograniczenie danych utrzymuje akceptowalną użyteczność bez niepotrzebnego zwiększania zakresu ich ujawnienia.