
Integracja może działać prawidłowo, a mimo to pozostawiać różne dane w dwóch systemach. Żądanie może przekroczyć limit czasu po tym, jak system zewnętrzny zapisze zmianę; zdarzenie może dotrzeć z opóźnieniem; lokalna aktualizacja może też zmienić pole, nad którym kontrolę sprawuje również drugi system. Dlatego oprócz synchronizowania zdarzeń warto mieć możliwość porównywania stanów i świadomego rozstrzygania rozbieżności.
Uzgadnianie danych między systemami w PHP to wykonywany okresowo lub na żądanie proces, który wykrywa różnice między powiązanymi rekordami, określa ich znaczenie oraz proponuje lub wykonuje odpowiednie działanie. Nie polega na bezwarunkowym kopiowaniu danych z jednego systemu do drugiego. Aby uniknąć utraty prawidłowych informacji, trzeba określić, które źródło jest nadrzędne dla poszczególnych danych, zachować dowody porównania i zabezpieczyć aplikację przed wielokrotnym lub masowym stosowaniem korekt.
Określ, który system jest źródłem nadrzędnym, zanim rozpoczniesz porównanie
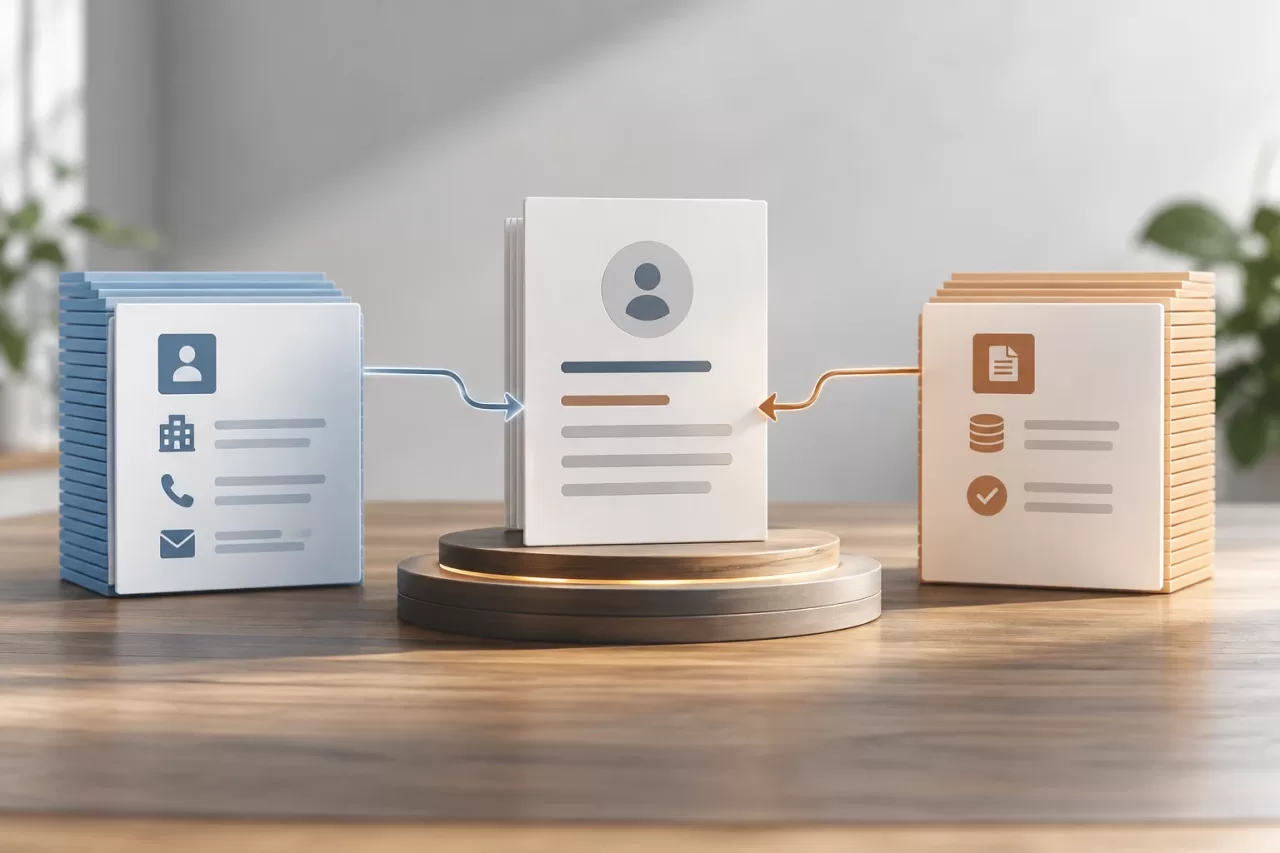
Źródło prawdy nie zawsze jest takie samo dla całej encji. CRM może odpowiadać za nazwę handlową i dane kontaktowe, a system fakturowania — za status płatności i zweryfikowany identyfikator podatkowy. Jeśli bez sprawdzenia pól uznasz cały system za nadrzędny, uzgadnianie może zastąpić prawidłowe informacje nieaktualną lub niekompletną kopią.
Udokumentuj własność wymienianych pól. Dla każdego z nich zapisz, który system może inicjować zmiany, który powinien mieć pierwszeństwo w razie konfliktu, czy wartość może być null oraz jakie przekształcenia są dopuszczalne. Warto też rozróżnić pola edytowalne i pochodne: na przykład łączna kwota może wymagać ponownego obliczenia na podstawie składowych zamiast skopiowania.
- Źródło nadrzędne dla pola: określ, kto decyduje o jego wartości i co zrobić, gdy oba systemy zgłaszają zmiany.
- Reguły łączenia: sprecyzuj, czy można uzupełnić brakującą wartość bez zastępowania istniejącej.
- Wyjątki: wskaż, które konflikty wymagają zatwierdzenia, dodatkowej walidacji lub interwencji odpowiedzialnego zespołu.
Jeśli nie ma bezpiecznej reguły, właściwym działaniem jest oznaczenie konfliktu do weryfikacji, a nie arbitralny wybór rekordu z najnowszą datą. Zegary mogą się różnić, a sam znacznik czasu nie dowodzi, że zmiana jest prawidłowa.
Zapewnij powtarzalność porównania
Przydatne porównanie wymaga identyfikacji tego samego rekordu po obu stronach. Użyj wspólnego, stabilnego identyfikatora lub jawnie utrzymywanej tabeli mapowań. Nie opieraj się wyłącznie na nazwach, adresach e-mail ani innych polach, które mogą się zmieniać, powtarzać lub być różnie normalizowane. Jeśli nie można jednoznacznie ustalić powiązania, oznacz przypadek jako oczekujący na powiązanie zamiast łączyć rekordy na podstawie przybliżonego dopasowania.
Porównuj wartości znormalizowane według udokumentowanych reguł, na przykład dotyczących spacji, wielkości liter lub formatów daty. Zachowuj również wartość oryginalną, ponieważ normalizacja na potrzeby porównania nie upoważnia do zmiany zapisanych danych. Zwróć uwagę na strefy czasowe, precyzję wartości dziesiętnych, puste wartości oraz różnicę między nieobecnym polem a polem obecnym z wartością null. Uznanie tych stanów za równoważne może ukryć istotne zmiany.
W przypadku dużych zbiorów danych określ zakres przetwarzania i punkt kontrolny, na przykład datę modyfikacji lub kursor paginacji. Zapisuj punkt postępu dopiero po spójnym przetworzeniu partii. Jeśli dostawca nie zapewnia wiarygodnych znaczników, rzadsze pełne skanowanie lub połączenie próbkowania z ukierunkowanym uzgadnianiem może być bezpieczniejsze niż zakładanie przyrostowego przetwarzania, którego API nie gwarantuje. Strategia zależy od ograniczeń, stabilności i rzeczywistych gwarancji każdego systemu.
W PHP oddziel pobieranie danych od ich porównywania i zapisywania wyników. Na przykład funkcja porównująca może przyjmować dwie znormalizowane reprezentacje i zwracać listę typowanych różnic, bez wykonywania zdalnych wywołań ani aktualizowania rekordów. Takie rozdzielenie ułatwia testowanie reguł na kontrolowanych przypadkach i weryfikowanie propozycji przed włączeniem zapisu.
Klasyfikuj rozbieżności i decyduj o sposobie reakcji
Nie każda różnica oznacza błąd, a każda jej kategoria wymaga odrębnej polityki. Jawna klasyfikacja usprawnia diagnostykę i zapobiega stosowaniu jednej destrukcyjnej reguły do różnych sytuacji.
- Brakujący rekord: rekord istnieje w jednym systemie, ale nie w drugim. Sprawdź, czy chodzi o niedawne utworzenie, prawidłowe usunięcie, filtr lub błąd paginacji.
- Duplikat: kilka rekordów wygląda na powiązane z tą samą encją. Nie wybieraj jednego automatycznie bez weryfikowalnej reguły ustalania tożsamości.
- Niezgodna zmiana: obie strony zmieniły pole, nad którym obie sprawują kontrolę. Zastosuj regułę własności albo skieruj konflikt do weryfikacji.
- Nieprawidłowe dane: wartość nie spełnia oczekiwanego formatu lub ograniczeń. Umieść ją w kwarantannie i nie propaguj dalej.
- Opóźnienie synchronizacji: różnica może wynikać z opóźnienia dostarczenia lub przetwarzania. Ponów próbę albo odczekaj określony czas, zanim uznasz konflikt za trwały.
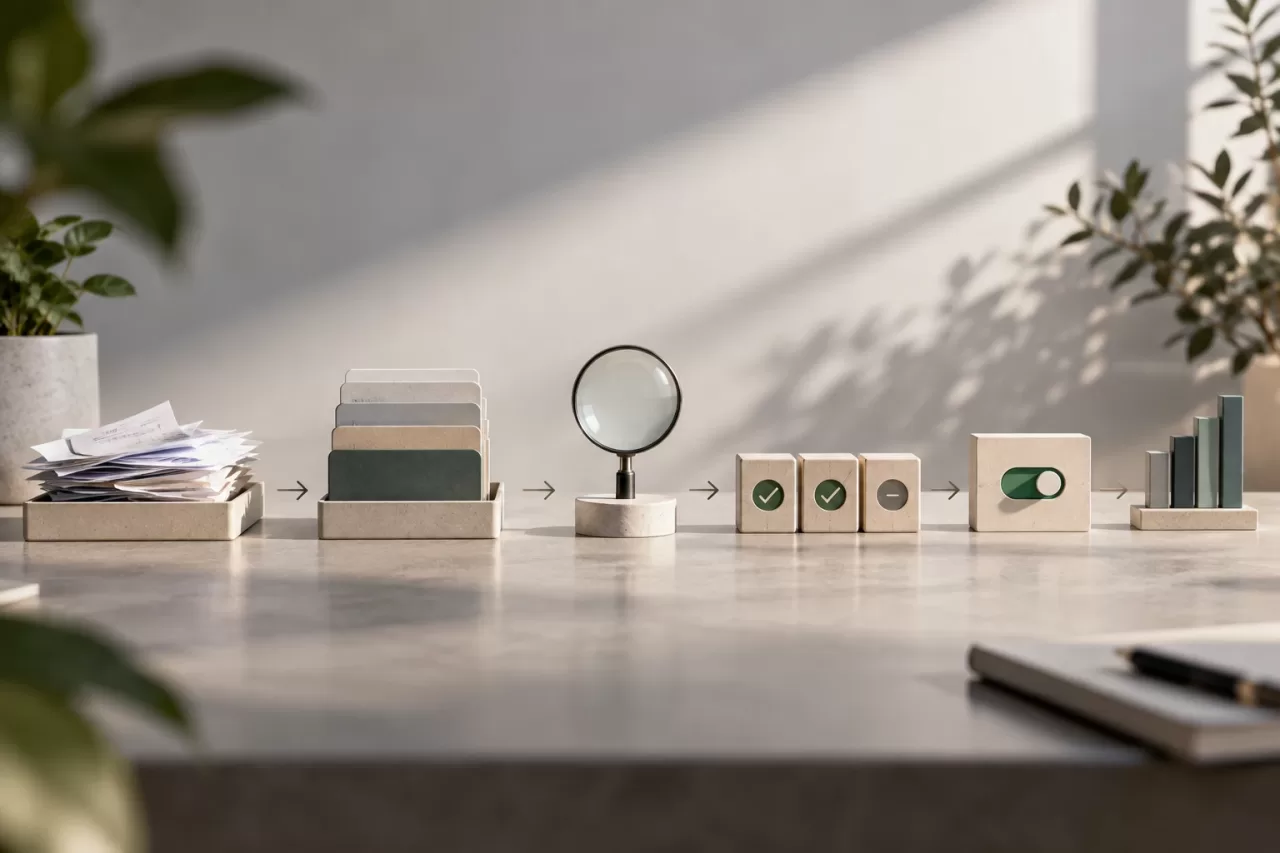
Rozdziel trzy etapy: wykrycie różnicy, decyzję o działaniu i zastosowanie zmiany. Propozycja może obejmować aktualizację pola, utworzenie powiązania, prośbę o weryfikację lub brak działania. Oddzielenie tych etapów pozwala rozpocząć od trybu tylko do odczytu i sprawdzić, co uległoby zmianie, zanim zostaną włączone automatyczne korekty.
Wprowadzaj zmiany, nie powodując nowych szkód
Automatyzuj wyłącznie przypadki objęte jasnymi i weryfikowalnymi regułami. W pozostałych udostępnij kolejkę weryfikacji zawierającą identyfikator encji, zaobserwowane wartości, regułę, która zostałaby zastosowana, oraz proponowane działanie. Interfejs lub proces operacyjny powinien umożliwiać zaakceptowanie, odrzucenie lub eskalację propozycji, a w razie potrzeby także odnotować, kto podjął decyzję.
Projektuj operacje jako idempotentne: ponowne przetworzenie tej samej rozbieżności nie może tworzyć duplikatów ani bez końca przełączać wartości. Przed zapisem sprawdź, czy rekord nadal ma oczekiwany stan. Jeśli odczytane dane uległy zmianie, wstrzymaj aktualizację i ponownie wykonaj porównanie. Jeśli zewnętrzne API na to pozwala, używaj wersji, warunków zapisu lub kluczy idempotencji; nie zakładaj, że są dostępne, dopóki tego nie zweryfikujesz.
Ogranicz zakres za pomocą małych partii, limitu zmian na jedno uruchomienie i opcji wstrzymania. Korekta przekraczająca przewidywaną skalę powinna zostać zatrzymana lub wymagać autoryzacji, a nie być kontynuowana po cichu. W przypadku zmian o dużym wpływie zapisz możliwą operację kompensacyjną, ale nie przedstawiaj jej jako gwarancji wycofania: mogły już nastąpić kolejne zmiany lub zewnętrzne skutki, których nie da się cofnąć.
Rejestruj każde uruchomienie, aby móc je analizować i powtarzać
Zapisuj identyfikator uruchomienia, czas rozpoczęcia i zakończenia, przetworzony zakres lub kursor, odpytane systemy, wyniki dla poszczególnych kategorii oraz błędy. Dla każdej rozbieżności zachowuj klucz korelacyjny, istotne wartości lub ich zabezpieczoną reprezentację, ocenioną regułę, proponowane działanie oraz wynik jego zastosowania. Pozwala to wyjaśnić, dlaczego podjęto daną decyzję, i odróżnić błąd integracji od rzeczywistego konfliktu.
Chroń logi: mogą zawierać dane osobowe, pośrednie dane uwierzytelniające lub informacje handlowe. Nie zapisuj pełnych payloadów, jeśli wystarczą konkretne pola; ogranicz dostęp i określ okres retencji. Dodawaj odnośniki do rekordów źródłowych i czas obserwacji, aby ułatwić analizę bez przekształcania logu w drugą, niekontrolowaną bazę danych.
Ponawiaj wyłącznie błędy przejściowe, z ograniczoną liczbą prób i rosnącymi odstępami. Rejestruj ponowienia i oddzielaj błędy trwałe — takie jak nieprawidłowe dane lub niewystarczające uprawnienia — aby uniknąć cykli powtarzających ten sam problem. Uruchomienie powinno dać się wznowić według znanego kryterium, a nie zależeć od tego, czy proces PHP pozostanie aktywny bez końca.
Lista kontrolna przed automatyzacją
- Czy określono źródło nadrzędne dla każdego pola oraz sposób obsługi wartości null i usunięć?
- Czy identyfikatory pozwalają jednoznacznie powiązać rekordy i czy istnieją zasady obsługi duplikatów?
- Czy przetestowano paginację, opóźnienia, limity API, ponowienia i równoczesne zmiany?
- Czy rozbieżności są klasyfikowane, a wyjątki trafiają do weryfikacji lub kwarantanny?
- Czy porównanie można uruchomić w trybie tylko do odczytu i wyświetlić proponowane działania?
- Czy zapisy są idempotentne, uzależnione od oczekiwanego stanu i ograniczone pod względem skali?
- Czy decyzje i wyniki są rejestrowane z odpowiednią ochroną danych i kontrolą dostępu?
- Czy przeprowadzono testy na reprezentatywnych danych, obejmujące konflikty, puste wartości, duplikaty i częściowe awarie?
Zacznij od obserwowania i klasyfikowania, a nie od wprowadzania korekt. Po zweryfikowaniu reguł na rzeczywistych danych i sprawdzeniu propozycji włącz automatyzację tylko dla rozbieżności o niskim ryzyku. Zachowaj możliwość wstrzymania procesu i regularnie analizuj fałszywe alarmy, nierozwiązane przypadki oraz zmiany w systemach zewnętrznych. Dzięki temu uzgadnianie stanie się powtarzalnym mechanizmem kontroli operacyjnej, zamiast synchronizacją, która ukrywa konflikty, dopóki ktoś nie zauważy ich skutków.


