
Une intégration peut répondre correctement tout en laissant des données différentes dans deux systèmes. Une requête peut expirer après que le système externe a enregistré la modification ; un événement peut arriver en retard ; ou une mise à jour locale peut modifier un champ également contrôlé par l’autre système. C’est pourquoi, en plus de synchroniser les événements, il est utile de pouvoir comparer les états et résoudre les écarts de manière délibérée.
La réconciliation des données entre systèmes en PHP est un processus périodique ou déclenché à la demande qui identifie les différences entre des enregistrements liés, détermine leur signification et propose ou applique une action. Il ne s’agit pas de copier aveuglément un système sur un autre. Pour éviter de perdre des informations valides, il faut définir l’autorité de chaque donnée, conserver les éléments attestant de la comparaison et protéger l’application contre les corrections répétées ou massives.
Définir le système faisant autorité avant de comparer
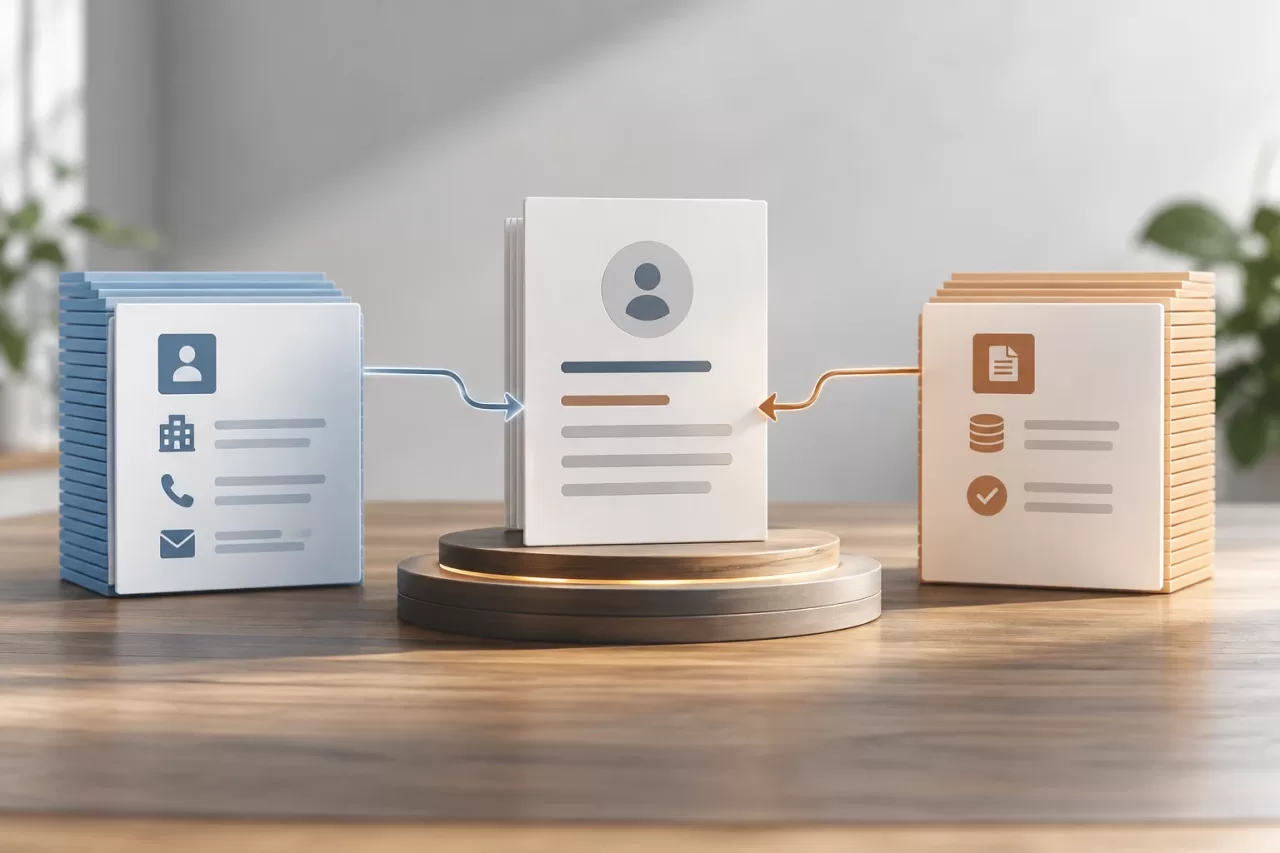
La source de vérité n’est pas toujours unique pour une entité entière. Le CRM peut être responsable du nom commercial et des coordonnées, tandis que le système de facturation contrôle le statut du paiement et l’identifiant fiscal validé. Si l’on désigne un système entier comme faisant autorité sans examiner les champs, la réconciliation risque de remplacer des informations correctes par une copie ancienne ou incomplète.
Documentez la propriété des champs échangés. Pour chacun d’eux, indiquez quel système peut être à l’origine des modifications, lequel doit prévaloir en cas de conflit, si la valeur peut être nulle et quelles transformations sont acceptables. Il convient également de distinguer les champs modifiables des champs dérivés : un total calculé, par exemple, devra peut-être être régénéré à partir de ses composants plutôt que copié.
- Autorité par champ : définissez qui décide de sa valeur et que faire si les deux systèmes présentent des modifications.
- Règles de combinaison : précisez s’il est possible de compléter une donnée manquante sans en remplacer une existante.
- Exceptions : indiquez les conflits qui nécessitent une approbation, une validation supplémentaire ou l’intervention de l’équipe responsable.
Lorsqu’aucune règle sûre n’existe, la bonne action consiste à signaler le conflit pour examen, et non à choisir arbitrairement l’enregistrement dont la date est la plus récente. Les horloges peuvent être désynchronisées et un horodatage ne prouve pas, à lui seul, qu’une modification est légitime.
Rendre la comparaison reproductible
Une comparaison utile doit identifier le même enregistrement des deux côtés. Utilisez un identifiant stable partagé ou une table de correspondance tenue à jour explicitement. Ne vous fiez pas uniquement aux noms, aux adresses e-mail ou à d’autres champs susceptibles de changer, d’être dupliqués ou d’être normalisés différemment. Si aucune correspondance univoque n’est trouvée, classez le cas comme étant en attente de rapprochement plutôt que de fusionner les enregistrements par approximation.
Comparez les valeurs normalisées selon des règles documentées : espaces, majuscules ou formats de date, par exemple. Conservez également la valeur d’origine, car normaliser pour comparer n’autorise pas à modifier la donnée persistée. Soyez attentif aux fuseaux horaires, à la précision décimale, aux valeurs vides et aux différences entre un champ absent et un champ présent dont la valeur est nulle. Traiter ces états comme équivalents peut masquer des modifications importantes.
Pour les grands ensembles de données, définissez une fenêtre de traitement et un point de reprise, comme une date de modification ou un curseur de pagination. N’enregistrez le point de progression que lorsque le lot a été traité de manière cohérente. Si le fournisseur ne propose pas de marqueurs fiables, une exploration complète moins fréquente ou une combinaison d’échantillonnage et de réconciliation ciblée peut être plus sûre que de prétendre à un traitement incrémental que l’API ne garantit pas. La stratégie dépend des limites, de la stabilité et des garanties réelles de chaque système.
En PHP, séparez la récupération des données de la comparaison et de la persistance des résultats. Par exemple, une fonction de comparaison peut recevoir deux représentations normalisées et renvoyer une liste de différences typées, sans effectuer d’appels distants ni mettre à jour d’enregistrements. Cette séparation permet de tester les règles avec des cas contrôlés et d’examiner les propositions avant d’autoriser les écritures.
Classer les écarts et décider de la réponse
Toutes les différences ne signalent pas une erreur, et chaque catégorie requiert une politique distincte. Une classification explicite améliore le diagnostic et évite qu’une règle unique et destructrice s’applique à des situations différentes.
- Manquant : l’enregistrement existe dans un système, mais pas dans l’autre. Vérifiez s’il s’agit d’une création récente, d’une suppression légitime, d’un filtre ou d’un échec de pagination.
- Doublon : plusieurs enregistrements semblent correspondre à une même entité. N’en choisissez pas un automatiquement sans règle d’identification vérifiable.
- Modification incompatible : les deux côtés ont modifié un champ contrôlé par les deux systèmes. Appliquez une politique de propriété ou soumettez le conflit à examen.
- Donnée invalide : la valeur ne respecte pas le format ou les contraintes attendus. Mettez-la en quarantaine et évitez de la propager.
- Décalage temporel : la différence peut être due à un retard de livraison ou de traitement. Effectuez une nouvelle tentative ou attendez pendant une période définie avant de déclarer un conflit persistant.
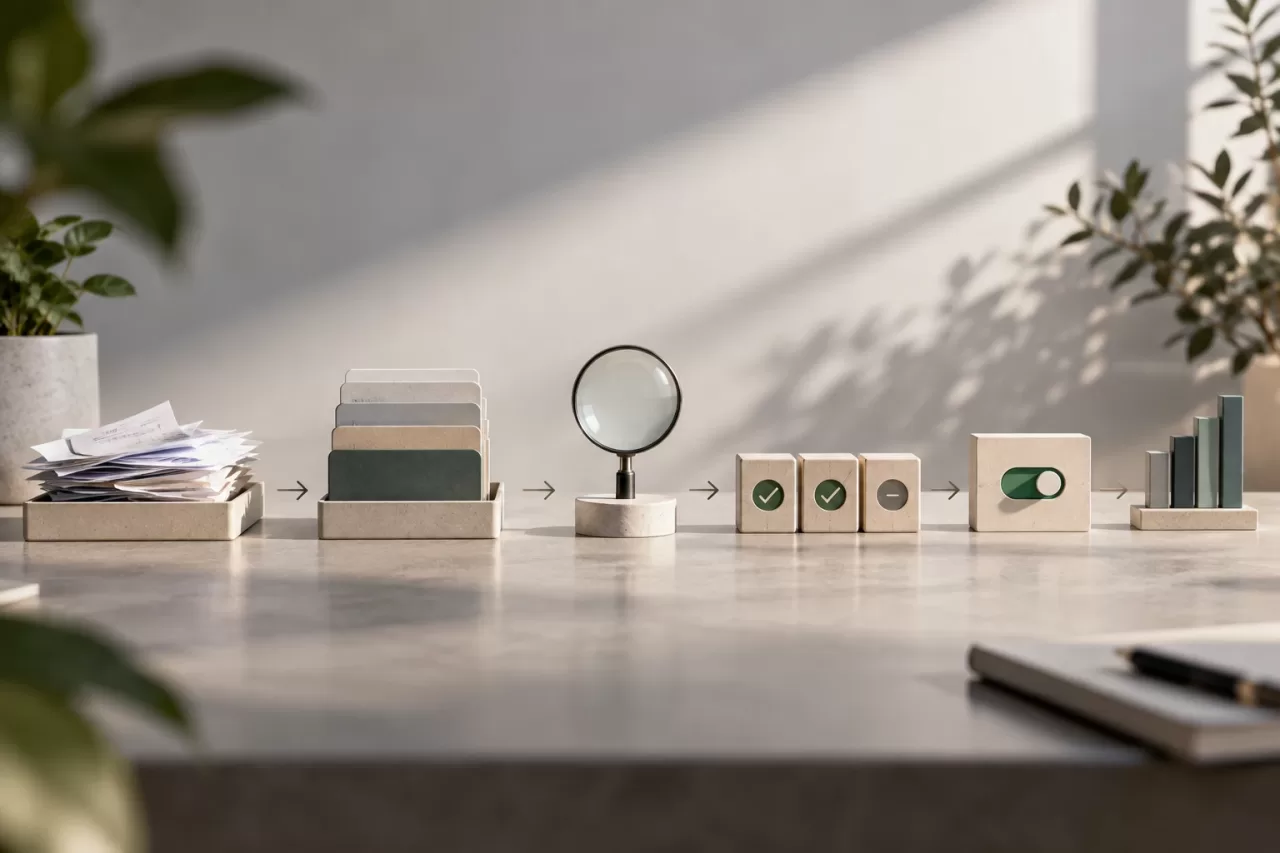
Distinguez trois étapes : la détection de la différence, la décision concernant l’action et l’application de la modification. Une proposition peut consister à mettre à jour un champ, à créer une association, à demander un examen ou à ne rien faire. En séparant ces étapes, on peut commencer en lecture seule et comprendre ce qui aurait changé avant d’activer les corrections automatiques.
Appliquer les modifications sans créer de nouveaux problèmes
Automatisez uniquement les cas couverts par des règles claires et vérifiables. Pour les autres, proposez une file d’examen indiquant l’identifiant de l’entité, les valeurs observées, la règle qui serait appliquée et l’action proposée. L’interface ou le processus opérationnel doit permettre d’accepter, de rejeter ou de faire remonter la proposition, et consigner qui a pris la décision, le cas échéant.
Concevez les opérations de manière à les rendre idempotentes : le retraitement du même écart ne doit ni créer de doublons ni faire alterner indéfiniment les valeurs. Avant d’écrire, vérifiez que l’enregistrement est toujours dans l’état attendu. S’il a changé depuis sa lecture, interrompez la mise à jour et relancez la comparaison. Lorsque l’API externe le permet, utilisez des versions, des conditions d’écriture ou des clés d’idempotence ; ne partez pas du principe que ces mécanismes existent sans l’avoir vérifié.
Limitez la portée au moyen de petits lots, de limites de modifications par exécution et d’options de pause. Une correction qui dépasse le volume prévu doit être interrompue ou nécessiter une autorisation, et non se poursuivre silencieusement. Pour les modifications à fort impact, consignez une éventuelle opération compensatoire, sans la présenter comme une garantie de retour arrière : des modifications ultérieures ou des effets externes peuvent empêcher toute annulation.
Consigner chaque exécution pour enquêter et la répéter
Enregistrez un identifiant d’exécution, ses heures de début et de fin, la plage ou le curseur traité, les systèmes interrogés, le résultat par catégorie et les erreurs. Pour chaque écart, conservez la clé de corrélation, les valeurs pertinentes ou une représentation protégée, la règle évaluée, l’action proposée et le résultat de son application. Cela permet d’expliquer pourquoi une décision a été prise et de distinguer un échec d’intégration d’un conflit réel.
Protégez les journaux : ils peuvent contenir des données personnelles, des identifiants indirects ou des données commerciales. Évitez d’enregistrer des charges utiles complètes lorsque quelques champs précis suffisent, limitez les accès et définissez une durée de conservation. Incluez des références aux enregistrements sources et l’heure d’observation afin de faciliter les enquêtes sans transformer le journal en une seconde base de données non contrôlée.
Ne relancez que les erreurs transitoires, avec des limites et un délai d’attente progressif. Consignez les nouvelles tentatives et séparez les erreurs permanentes — comme les données invalides ou les permissions insuffisantes — afin d’éviter les cycles qui répètent le même problème. Une exécution doit pouvoir reprendre selon un critère connu, sans dépendre du maintien indéfini du processus PHP en activité.
Liste de contrôle avant l’automatisation
- L’autorité est-elle définie pour chaque champ, ainsi que le traitement des valeurs nulles et des suppressions ?
- Les identifiants relient-ils les enregistrements sans ambiguïté, et les doublons sont-ils pris en charge ?
- La pagination, les retards, les limites d’API, les nouvelles tentatives et les modifications concurrentes ont-ils été testés ?
- Les différences sont-elles classées et les exceptions envoyées en examen ou en quarantaine ?
- La comparaison peut-elle s’exécuter en lecture seule et afficher les actions proposées ?
- Les écritures sont-elles idempotentes, conditionnées à l’état attendu et limitées en volume ?
- Les décisions et les résultats sont-ils consignés avec des protections des données et des contrôles d’accès appropriés ?
- Des tests ont-ils été effectués avec des données représentatives, y compris des conflits, des valeurs vides, des doublons et des défaillances partielles ?
Commencez par observer et classer, sans corriger. Après avoir validé les règles à partir de données réelles et examiné les propositions, n’activez l’automatisation que pour les écarts à faible risque. Maintenez un moyen de mettre le processus en pause et examinez régulièrement les faux positifs, les cas non résolus et les modifications apportées aux systèmes externes. La réconciliation devient ainsi un contrôle opérationnel reproductible, plutôt qu’une synchronisation qui masque les conflits jusqu’à ce que quelqu’un en constate les conséquences.


