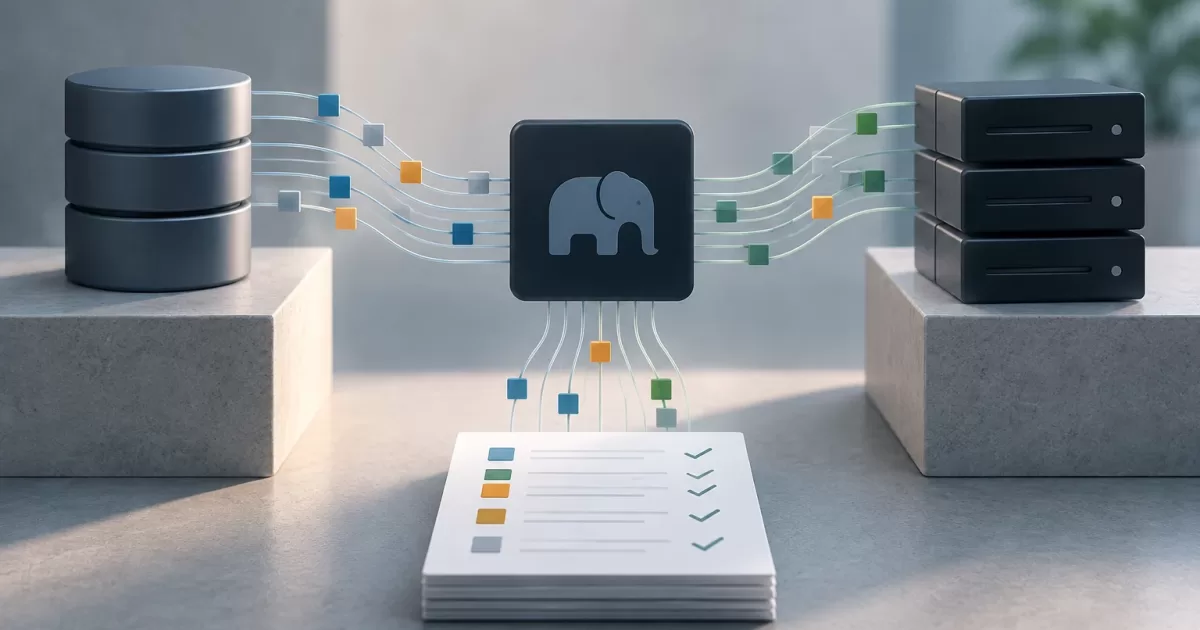
Intégrer une fonction d’IA dans une application PHP ne signifie pas que toutes les informations disponibles doivent quitter l’application. Un résumé, une classification ou une réponse contextuelle ne nécessitent souvent qu’une partie des données dont le système dispose au sujet d’une personne ou d’un processus. La décision doit partir de la tâche concrète et être vérifiée dans le flux réel, et pas seulement dans l’interface où le modèle est appelé.
La minimisation des données dans les intégrations d’IA avec PHP consiste à envoyer uniquement les informations nécessaires à une finalité définie, pendant la durée et par les canaux requis par cette finalité. Elle n’élimine pas à elle seule les risques pour la confidentialité : il faut également contrôler les journaux, les erreurs, les réponses, les autorisations et les dépendances externes.
Suivez le parcours des données avant de modifier le code
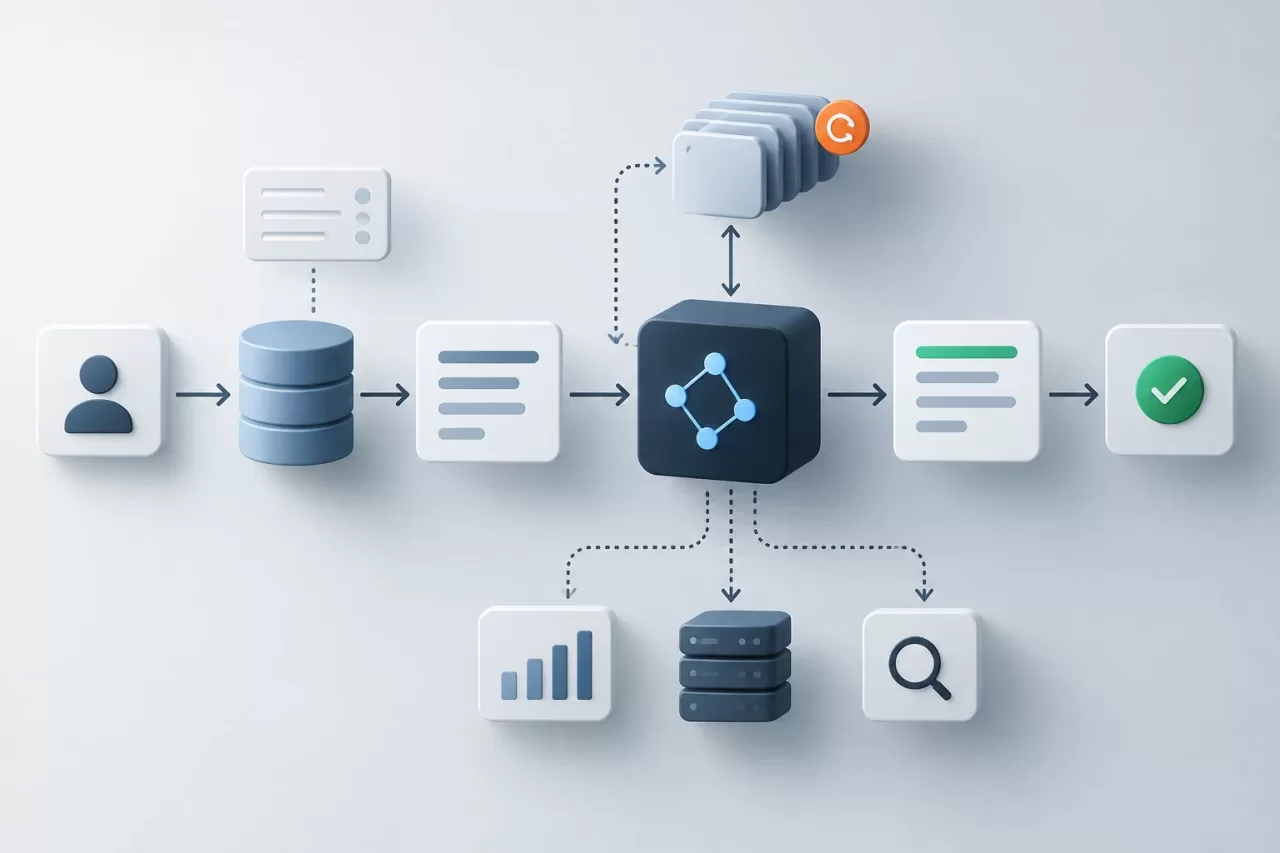
Documentez les données qui entrent dans la fonction et ce qui se passe ensuite. Un parcours courant comprend la saisie de l’utilisateur, le chargement du contexte depuis la base de données, la préparation du message, la requête au fournisseur ou au service d’IA, la réponse et les journaux internes. Vérifiez également si des files d’attente, des nouvelles tentatives, des outils d’observabilité ou d’assistance copient le contenu.
Pour chaque étape, identifiez le responsable, la destination, la finalité et la durée de conservation. En PHP, il convient de repérer à la fois le code qui construit la requête et les points où les exceptions sont journalisées et les résultats persistés. Examiner uniquement l’appel HTTP ne permet pas de détecter d’éventuelles copies dans les traces, les outils de débogage ou les tâches asynchrones.
- Quels champs sont récupérés et lesquels se retrouvent réellement dans la requête ?
- La requête inclut-elle le contexte des conversations précédentes ou des pièces jointes ?
- Que journalise-t-on si la connexion échoue, si le délai d’attente est dépassé ou si la réponse est invalide ?
- La réponse complète est-elle stockée alors qu’il suffirait de conserver le résultat nécessaire ?
Définissez une liste d’autorisation pour chaque cas d’usage
Classez les champs selon leur nécessité pour la tâche, et non selon la facilité avec laquelle il est possible de les obtenir. Une classification utile distingue les données indispensables, celles qui ne sont utiles que dans certains cas et celles qui ne doivent pas être envoyées. Par exemple, une fonction qui catégorise un message peut avoir besoin de son texte et d’une liste limitée de catégories, mais pas nécessairement du nom, de l’adresse e-mail, de l’adresse postale ou de l’historique complet de son auteur.
Traduisez cette décision en une liste d’autorisation propre à chaque fonction. Évitez de sérialiser une entité complète ou de transmettre directement un objet de domaine à la couche d’IA : ces objets peuvent contenir des champs sensibles aujourd’hui ou en acquérir plus tard. Construisez un objet de transfert explicite avec les valeurs approuvées et validez sa structure avant de créer la requête.
$input = [
    'message' => $ticket->publicMessage(),
    'allowed_categories' => $categoryNames,
];

$payload = $validator->validate($input);
La validation doit appliquer des limites de taille et de format, et vérifier qu’aucun champ ne figure en dehors de la liste. Distinguez l’autorisation de lire des informations dans l’application de la décision de les inclure dans la requête : le fait qu’un processus PHP puisse accéder à une donnée ne signifie pas que la fonction d’IA en a besoin.
Réduisez les identifiants sans vous fier uniquement à la pseudonymisation
Lorsqu’une tâche nécessite de distinguer des enregistrements sans connaître l’identité réelle, il peut être possible de remplacer les identifiants directs par des références internes ou des pseudonymes. Conservez dans l’application, en dehors du contenu envoyé et avec un accès limité, la table qui associe la référence à la personne. N’envoyez pas de clés permettant de reconstituer l’identité si elles ne sont pas indispensables.
La pseudonymisation n’équivaut pas à l’anonymisation. Un texte libre peut révéler une identité par des noms, des fonctions, des lieux, des dates, des détails sur un incident ou une combinaison d’attributs. Il peut également permettre une réidentification lorsqu’il est recoupé avec d’autres données. Examinez le contenu et le contexte, et pas seulement les champs structurés ; le cas échéant, masquez ou généralisez certains détails avant de les envoyer.
Si la suppression d’une donnée modifie la qualité de la réponse, essayez des solutions moins identifiantes : des plages plutôt que des valeurs exactes, des catégories plutôt que des descriptions personnelles, ou un résumé préparé par l’application. Conservez en PHP les informations nécessaires pour associer la réponse au bon enregistrement, sauf si la tâche exige autre chose.
Gardez sous le contrôle de PHP les informations dont le modèle n’a pas besoin
Séparez la préparation du contexte de la logique métier. PHP peut appliquer les autorisations, résoudre les relations, sélectionner les champs et combiner la sortie de l’IA avec des données qui n’ont jamais été envoyées. La fonction peut renvoyer une étiquette ou une suggestion ; l’application reste responsable de vérifier la validité du résultat et de décider si une action doit être exécutée.
Définissez des limites pour les réponses : format attendu, longueur, valeurs autorisées et traitement du contenu inattendu. Si la sortie est affichée aux utilisateurs, échappez-la selon le contexte de présentation et ne la traitez pas comme une instruction fiable. Si elle peut déclencher une opération — par exemple, modifier un enregistrement — exigez une validation supplémentaire et, selon l’impact, une confirmation humaine.
Les défaillances font également partie de la conception. Déterminez quoi faire en cas de délai d’attente dépassé, d’erreur du fournisseur, de réponse vide ou de format impossible à interpréter. Selon le cas, une solution de repli peut consister à demander à l’utilisateur de réessayer, à proposer une opération manuelle ou à poursuivre sans la fonction. Évitez les nouvelles tentatives illimitées et ne renvoyez pas à l’utilisateur de détails internes contenant des requêtes, des identifiants d’accès ou des données personnelles.
Évitez que les journaux ne deviennent une deuxième copie
Journalisez des indicateurs opérationnels utiles — identifiant de corrélation, durée, état et code d’erreur — sans enregistrer automatiquement l’intégralité du prompt et de la réponse. S’il est nécessaire de conserver du contenu pour analyser un problème, définissez la finalité, les accès et la durée de conservation, et envisagez une vue expurgée ou un environnement de test avec des données synthétiques.
Examinez les messages d’exception, les outils de supervision, les files d’attente et les journaux d’audit. Par défaut, une erreur ne devrait pas reproduire la requête complète. Le même principe s’applique au débogage temporaire : limitez son activation, évitez les données réelles dans la mesure du possible et vérifiez qu’il ne reste pas activé en production.
Vérifiez l’utilité et les limites au moyen de tests représentatifs
Avant d’activer le flux, créez des cas représentant les entrées courantes, les cas limites et les défaillances, sans utiliser de données personnelles réelles sauf si cela est justifié et assorti de contrôles appropriés. Comparez la fonction avec l’ensemble de champs prévu et avec une version réduite. Évaluez si elle accomplit la tâche, si elle invente des informations ou classe mal les données, et si une réponse incorrecte peut causer un préjudice.
Ajoutez des tests automatisés pour vérifier que les champs exclus n’apparaissent pas dans le payload, que les entrées volumineuses sont limitées, que les données expurgées ne sont pas ajoutées aux journaux et que les réponses dans un format inattendu sont rejetées ou gérées de manière sûre. Répétez ces vérifications lorsque le schéma de données, le prompt, le fournisseur ou la logique de préparation change.
Liste de vérification avant d’activer la fonction
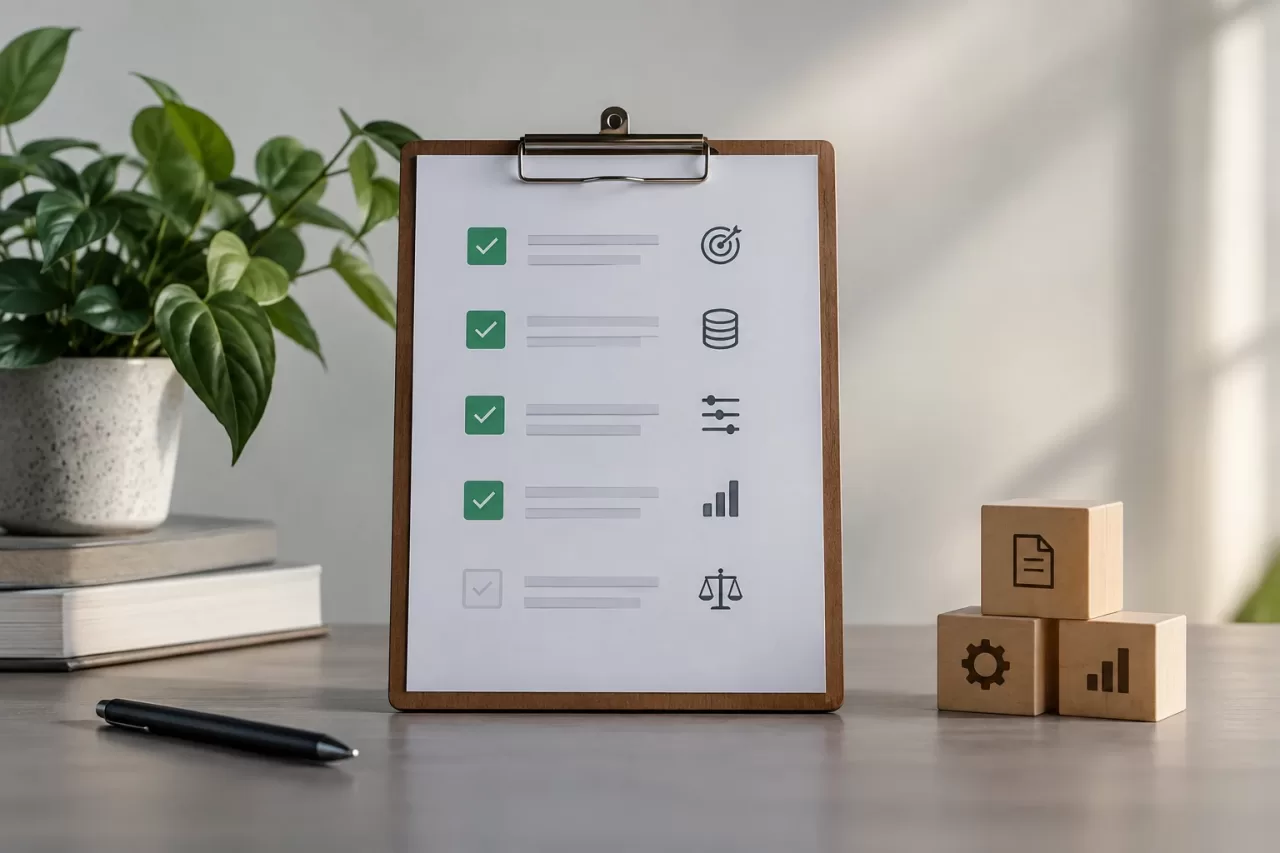
- La finalité est définie et chaque champ envoyé répond à une raison précise.
- Le payload est construit à partir d’une liste d’autorisation, et non d’une entité complète.
- Les identifiants et les textes libres sont examinés au regard des risques de réidentification.
- L’application conserve les autorisations, les règles métier et les données dont l’IA n’a pas besoin.
- Les requêtes, les réponses et les erreurs ne sont pas copiées sans contrôle dans les journaux ou les traces.
- Des limites d’entrée, une validation de sortie et une solution de repli en cas de défaillance sont prévues.
- Les tests vérifient à la fois l’utilité et l’absence des champs exclus.
- L’équipe sait quels changements du flux nécessitent de réexaminer l’évaluation.
La bonne décision ne consiste ni à envoyer toujours plus de contexte, ni à supprimer des données à l’aveugle. Il s’agit de justifier chaque champ au regard de la tâche, de garder le contrôle dans PHP et de vérifier que la réduction préserve une utilité acceptable sans accroître inutilement l’exposition.