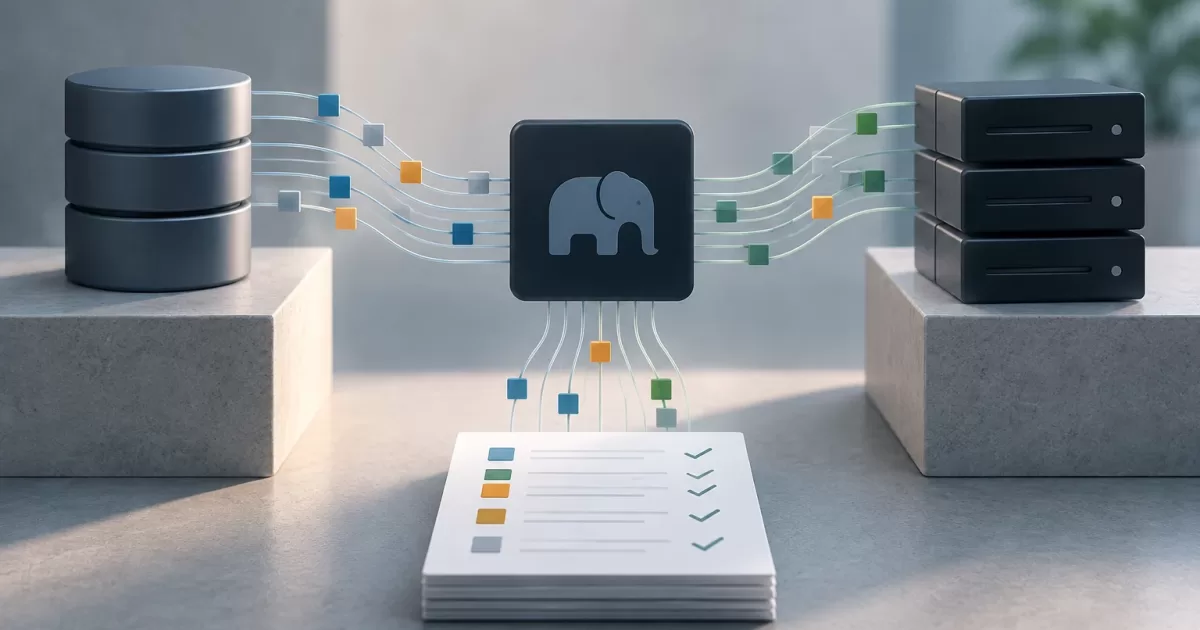
Integrar una función de IA en una aplicación PHP no implica que toda la información disponible deba salir de la aplicación. Un resumen, una clasificación o una respuesta contextual suelen requerir solo una parte de los datos que el sistema tiene sobre una persona o un proceso. La decisión debe partir de la tarea concreta y verificarse en el flujo real, no solo en la interfaz donde se invoca el modelo.
La minimización de datos en integraciones de IA con PHP consiste en enviar únicamente la información necesaria para un propósito definido, durante el tiempo y por los canales que ese propósito requiera. No elimina por sí sola los riesgos de privacidad: también hay que controlar registros, errores, respuestas, permisos y dependencias externas.
Traza el recorrido de los datos antes de cambiar el código
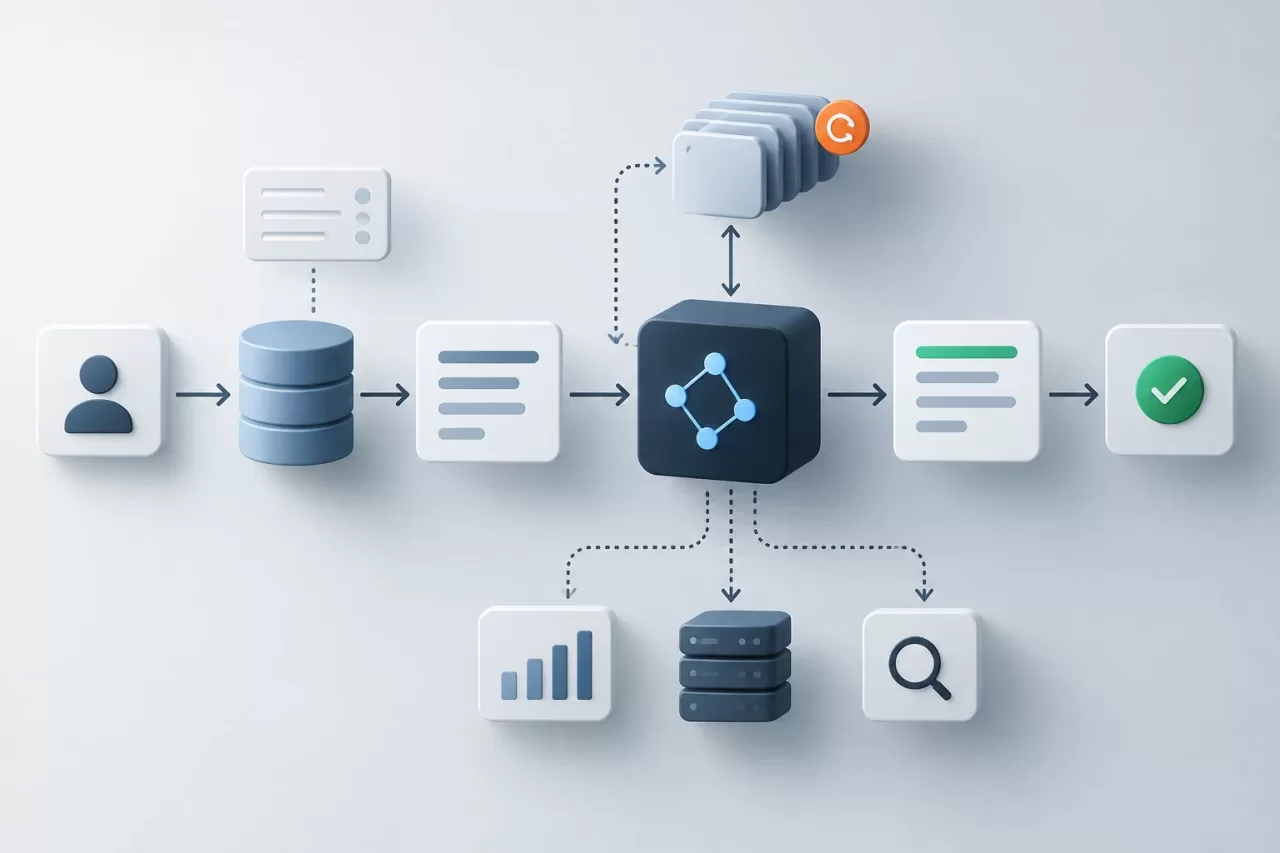
Documenta qué dato entra en la función y qué ocurre después. Un recorrido habitual incluye la entrada del usuario, la carga de contexto desde la base de datos, la preparación del mensaje, la solicitud al proveedor o servicio de IA, la respuesta y los registros internos. Comprueba además si hay colas, reintentos, observabilidad o herramientas de soporte que copien el contenido.
Para cada etapa, identifica el responsable, el destino, el propósito y el tiempo de conservación. En PHP conviene localizar tanto el código que construye la solicitud como los puntos donde se registran excepciones y se persisten resultados. Revisar solo la llamada HTTP deja fuera posibles copias en trazas, depuración o tareas asíncronas.
- ¿Qué campos se consultan y cuáles terminan realmente en la solicitud?
- ¿La petición incluye contexto de conversaciones anteriores o datos adjuntos?
- ¿Qué se registra si la conexión falla, se agota el tiempo o la respuesta es inválida?
- ¿Se almacena la respuesta completa cuando bastaría con guardar el resultado necesario?
Define una lista permitida para cada caso de uso
Clasifica los campos según su necesidad para la tarea, no según lo fácil que resulte obtenerlos. Una clasificación útil separa datos imprescindibles, datos que solo ayudan en casos concretos y datos que no deben enviarse. Por ejemplo, una función que categoriza un mensaje podría necesitar su texto y una lista limitada de categorías, pero no necesariamente el nombre, correo, dirección o historial completo de quien lo escribió.
Convierte esa decisión en una lista permitida específica para cada función. Evita serializar una entidad completa o pasar directamente un objeto de dominio a la capa de IA: esos objetos pueden incorporar campos sensibles hoy o adquirirlos más adelante. Construye un objeto de transferencia explícito con los valores aprobados y valida su estructura antes de crear la solicitud.
$input = [
    'message' => $ticket->publicMessage(),
    'allowed_categories' => $categoryNames,
];

$payload = $validator->validate($input);
La validación debe aplicar límites de tamaño y formato, además de comprobar que no aparezcan campos fuera de la lista. Mantén separadas la autorización para leer información en la aplicación y la decisión de incluirla en la solicitud: que un proceso PHP pueda acceder a un dato no significa que la función de IA lo necesite.
Reduce identificadores sin confiar solo en la seudonimización
Cuando una tarea necesita distinguir registros, pero no conocer la identidad real, puede ser viable sustituir identificadores directos por referencias internas o seudónimos. Mantén la tabla que relaciona la referencia con la persona dentro de la aplicación y fuera del contenido enviado, con acceso limitado. No envíes claves que permitan reconstruir la identidad si no son imprescindibles.
La seudonimización no equivale a anonimización. Un texto libre puede revelar una identidad mediante nombres, cargos, ubicaciones, fechas, detalles de un incidente o una combinación de atributos. También puede ser reidentificable al cruzarse con otros datos. Revisa el contenido y el contexto, no solo los campos estructurados; cuando corresponda, redacta o generaliza detalles antes de enviarlos.
Si quitar un dato cambia la calidad de la respuesta, prueba alternativas menos identificativas: rangos en vez de valores exactos, categorías en vez de descripciones personales, o un resumen preparado por la aplicación. Conserva en PHP la información necesaria para vincular la respuesta con el registro correcto, salvo que la tarea requiera otra cosa.
Mantén bajo control de PHP la información que no necesita el modelo
Separa la preparación del contexto de la lógica de negocio. PHP puede aplicar permisos, resolver relaciones, seleccionar campos y combinar la salida de IA con datos que nunca se enviaron. La función puede devolver una etiqueta o una sugerencia; la aplicación sigue siendo responsable de comprobar que el resultado es válido y de decidir si ejecuta una acción.
Define límites para las respuestas: formato esperado, longitud, valores permitidos y tratamiento de contenido inesperado. Si la salida se muestra a usuarios, escápala según el contexto de presentación y no la trates como una instrucción confiable. Si puede provocar una operación —por ejemplo, modificar un registro— exige validación adicional y, según el impacto, confirmación humana.
Los fallos también forman parte del diseño. Establece qué hacer ante un timeout, un error del proveedor, una respuesta vacía o un formato que no se puede interpretar. Una alternativa puede ser pedir al usuario que reintente, ofrecer una operación manual o continuar sin la función, según el caso. Evita reintentos ilimitados y no devuelvas al usuario detalles internos que contengan solicitudes, credenciales o datos personales.
Evita que los registros se conviertan en una segunda copia
Registra señales operativas útiles —identificador de correlación, duración, estado y código de error— sin guardar automáticamente el prompt y la respuesta completos. Si hace falta conservar contenido para investigar un problema, define finalidad, acceso y plazo de retención, y considera una vista redactada o un entorno de prueba con datos sintéticos.
Revisa mensajes de excepción, herramientas de monitorización, colas y registros de auditoría. Un error no debería reproducir la solicitud completa por defecto. El mismo principio se aplica a depuración temporal: restringe su activación, evita datos reales cuando sea posible y verifica que no permanezca habilitada en producción.
Comprueba utilidad y límites con pruebas representativas
Antes de habilitar el flujo, crea casos que representen entradas habituales, límites y fallos, sin usar información personal real salvo que exista una justificación y controles adecuados. Compara la función con el conjunto de campos previsto y con una versión reducida. Evalúa si cumple la tarea, si inventa o clasifica mal y si una respuesta incorrecta puede causar un perjuicio.
Añade pruebas automatizadas para comprobar que los campos excluidos no aparecen en el payload, que las entradas grandes se limitan, que los datos redactados no llegan a los registros y que las respuestas fuera de formato se rechazan o gestionan de forma segura. Repite estas comprobaciones cuando cambien el esquema de datos, el prompt, el proveedor o la lógica de preparación.
Lista de comprobación antes de habilitar la función
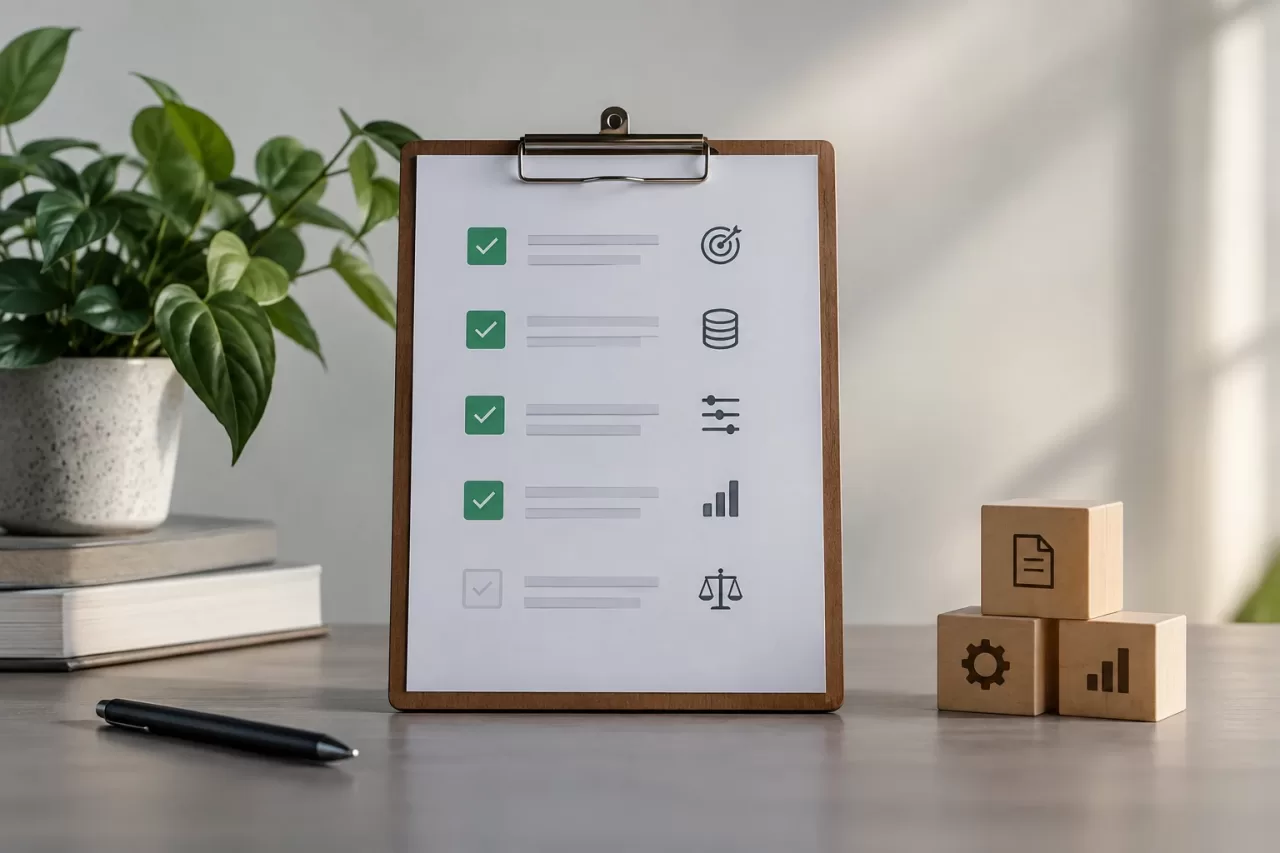
- El propósito está definido y cada campo enviado tiene una razón concreta.
- El payload se construye desde una lista permitida, no desde una entidad completa.
- Los identificadores y textos libres se revisan por riesgos de reidentificación.
- La aplicación conserva permisos, reglas de negocio y datos que la IA no necesita.
- Solicitudes, respuestas y errores no se copian sin control a registros o trazas.
- Hay límites de entrada, validación de salida y una alternativa ante fallos.
- Las pruebas comprueban tanto la utilidad como la ausencia de campos excluidos.
- El equipo sabe qué cambios del flujo requieren revisar de nuevo la evaluación.
La decisión correcta no es enviar cuanto más contexto mejor ni eliminar datos a ciegas. Es justificar cada campo frente a la tarea, mantener el control en PHP y probar que la reducción conserva una utilidad aceptable sin ampliar la exposición innecesariamente.