Die Integration einer KI-Funktion in eine PHP-Anwendung bedeutet nicht, dass alle verfügbaren Informationen die Anwendung verlassen müssen. Für eine Zusammenfassung, Klassifizierung oder kontextbezogene Antwort ist oft nur ein Teil der Daten erforderlich, die das System zu einer Person oder einem Vorgang vorhält. Die Entscheidung sollte von der konkreten Aufgabe ausgehen und im tatsächlichen Ablauf überprüft werden – nicht nur an der Oberfläche, über die das Modell aufgerufen wird.
Datenminimierung bei KI-Integrationen mit PHP bedeutet, nur die Informationen zu einem festgelegten Zweck zu übermitteln, die dafür erforderlich sind, und zwar nur so lange und über die Kanäle, die dieser Zweck verlangt. Sie beseitigt Datenschutzrisiken nicht von selbst: Auch Protokolle, Fehler, Antworten, Berechtigungen und externe Abhängigkeiten müssen kontrolliert werden.
Verfolgen Sie den Datenfluss, bevor Sie den Code ändern
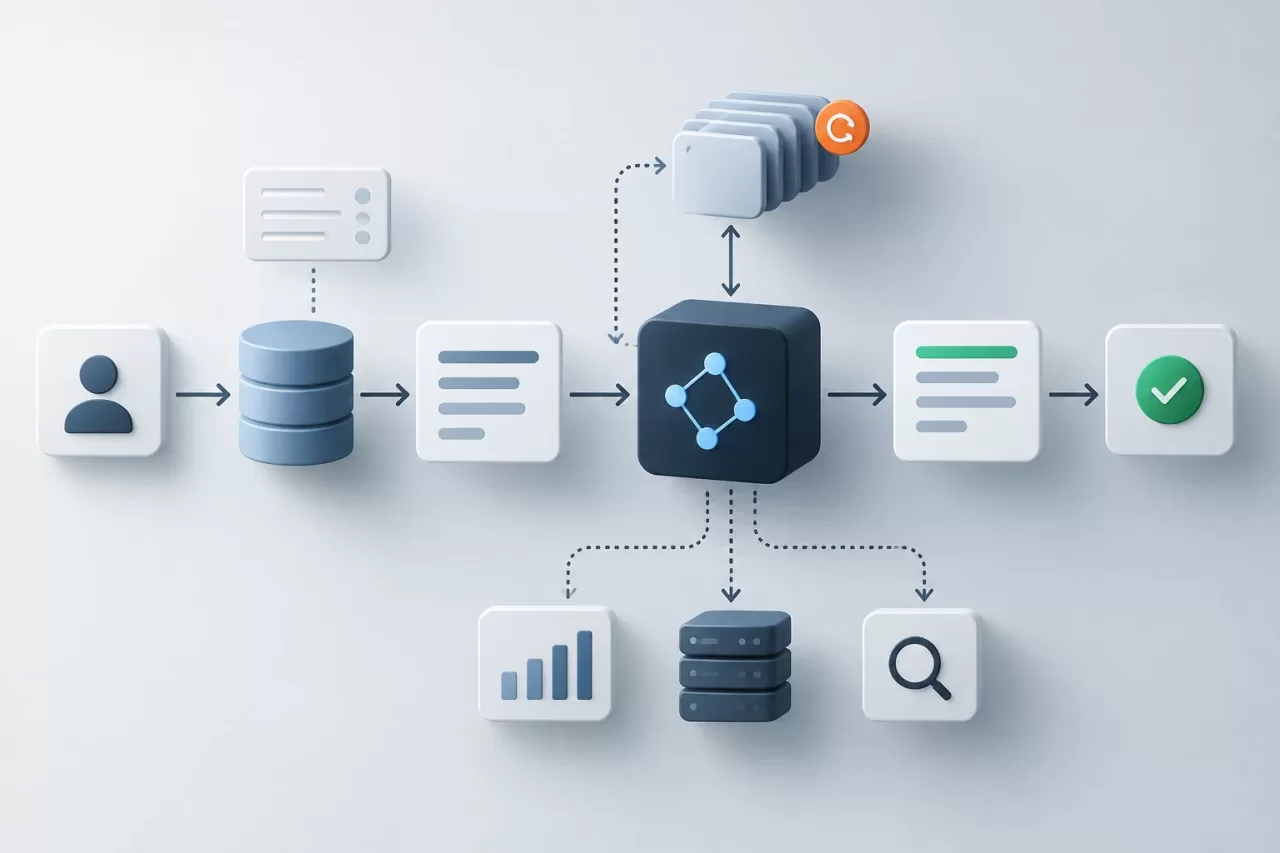
Dokumentieren Sie, welche Daten in die Funktion eingehen und was anschließend mit ihnen geschieht. Ein typischer Ablauf umfasst die Benutzereingabe, das Laden von Kontext aus der Datenbank, die Vorbereitung der Nachricht, die Anfrage an den KI-Anbieter oder -Dienst, die Antwort und interne Protokolle. Prüfen Sie außerdem, ob Warteschlangen, Wiederholungsversuche, Observability oder Support-Tools den Inhalt kopieren.
Ermitteln Sie für jede Phase die verantwortliche Stelle, das Ziel, den Zweck und die Aufbewahrungsdauer. In PHP sollten Sie sowohl den Code finden, der die Anfrage erstellt, als auch die Stellen, an denen Ausnahmen protokolliert und Ergebnisse gespeichert werden. Wer nur den HTTP-Aufruf prüft, übersieht mögliche Kopien in Traces, Debug-Ausgaben oder asynchronen Aufgaben.
- Welche Felder werden abgefragt und welche davon landen tatsächlich in der Anfrage?
- Enthält die Anfrage Kontext aus früheren Unterhaltungen oder angehängte Daten?
- Was wird protokolliert, wenn die Verbindung fehlschlägt, eine Zeitüberschreitung auftritt oder die Antwort ungültig ist?
- Wird die vollständige Antwort gespeichert, obwohl es ausreichen würde, das benötigte Ergebnis aufzubewahren?
Legen Sie für jeden Anwendungsfall eine Positivliste fest
Klassifizieren Sie Felder danach, ob sie für die Aufgabe erforderlich sind, und nicht danach, wie einfach sie sich abrufen lassen. Eine nützliche Einteilung unterscheidet zwischen unbedingt erforderlichen Daten, Daten, die nur in bestimmten Fällen helfen, und Daten, die nicht übermittelt werden dürfen. Eine Funktion, die eine Nachricht kategorisiert, könnte beispielsweise deren Text und eine begrenzte Liste von Kategorien benötigen, aber nicht unbedingt den Namen, die E-Mail-Adresse, die Anschrift oder den vollständigen Verlauf der Person, die sie verfasst hat.
Setzen Sie diese Entscheidung für jede Funktion in eine eigene Positivliste um. Vermeiden Sie es, eine vollständige Entität zu serialisieren oder ein Domänenobjekt direkt an die KI-Schicht zu übergeben: Solche Objekte können heute sensible Felder enthalten oder später um solche ergänzt werden. Erstellen Sie ein explizites Transferobjekt mit den freigegebenen Werten und validieren Sie dessen Struktur, bevor Sie die Anfrage erzeugen.
$input = [
    'message' => $ticket->publicMessage(),
    'allowed_categories' => $categoryNames,
];

$payload = $validator->validate($input);
Die Validierung sollte neben Format- und Größenbeschränkungen auch sicherstellen, dass keine Felder außerhalb der Positivliste vorkommen. Halten Sie die Berechtigung, Informationen in der Anwendung zu lesen, von der Entscheidung getrennt, diese in die Anfrage aufzunehmen: Nur weil ein PHP-Prozess auf Daten zugreifen kann, heißt das nicht, dass die KI-Funktion sie benötigt.
Reduzieren Sie Identifikatoren, ohne sich allein auf Pseudonymisierung zu verlassen
Wenn eine Aufgabe Datensätze unterscheiden muss, aber die tatsächliche Identität nicht benötigt, kann es sinnvoll sein, direkte Identifikatoren durch interne Referenzen oder Pseudonyme zu ersetzen. Bewahren Sie die Tabelle, die eine Referenz einer Person zuordnet, innerhalb der Anwendung und außerhalb der übermittelten Inhalte auf und beschränken Sie den Zugriff darauf. Übermitteln Sie keine Schlüssel, mit denen sich die Identität rekonstruieren lässt, sofern sie nicht unbedingt erforderlich sind.
Pseudonymisierung ist nicht gleich Anonymisierung. Freitext kann durch Namen, Funktionen, Orte, Daten, Vorfalldetails oder eine Kombination von Merkmalen eine Identität preisgeben. Eine Reidentifizierung kann auch durch den Abgleich mit anderen Daten möglich sein. Prüfen Sie daher den Inhalt und den Kontext, nicht nur strukturierte Felder; falls erforderlich, schwärzen oder verallgemeinern Sie Details vor der Übermittlung.
Falls das Entfernen einer Angabe die Qualität der Antwort beeinträchtigt, testen Sie weniger identifizierende Alternativen: Wertebereiche statt exakter Werte, Kategorien statt personenbezogener Beschreibungen oder eine von der Anwendung erstellte Zusammenfassung. Bewahren Sie in PHP die Informationen auf, die erforderlich sind, um die Antwort dem richtigen Datensatz zuzuordnen, sofern die Aufgabe nichts anderes erfordert.
Behalten Sie Informationen, die das Modell nicht benötigt, unter der Kontrolle von PHP
Trennen Sie die Vorbereitung des Kontexts von der Geschäftslogik. PHP kann Berechtigungen anwenden, Beziehungen auflösen, Felder auswählen und die KI-Ausgabe mit Daten kombinieren, die nie übermittelt wurden. Die Funktion kann ein Label oder einen Vorschlag zurückgeben; die Anwendung bleibt dafür verantwortlich, das Ergebnis zu prüfen und über die Ausführung einer Aktion zu entscheiden.
Legen Sie Grenzen für Antworten fest: erwartetes Format, Länge, zulässige Werte und den Umgang mit unerwarteten Inhalten. Wenn die Ausgabe Benutzern angezeigt wird, escapen Sie sie entsprechend dem Ausgabekontext und behandeln Sie sie nicht als vertrauenswürdige Anweisung. Kann sie einen Vorgang auslösen – zum Beispiel einen Datensatz ändern –, ist eine zusätzliche Validierung und je nach Auswirkung eine menschliche Bestätigung erforderlich.
Auch Fehler gehören zum Design. Legen Sie fest, was bei einer Zeitüberschreitung, einem Anbieterfehler, einer leeren Antwort oder einem nicht interpretierbaren Format geschieht. Je nach Fall kann eine Alternative darin bestehen, den Benutzer um einen erneuten Versuch zu bitten, einen manuellen Vorgang anzubieten oder ohne die Funktion fortzufahren. Vermeiden Sie unbegrenzte Wiederholungsversuche und geben Sie Benutzern keine internen Details zurück, die Anfragen, Zugangsdaten oder personenbezogene Daten enthalten.
Verhindern Sie, dass Protokolle zu einer zweiten Kopie werden
Protokollieren Sie nützliche Betriebsinformationen – Korrelations-ID, Dauer, Status und Fehlercode –, ohne automatisch den vollständigen Prompt und die vollständige Antwort zu speichern. Falls Inhalte zur Untersuchung eines Problems aufbewahrt werden müssen, legen Sie Zweck, Zugriff und Aufbewahrungsfrist fest und erwägen Sie eine geschwärzte Ansicht oder eine Testumgebung mit synthetischen Daten.
Prüfen Sie Ausnahmemeldungen, Überwachungstools, Warteschlangen und Audit-Protokolle. Ein Fehler sollte die vollständige Anfrage nicht standardmäßig wiedergeben. Dasselbe gilt für die vorübergehende Fehlerbehebung: Beschränken Sie deren Aktivierung, vermeiden Sie nach Möglichkeit echte Daten und stellen Sie sicher, dass sie in der Produktionsumgebung nicht aktiviert bleibt.
Prüfen Sie Nutzen und Grenzen anhand repräsentativer Tests
Erstellen Sie vor der Aktivierung des Ablaufs Testfälle für typische Eingaben, Grenzfälle und Fehler, ohne echte personenbezogene Daten zu verwenden, es sei denn, dies ist begründet und durch geeignete Kontrollen abgesichert. Vergleichen Sie die Funktion mit dem vorgesehenen Feldsatz und mit einer reduzierten Version. Bewerten Sie, ob sie die Aufgabe erfüllt, Dinge erfindet oder falsch klassifiziert und ob eine falsche Antwort Schaden verursachen kann.
Ergänzen Sie automatisierte Tests, die überprüfen, ob ausgeschlossene Felder nicht im Payload erscheinen, große Eingaben begrenzt werden, geschwärzte Daten nicht in Protokolle gelangen und Antworten mit falschem Format abgewiesen oder sicher verarbeitet werden. Wiederholen Sie diese Prüfungen, wenn sich das Datenschema, der Prompt, der Anbieter oder die Vorbereitungslogik ändert.
Checkliste vor der Aktivierung der Funktion
- Der Zweck ist definiert und für jedes übermittelte Feld gibt es einen konkreten Grund.
- Der Payload wird anhand einer Positivliste erstellt und nicht aus einer vollständigen Entität.
- Identifikatoren und Freitext werden auf Reidentifizierungsrisiken geprüft.
- Die Anwendung behält Berechtigungen, Geschäftsregeln und Daten, die die KI nicht benötigt, unter ihrer Kontrolle.
- Anfragen, Antworten und Fehler werden nicht unkontrolliert in Protokolle oder Traces kopiert.
- Es gibt Eingabegrenzen, eine Validierung der Ausgabe und eine Alternative für den Fehlerfall.
- Die Tests prüfen sowohl den Nutzen als auch das Fehlen ausgeschlossener Felder.
- Das Team weiß, bei welchen Änderungen am Ablauf die Bewertung erneut geprüft werden muss.
Die richtige Entscheidung lautet weder, möglichst viel Kontext zu senden, noch blind Daten zu entfernen. Vielmehr muss jedes Feld im Verhältnis zur Aufgabe begründet werden, die Kontrolle bei PHP bleiben und durch Tests sichergestellt werden, dass die Reduzierung einen akzeptablen Nutzen erhält, ohne die Offenlegung unnötig auszuweiten.