Een AI-functie integreren in een PHP-applicatie betekent niet dat alle beschikbare informatie de applicatie moet verlaten. Voor een samenvatting, classificatie of contextueel antwoord is vaak maar een deel nodig van de gegevens die het systeem over een persoon of proces heeft. De beslissing moet uitgaan van de concrete taak en in de daadwerkelijke gegevensstroom worden gecontroleerd, niet alleen in de interface van waaruit het model wordt aangeroepen.
Gegevensminimalisatie in AI-integraties met PHP houdt in dat je alleen de informatie verstuurt die nodig is voor een bepaald doel, gedurende de periode en via de kanalen die voor dat doel nodig zijn. Daarmee zijn privacyrisico's niet vanzelf verdwenen: ook logs, fouten, antwoorden, toegangsrechten en externe afhankelijkheden moeten worden beheerd.
Breng de gegevensstroom in kaart voordat je de code wijzigt
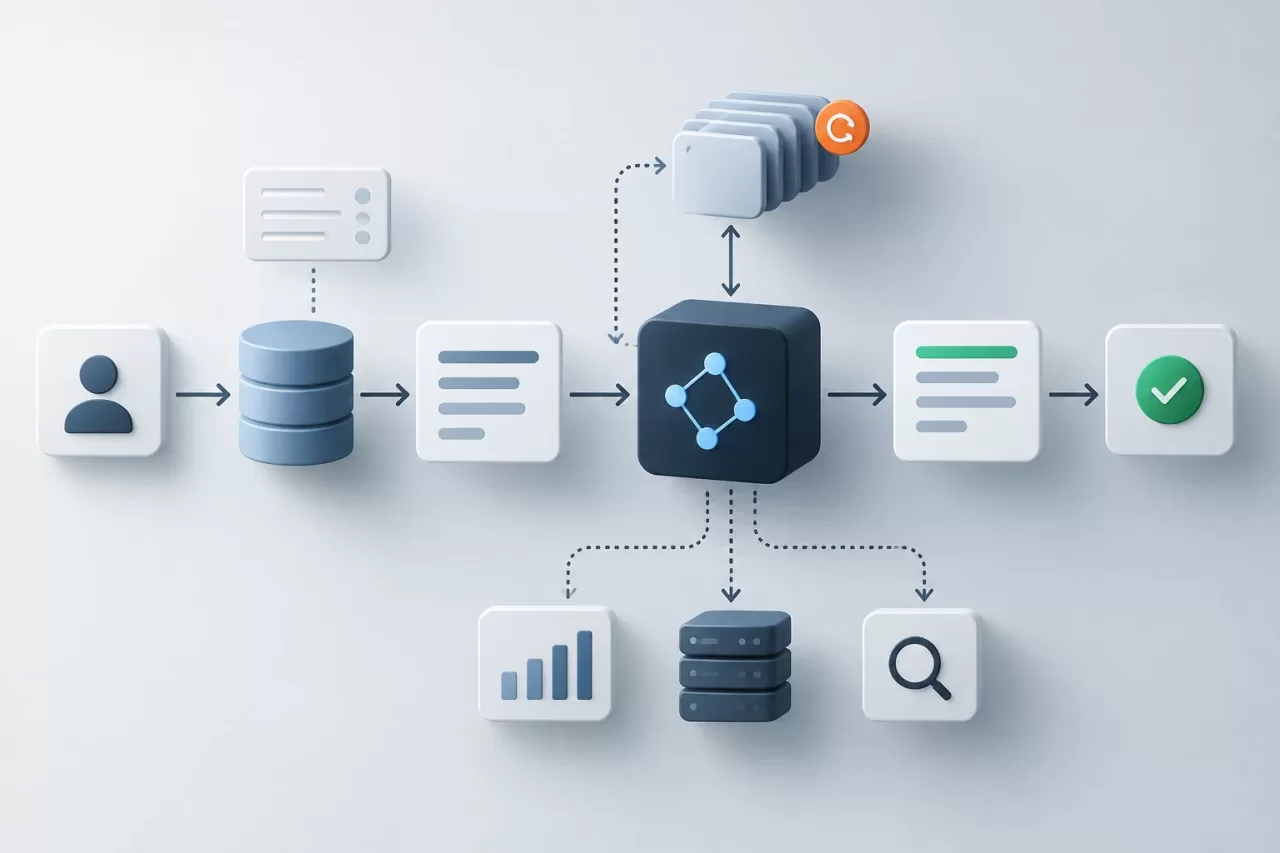
Leg vast welke gegevens de functie binnenkomen en wat er daarna mee gebeurt. Een gebruikelijke stroom omvat de gebruikersinvoer, het ophalen van context uit de database, het samenstellen van het bericht, het verzoek aan de AI-provider of -service, het antwoord en interne logs. Controleer ook of wachtrijen, retries, waarneembaarheid of supporttools de inhoud kopiëren.
Identificeer voor elke stap de verantwoordelijke partij, de bestemming, het doel en de bewaartermijn. Zoek in PHP zowel de code op die het verzoek samenstelt als de plekken waar uitzonderingen worden gelogd en resultaten worden opgeslagen. Alleen de HTTP-aanroep controleren laat mogelijke kopieën in traces, debuglogs of asynchrone taken buiten beschouwing.
- Welke velden worden opgehaald en welke komen daadwerkelijk in het verzoek terecht?
- Bevat het verzoek context uit eerdere gesprekken of bijlagen?
- Wat wordt er gelogd als de verbinding mislukt, een timeout optreedt of het antwoord ongeldig is?
- Wordt het volledige antwoord opgeslagen, terwijl alleen het benodigde resultaat bewaard hoeft te worden?
Stel voor elk gebruiksscenario een allowlist op
Classificeer velden op basis van hun noodzaak voor de taak, niet op basis van hoe makkelijk ze op te halen zijn. Een bruikbare indeling maakt onderscheid tussen essentiële gegevens, gegevens die alleen in specifieke gevallen helpen en gegevens die niet mogen worden verstuurd. Een functie die een bericht categoriseert, heeft bijvoorbeeld mogelijk de tekst en een beperkte lijst met categorieën nodig, maar niet per se de naam, het e-mailadres, het adres of de volledige geschiedenis van de afzender.
Zet die beslissing om in een allowlist die specifiek is voor elke functie. Serialiseer geen volledige entiteit en geef geen domeinobject rechtstreeks door aan de AI-laag: zulke objecten kunnen nu gevoelige velden bevatten of die later krijgen. Stel een expliciet overdrachtsobject samen met de goedgekeurde waarden en valideer de structuur ervan voordat je het verzoek aanmaakt.
$input = [
    'message' => $ticket->publicMessage(),
    'allowed_categories' => $categoryNames,
];

$payload = $validator->validate($input);
De validatie moet grenzen stellen aan grootte en formaat en bovendien controleren of er geen velden buiten de allowlist voorkomen. Houd de autorisatie om informatie in de applicatie te lezen gescheiden van de beslissing om die informatie in het verzoek op te nemen: dat een PHP-proces toegang heeft tot gegevens betekent niet dat de AI-functie die nodig heeft.
Beperk identificerende gegevens en vertrouw niet alleen op pseudonimisering
Wanneer een taak records van elkaar moet kunnen onderscheiden zonder de werkelijke identiteit te kennen, kan het haalbaar zijn om directe identificatoren te vervangen door interne verwijzingen of pseudoniemen. Bewaar de tabel die de verwijzing aan de persoon koppelt binnen de applicatie en buiten de verstuurde inhoud, met beperkte toegang. Verstuur geen sleutels waarmee de identiteit kan worden achterhaald, tenzij die onmisbaar zijn.
Pseudonimisering is niet hetzelfde als anonimisering. Vrije tekst kan een identiteit onthullen via namen, functies, locaties, datums, incidentdetails of een combinatie van kenmerken. Heridentificatie kan ook mogelijk zijn door gegevens met andere informatie te combineren. Controleer de inhoud en de context, niet alleen de gestructureerde velden; scherm details af of generaliseer ze voordat je ze verstuurt wanneer dat passend is.
Als het verwijderen van een gegeven de kwaliteit van het antwoord verandert, probeer dan minder identificerende alternatieven: bereiken in plaats van exacte waarden, categorieën in plaats van persoonlijke beschrijvingen, of een samenvatting die door de applicatie is opgesteld. Houd in PHP de informatie bij die nodig is om het antwoord aan het juiste record te koppelen, tenzij de taak iets anders vereist.
Houd informatie die het model niet nodig heeft onder controle van PHP
Scheid de voorbereiding van de context van de bedrijfslogica. PHP kan toegangsrechten toepassen, relaties opzoeken, velden selecteren en AI-uitvoer combineren met gegevens die nooit zijn verstuurd. De functie kan een label of suggestie teruggeven; de applicatie blijft verantwoordelijk voor het valideren van het resultaat en de beslissing om al dan niet een actie uit te voeren.
Stel grenzen aan antwoorden: verwacht formaat, lengte, toegestane waarden en de afhandeling van onverwachte inhoud. Als de uitvoer aan gebruikers wordt getoond, escape die dan voor de betreffende weergavecontext en behandel die niet als een betrouwbare instructie. Als de uitvoer een bewerking kan veroorzaken — bijvoorbeeld het wijzigen van een record — is aanvullende validatie vereist en, afhankelijk van de impact, menselijke bevestiging.
Ook foutafhandeling hoort bij het ontwerp. Bepaal wat er moet gebeuren bij een timeout, een fout van de provider, een leeg antwoord of een formaat dat niet kan worden geïnterpreteerd. Afhankelijk van de situatie kun je de gebruiker vragen het opnieuw te proberen, een handmatige bewerking aanbieden of doorgaan zonder de functie. Vermijd onbeperkte retries en geef gebruikers geen interne details terug die verzoeken, credentials of persoonsgegevens bevatten.
Voorkom dat logs een tweede kopie worden
Leg nuttige operationele gegevens vast — correlatie-ID, duur, status en foutcode — zonder automatisch de volledige prompt en het volledige antwoord op te slaan. Als inhoud bewaard moet blijven om een probleem te onderzoeken, definieer dan het doel, de toegang en de bewaartermijn en overweeg een weergave met afgeschermde gegevens of een testomgeving met synthetische gegevens.
Controleer foutmeldingen, monitoringtools, wachtrijen en auditlogs. Een fout mag niet standaard het volledige verzoek reproduceren. Hetzelfde principe geldt voor tijdelijke debuglogging: beperk de activering ervan, vermijd waar mogelijk echte gegevens en controleer of deze niet ingeschakeld blijft in productie.
Controleer de bruikbaarheid en beperkingen met representatieve tests
Maak voordat je de gegevensstroom inschakelt testgevallen voor gebruikelijke invoer, grensgevallen en fouten, zonder echte persoonsgegevens te gebruiken tenzij daar een rechtvaardiging voor is en passende maatregelen zijn getroffen. Vergelijk de functie met de beoogde set velden en met een kleinere variant. Beoordeel of de functie de taak uitvoert, informatie verzint of verkeerd classificeert en of een onjuist antwoord schade kan veroorzaken.
Voeg geautomatiseerde tests toe om te controleren of uitgesloten velden niet in de payload voorkomen, grote invoer wordt begrensd, afgeschermde gegevens niet in logs terechtkomen en antwoorden met een afwijkend formaat worden afgewezen of veilig afgehandeld. Herhaal deze controles wanneer het dataschema, de prompt, de provider of de logica voor het voorbereiden van gegevens verandert.
Checklist voordat je de functie inschakelt
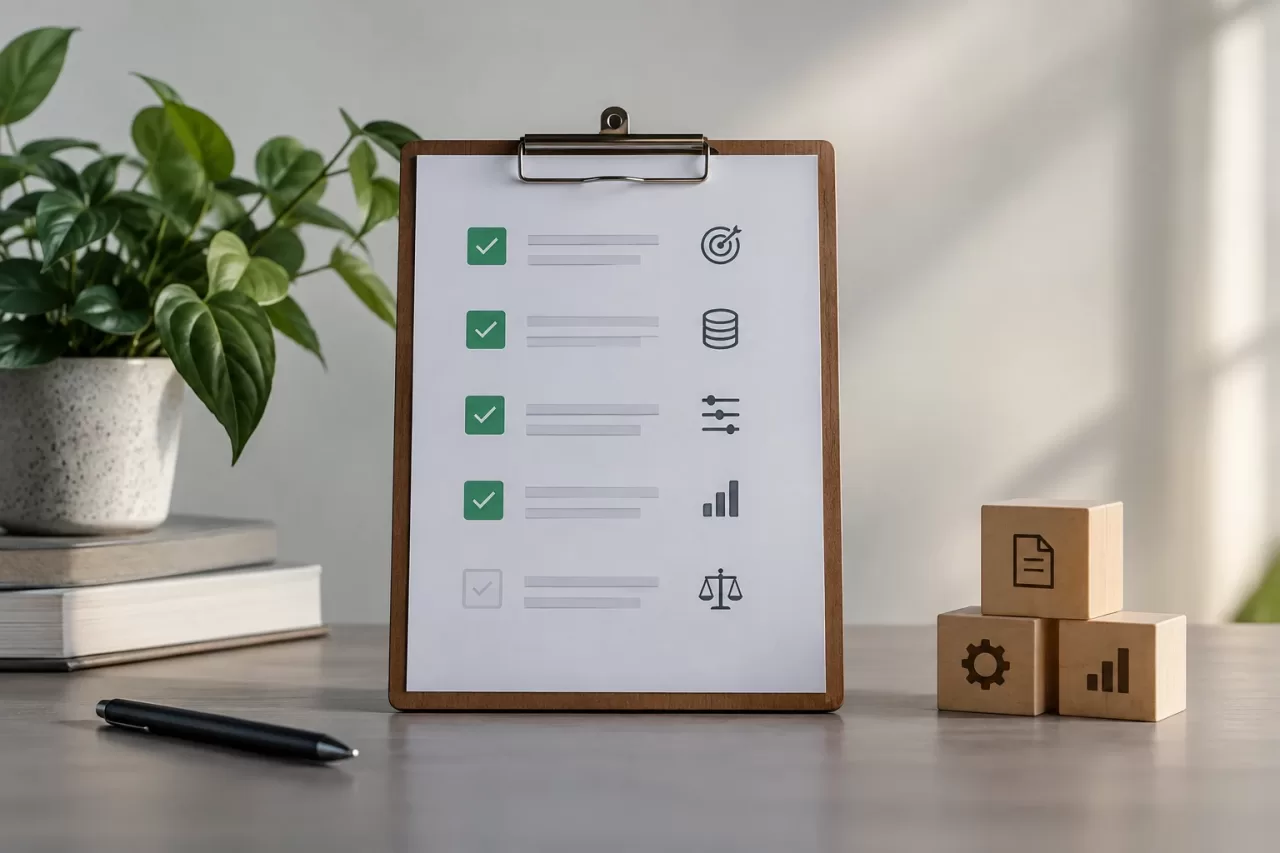
- Het doel is gedefinieerd en voor elk verstuurd veld is er een concrete reden.
- De payload wordt samengesteld op basis van een allowlist, niet vanuit een volledige entiteit.
- Identificatoren en vrije tekst zijn gecontroleerd op risico's van heridentificatie.
- De applicatie behoudt de toegangsrechten, bedrijfsregels en gegevens die de AI niet nodig heeft.
- Verzoeken, antwoorden en fouten worden niet ongecontroleerd naar logs of traces gekopieerd.
- Er zijn invoerlimieten, uitvoervalidatie en een alternatief voor storingen.
- De tests controleren zowel de bruikbaarheid als de afwezigheid van uitgesloten velden.
- Het team weet welke wijzigingen in de gegevensstroom een nieuwe beoordeling vereisen.
De juiste keuze is niet om zo veel mogelijk context te versturen of blindelings gegevens te verwijderen. Je moet elk veld verantwoorden op basis van de taak, de controle in PHP behouden en testen of de beperking voldoende bruikbaar blijft zonder de blootstelling onnodig te vergroten.