Integrare una funzione di IA in un’applicazione PHP non significa che tutte le informazioni disponibili debbano uscire dall’applicazione. Un riepilogo, una classificazione o una risposta contestuale richiedono spesso solo una parte dei dati che il sistema possiede su una persona o un processo. La decisione deve partire dal compito specifico e va verificata nel flusso effettivo, non solo nell’interfaccia da cui viene invocato il modello.
La minimizzazione dei dati nelle integrazioni di IA con PHP consiste nell’inviare solo le informazioni necessarie per uno scopo definito, per il tempo e attraverso i canali richiesti da tale scopo. Da sola non elimina i rischi per la privacy: occorre controllare anche log, errori, risposte, autorizzazioni e dipendenze esterne.
Traccia il percorso dei dati prima di modificare il codice
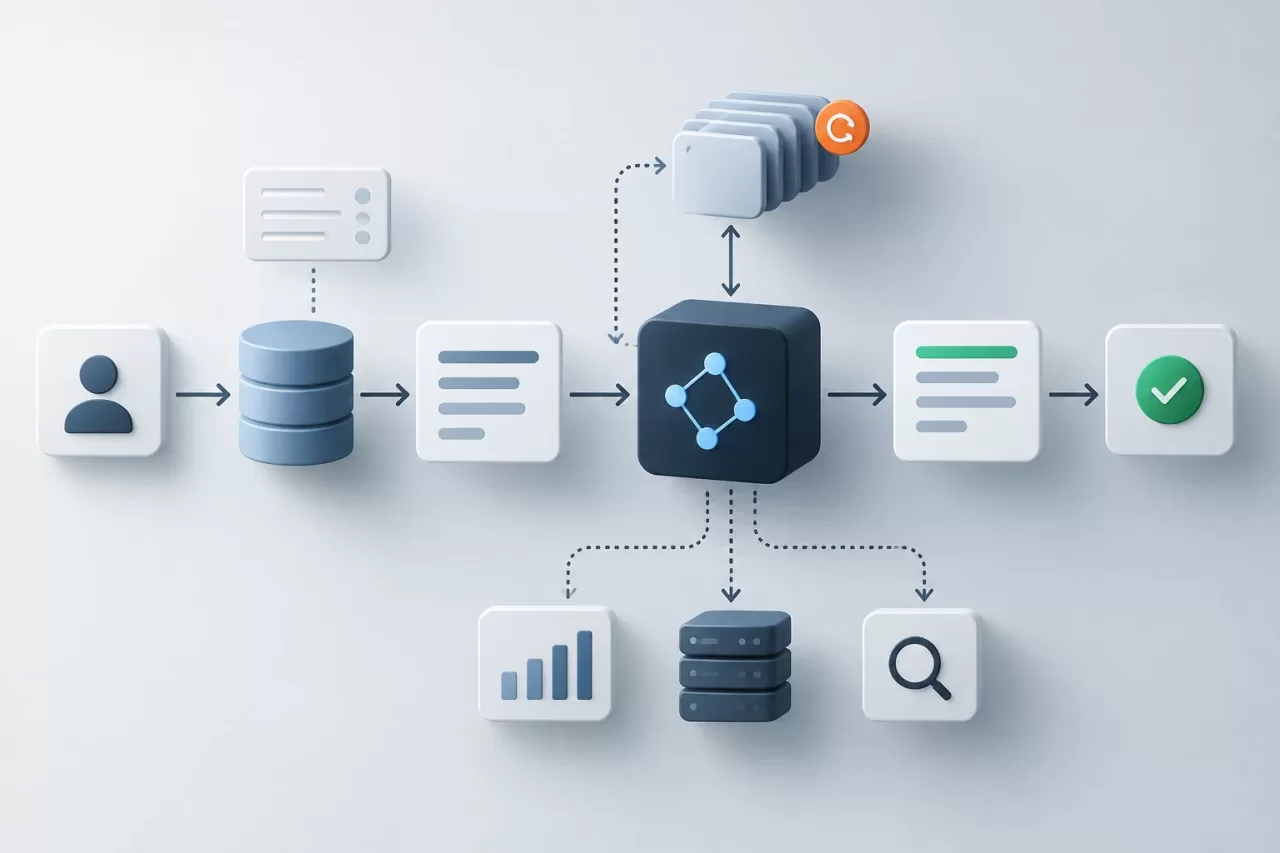
Documenta quali dati entrano nella funzione e cosa accade in seguito. Un percorso tipico comprende l’input dell’utente, il caricamento del contesto dal database, la preparazione del messaggio, la richiesta al provider o al servizio di IA, la risposta e i log interni. Verifica anche se code, retry, strumenti di osservabilità o di supporto copiano il contenuto.
Per ogni fase, individua il responsabile, la destinazione, lo scopo e il periodo di conservazione. In PHP conviene individuare sia il codice che costruisce la richiesta sia i punti in cui vengono registrate le eccezioni e salvati i risultati. Esaminare solo la chiamata HTTP non basta: si rischia di non considerare eventuali copie nei trace, nei dati di debug o nei processi asincroni.
- Quali campi vengono consultati e quali finiscono effettivamente nella richiesta?
- La richiesta include il contesto delle conversazioni precedenti o allegati?
- Cosa viene registrato se la connessione fallisce, scade il timeout o la risposta non è valida?
- La risposta completa viene salvata anche quando basterebbe conservare il risultato necessario?
Definisci una allowlist per ogni caso d’uso
Classifica i campi in base alla loro necessità per il compito, non in base alla facilità con cui è possibile recuperarli. Una classificazione utile distingue i dati indispensabili, quelli utili solo in casi specifici e quelli che non devono essere inviati. Per esempio, una funzione che categorizza un messaggio potrebbe aver bisogno del testo e di un elenco limitato di categorie, ma non necessariamente del nome, dell’indirizzo email, dell’indirizzo o della cronologia completa di chi lo ha scritto.
Trasforma questa decisione in un’allowlist specifica per ogni funzione. Evita di serializzare un’entità completa o di passare direttamente un oggetto di dominio al livello di IA: questi oggetti possono contenere oggi campi sensibili o acquisirne in futuro. Crea un oggetto di trasferimento esplicito con i valori approvati e convalidane la struttura prima di creare la richiesta.
$input = [
    'message' => $ticket->publicMessage(),
    'allowed_categories' => $categoryNames,
];

$payload = $validator->validate($input);
La convalida deve applicare limiti di dimensione e formato, oltre a verificare che non compaiano campi estranei all’allowlist. Mantieni distinte l’autorizzazione a leggere le informazioni nell’applicazione e la decisione di includerle nella richiesta: il fatto che un processo PHP possa accedere a un dato non significa che la funzione di IA ne abbia bisogno.
Riduci gli identificatori senza affidarti solo alla pseudonimizzazione
Quando un’attività richiede di distinguere i record senza conoscere l’identità reale, può essere possibile sostituire gli identificatori diretti con riferimenti interni o pseudonimi. Mantieni all’interno dell’applicazione, e fuori dal contenuto inviato, la tabella che collega il riferimento alla persona, limitandone l’accesso. Non inviare chiavi che consentano di ricostruire l’identità, a meno che non siano indispensabili.
La pseudonimizzazione non equivale all’anonimizzazione. Un testo libero può rivelare un’identità attraverso nomi, ruoli, luoghi, date, dettagli di un incidente o una combinazione di attributi. Può inoltre essere reidentificabile incrociandolo con altri dati. Esamina il contenuto e il contesto, non solo i campi strutturati; quando opportuno, oscura o generalizza i dettagli prima di inviarli.
Se rimuovere un dato riduce la qualità della risposta, prova alternative meno identificative: intervalli anziché valori esatti, categorie anziché descrizioni personali oppure un riepilogo preparato dall’applicazione. Conserva in PHP le informazioni necessarie per associare la risposta al record corretto, a meno che il compito non richieda altro.
Mantieni sotto il controllo di PHP le informazioni che non servono al modello
Separa la preparazione del contesto dalla logica di business. PHP può applicare le autorizzazioni, risolvere le relazioni, selezionare i campi e combinare l’output dell’IA con dati che non sono mai stati inviati. La funzione può restituire un’etichetta o un suggerimento; l’applicazione resta responsabile di verificare che il risultato sia valido e di decidere se eseguire un’azione.
Definisci limiti per le risposte: formato previsto, lunghezza, valori consentiti e gestione dei contenuti inattesi. Se l’output viene mostrato agli utenti, effettua l’escaping in base al contesto di presentazione e non trattarlo come un’istruzione attendibile. Se può attivare un’operazione, per esempio modificare un record, richiedi un’ulteriore convalida e, a seconda dell’impatto, la conferma di una persona.
Anche gli errori fanno parte della progettazione. Stabilisci cosa fare in caso di timeout, errore del provider, risposta vuota o formato non interpretabile. A seconda del caso, si può chiedere all’utente di riprovare, offrire un’operazione manuale o proseguire senza la funzione. Evita retry illimitati e non mostrare all’utente dettagli interni che contengano richieste, credenziali o dati personali.
Evita che i log diventino una seconda copia
Registra segnali operativi utili — identificatore di correlazione, durata, stato e codice di errore — senza salvare automaticamente il prompt e la risposta completi. Se è necessario conservare contenuti per indagare un problema, definisci finalità, accesso e periodo di conservazione e valuta una versione oscurata o un ambiente di test con dati sintetici.
Esamina i messaggi di eccezione, gli strumenti di monitoraggio, le code e i log di audit. Per impostazione predefinita, un errore non dovrebbe riprodurre la richiesta completa. Lo stesso principio vale per il debug temporaneo: limita la sua attivazione, evita i dati reali quando possibile e verifica che non resti abilitato in produzione.
Verifica utilità e limiti con test rappresentativi
Prima di abilitare il flusso, crea casi che rappresentino input abituali, casi limite ed errori, senza usare dati personali reali se non esistono una giustificazione e controlli adeguati. Confronta il funzionamento con l’insieme di campi previsto e con una versione ridotta. Valuta se il compito viene svolto, se il sistema inventa informazioni o classifica in modo errato e se una risposta sbagliata può causare danni.
Aggiungi test automatizzati per verificare che i campi esclusi non compaiano nel payload, che gli input di grandi dimensioni siano limitati, che i dati oscurati non finiscano nei log e che le risposte in un formato inatteso vengano rifiutate o gestite in modo sicuro. Ripeti queste verifiche quando cambiano lo schema dei dati, il prompt, il provider o la logica di preparazione.
Checklist prima di abilitare la funzione
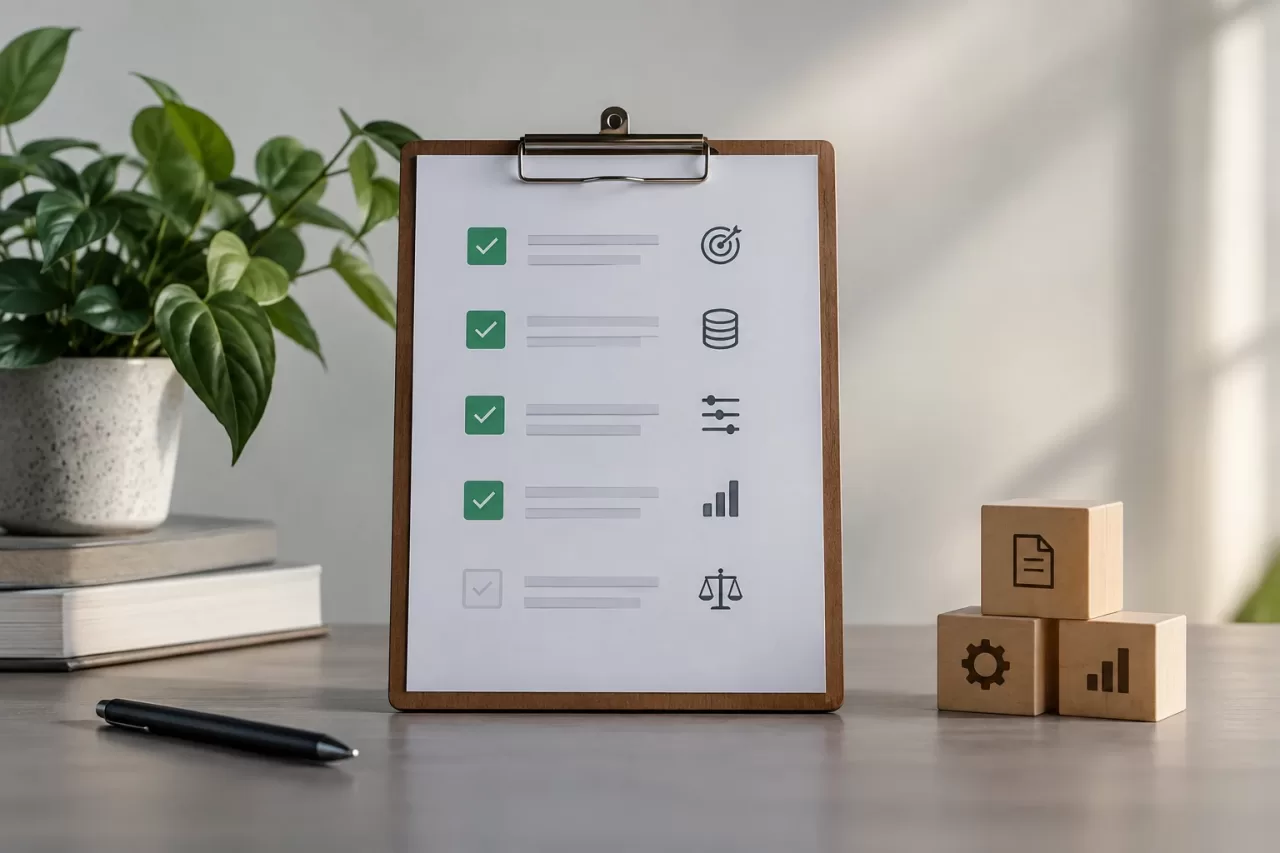
- Lo scopo è definito e ogni campo inviato ha una motivazione specifica.
- Il payload viene costruito a partire da un’allowlist, non da un’entità completa.
- Gli identificatori e i testi liberi vengono esaminati per i rischi di reidentificazione.
- L’applicazione mantiene le autorizzazioni, le regole di business e i dati di cui l’IA non ha bisogno.
- Richieste, risposte ed errori non vengono copiati senza controllo nei log o nei trace.
- Sono previsti limiti per l’input, convalida dell’output e un’alternativa in caso di errore.
- I test verificano sia l’utilità sia l’assenza dei campi esclusi.
- Il team sa quali modifiche al flusso richiedono una nuova valutazione.
La scelta corretta non è inviare più contesto possibile né eliminare dati alla cieca. È giustificare ogni campo in relazione al compito, mantenere il controllo in PHP e verificare che la riduzione conservi un’utilità accettabile senza ampliare inutilmente l’esposizione.