
Un’integrazione può rispondere correttamente e, nonostante ciò, lasciare dati diversi in due sistemi. Una richiesta può scadere dopo che il sistema esterno ha salvato la modifica; un evento può arrivare in ritardo; oppure un aggiornamento locale può modificare un campo controllato anche dall’altro sistema. Per questo, oltre a sincronizzare gli eventi, è utile poter confrontare gli stati e risolvere le discrepanze in modo intenzionale.
La riconciliazione dei dati tra sistemi in PHP è un processo periodico o su richiesta che individua le differenze tra record correlati, ne determina il significato e propone o applica un’azione. Non consiste nel copiare indiscriminatamente i dati da un sistema all’altro. Per evitare di perdere informazioni valide, occorre definire l’autorità per ciascun dato, conservare le evidenze del confronto e proteggere l’applicazione da correzioni ripetute o massive.
Definire quale sistema ha autorità prima del confronto
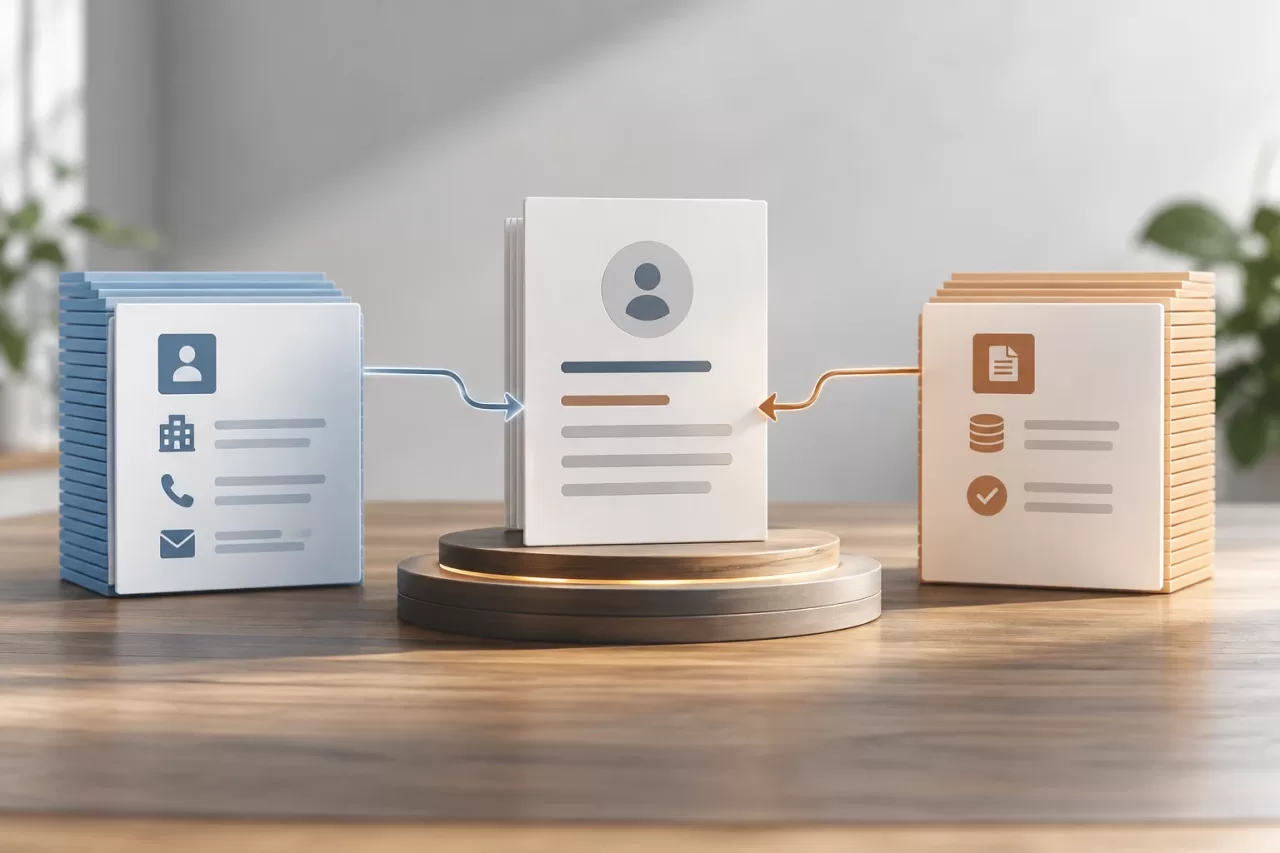
La fonte di verità non è sempre unica per un’intera entità. Il CRM può essere responsabile del nome commerciale e dei dati di contatto, mentre il sistema di fatturazione controlla lo stato del pagamento e l’identificativo fiscale convalidato. Se si designa un intero sistema come autorità senza esaminare i singoli campi, la riconciliazione può sostituire informazioni corrette con una copia obsoleta o incompleta.
Documenta la titolarità dei campi scambiati. Per ciascuno, registra quale sistema può originare le modifiche, quale deve prevalere in caso di conflitto, se il valore può essere nullo e quali trasformazioni sono accettabili. È inoltre utile distinguere tra campi modificabili e campi derivati: per esempio, potrebbe essere necessario rigenerare un totale calcolato a partire dai suoi componenti invece di copiarlo.
- Autorità per campo: definisci chi decide il valore e cosa fare se entrambi i sistemi presentano modifiche.
- Regole di combinazione: specifica se è possibile completare un dato mancante senza sostituirne uno esistente.
- Eccezioni: indica quali conflitti richiedono approvazione, convalide aggiuntive o l’intervento del team responsabile.
Quando non esiste una regola sicura, la scelta corretta è contrassegnare il conflitto per la revisione, non selezionare arbitrariamente il record con la data più recente. Gli orologi possono essere disallineati e una marca temporale, da sola, non dimostra che una modifica sia legittima.
Rendere il confronto riproducibile
Per essere utile, un confronto deve identificare lo stesso record su entrambi i lati. Usa un identificativo stabile condiviso oppure una tabella di corrispondenze gestita esplicitamente. Non basarti solo su nomi, indirizzi email o altri campi che possono cambiare, ripetersi o essere normalizzati in modo diverso. Se non si trova una relazione univoca, classifica il caso come in attesa di associazione invece di unire i record per approssimazione.
Confronta i valori normalizzati secondo regole documentate: per esempio, spazi, maiuscole e minuscole o formati di data. Conserva anche il valore originale, perché normalizzare per il confronto non autorizza a modificare il dato persistito. Presta attenzione ai fusi orari, alla precisione decimale, ai valori vuoti e alle differenze tra un campo assente e uno presente con valore nullo. Considerare equivalenti questi stati può nascondere modifiche rilevanti.
Per insiemi di grandi dimensioni, definisci una finestra di elaborazione e un watermark, come una data di modifica o un cursore di paginazione. Salva il punto di avanzamento solo quando il batch è stato elaborato in modo coerente. Se il provider non offre date di modifica affidabili, un’esplorazione completa ma meno frequente, oppure una combinazione di campionamento e riconciliazione mirata, può essere più sicura che fingere un’elaborazione incrementale non garantita dall’API. La strategia dipende dai limiti, dalla stabilità e dalle garanzie effettive di ciascun sistema.
In PHP, separa il recupero dei dati dal confronto e dalla persistenza dei risultati. Per esempio, una funzione di confronto può ricevere due rappresentazioni normalizzate e restituire un elenco di differenze tipizzate, senza effettuare chiamate remote né aggiornare record. Questa separazione consente di testare le regole con casi controllati e di esaminare le proposte prima di abilitare le scritture.
Classificare le discrepanze e decidere come rispondere
Non tutte le differenze indicano un errore e ogni categoria richiede una policy diversa. Una classificazione esplicita migliora la diagnosi e impedisce che un’unica regola distruttiva venga applicata a situazioni diverse.
- Record mancante: il record esiste in un sistema ma non nell’altro. Verifica se si tratta di una creazione recente, di un’eliminazione legittima, di un filtro o di un errore di paginazione.
- Duplicato: più record sembrano corrispondere alla stessa entità. Non selezionarne automaticamente uno senza una regola d’identità verificabile.
- Modifica incompatibile: entrambi i sistemi hanno modificato un campo controllato da entrambi. Applica una policy di titolarità oppure invia il conflitto in revisione.
- Dato non valido: il valore non rispetta il formato o i vincoli previsti. Mettilo in quarantena ed evita di propagarlo.
- Disallineamento temporale: la differenza può dipendere da un ritardo di consegna o di elaborazione. Riprova o attendi un intervallo definito prima di dichiarare un conflitto persistente.
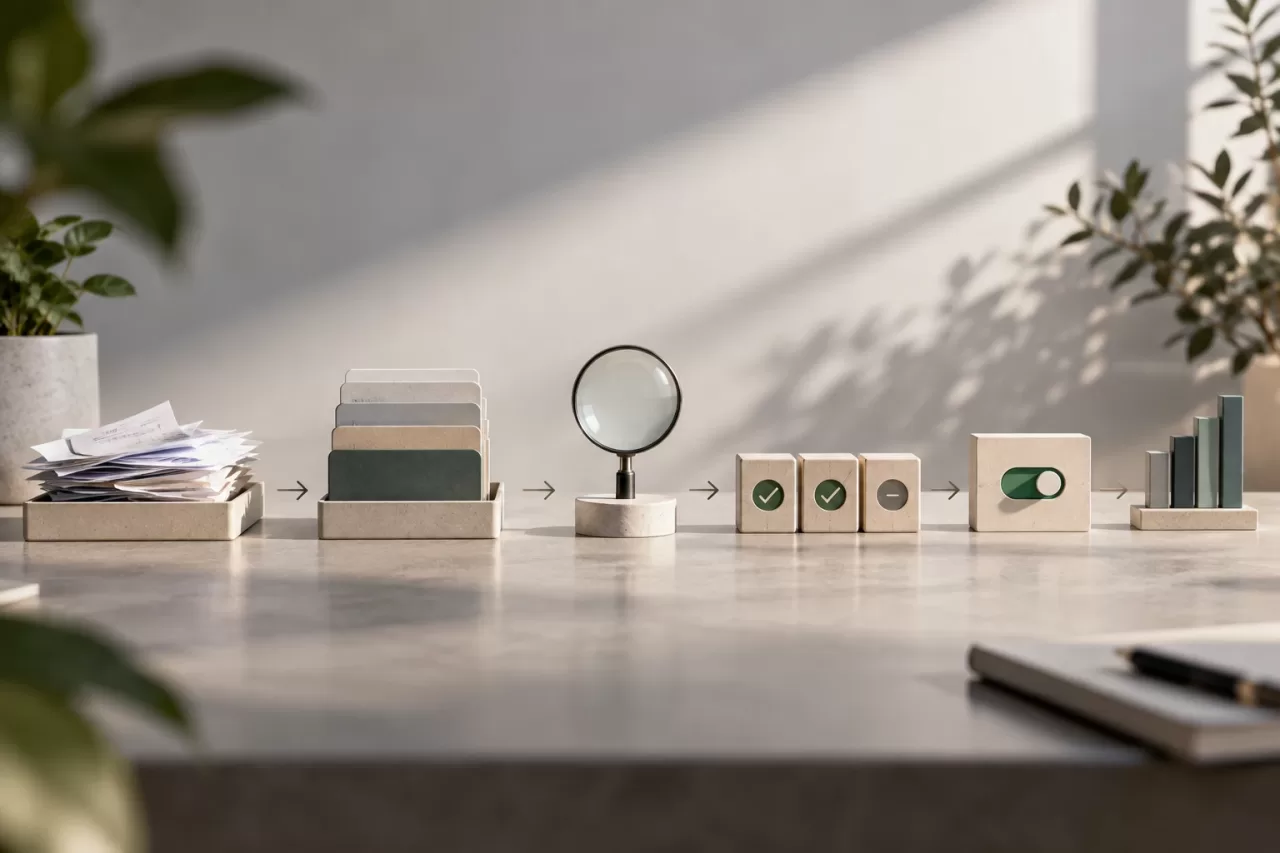
Separa tre fasi: rilevamento della differenza, decisione sull’azione e applicazione della modifica. Una proposta può consistere nell’aggiornare un campo, creare un’associazione, richiedere una revisione o non fare nulla. Mantenere separate queste fasi permette di iniziare in modalità di sola lettura e capire cosa cambierebbe prima di attivare le correzioni automatiche.
Applicare modifiche senza creare nuovi danni
Automatizza solo i casi coperti da regole chiare e verificabili. Per gli altri, predisponi una coda di revisione con l’identificativo dell’entità, i valori osservati, la regola che verrebbe attivata e l’azione proposta. L’interfaccia o il processo operativo devono consentire di accettare, rifiutare o inoltrare la proposta, registrando, quando opportuno, chi ha preso la decisione.
Progetta le operazioni in modo che siano idempotenti: elaborare di nuovo la stessa discrepanza non deve creare duplicati né alternare i valori all’infinito. Prima di scrivere, verifica che il record sia ancora nello stato previsto. Se è cambiato dopo la lettura, interrompi l’aggiornamento e confronta di nuovo i dati. Quando l’API esterna lo consente, usa versioni, condizioni di scrittura o chiavi di idempotenza; non dare per scontato che siano disponibili senza averlo verificato.
Limita l’ambito con batch ridotti, un numero massimo di modifiche per esecuzione e opzioni di pausa. Se l’esecuzione della correzione supera il volume previsto, l’esecuzione deve essere fermata oppure deve essere richiesta un’autorizzazione: non deve proseguire senza avvisi. Per le modifiche ad alto impatto, registra una possibile operazione compensativa, ma non presentarla come garanzia di rollback: potrebbero esserci modifiche successive o effetti esterni impossibili da annullare.
Registrare ogni esecuzione per analizzarla e ripeterla
Salva un identificativo dell’esecuzione, l’ora di inizio e di fine, l’intervallo o il cursore elaborato, i sistemi consultati, i risultati per categoria e gli errori. Per ogni discrepanza, conserva la chiave di correlazione, i valori rilevanti o una rappresentazione protetta, la regola valutata, l’azione proposta e l’esito dell’applicazione. In questo modo è possibile spiegare perché è stata presa una decisione e distinguere un errore d’integrazione da un conflitto effettivo.
Proteggi i log: possono contenere dati personali, credenziali indirette o informazioni commerciali. Evita di registrare payload completi quando bastano campi specifici, limita gli accessi e definisci i tempi di conservazione. Includi riferimenti ai record di origine e l’ora di osservazione per agevolare le verifiche, senza trasformare il log in un secondo database privo di controllo.
Riprova solo gli errori transitori, con limiti e intervalli crescenti. Registra i tentativi e separa gli errori permanenti, come dati non validi o permessi insufficienti, per evitare cicli che ripetono lo stesso problema. Deve essere possibile riprendere un’esecuzione secondo un criterio noto, senza dipendere dal fatto che il processo PHP resti attivo indefinitamente.
Checklist prima di automatizzare
- È definita l’autorità per ciascun campo e la gestione dei valori nulli e delle eliminazioni?
- Gli identificativi collegano i record senza ambiguità e i duplicati vengono gestiti?
- Sono stati testati la paginazione, i ritardi, i limiti dell’API, i tentativi e le modifiche concorrenti?
- Le differenze sono classificate e le eccezioni vengono inviate in revisione o in quarantena?
- Il confronto può essere eseguito in modalità di sola lettura e mostrare le azioni proposte?
- Le scritture sono idempotenti, subordinate allo stato previsto e limitate per volume?
- Decisioni ed esiti vengono registrati con adeguate misure di protezione dei dati e degli accessi?
- Sono stati effettuati test con dati rappresentativi, inclusi conflitti, valori vuoti, duplicati ed errori parziali?
Inizia osservando e classificando, non correggendo. Dopo aver convalidato le regole su dati reali e aver esaminato le proposte, attiva l’automazione solo per le discrepanze a basso rischio. Mantieni una modalità di pausa e controlla periodicamente i falsi positivi, i casi irrisolti e le modifiche ai sistemi esterni. In questo modo la riconciliazione diventa un controllo operativo ripetibile, invece di una sincronizzazione che nasconde i conflitti finché qualcuno non ne scopre le conseguenze.


