Gdy integracja przestaje działać, odpowiedź na pytanie „co otrzymała nasza aplikacja?” może wymagać przeszukiwania logów, zapytań do bazy danych i paneli dostawcy. Skrzynka odbiorcza webhooków w PHP zapewnia operacyjny rejestr odebranych zdarzeń i ich przebiegu w systemie. Jej zadaniem jest odtworzenie tego, co dotarło, jakie działania podjęto i co wymaga uwagi — nie zastępowanie wszystkich komponentów przetwarzania.
Dobre zaprojektowanie skrzynki wymaga oddzielenia odbioru, walidacji i wykonania; rejestrowania przydatnych metadanych bez gromadzenia danych wrażliwych; oraz określenia, jak ponowić operację bez powielania efektów biznesowych. Narzędzie powinno jasno pokazywać granice swojej wiedzy: zapis informacji o przyjęciu zdarzenia nie dowodzi, że późniejszy efekt został zrealizowany.
Kiedy potrzebna jest skrzynka odbiorcza
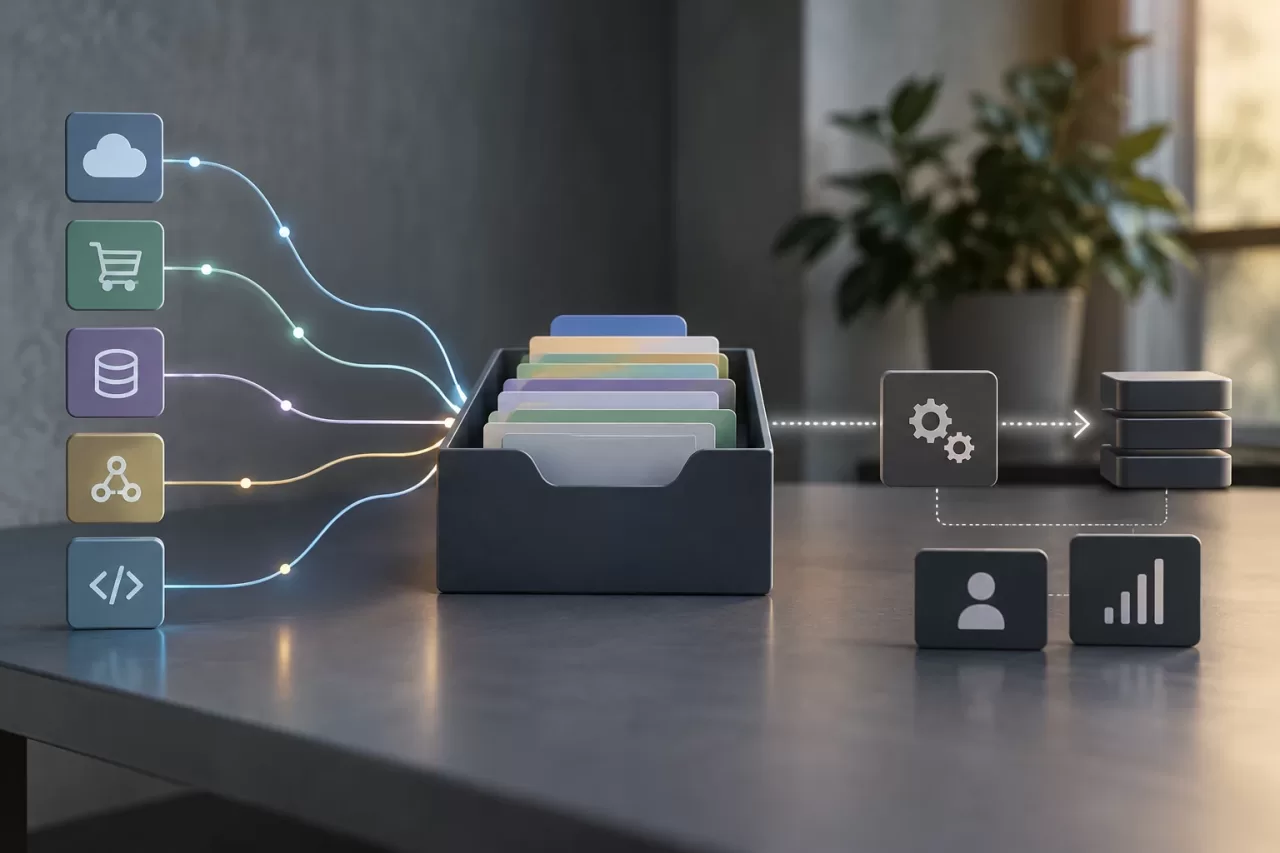
Może się przydać, gdy system odbiera zdarzenia od wielu dostawców, występują trudne do odtworzenia sporadyczne awarie albo zespoły wsparcia i inżynierski muszą przeglądać historię bez bezpośredniego dostępu do środowiska produkcyjnego. Pomaga także wtedy, gdy poprawna odpowiedź HTTP potwierdza jedynie odbiór, a przetwarzanie trwa dalej asynchronicznie.
Nie zawsze trzeba tworzyć własny interfejs. W przypadku prostej integracji o niewielkim wolumenie, której błędy są już widoczne w używanych narzędziach, wystarczą ustrukturyzowane logi i alerty. Zanim dodasz skrzynkę odbiorczą, sprawdź, jakie informacje udostępnia dostawca, jak długo przechowuje historię i jakimi narzędziami obserwowalności dysponuje zespół. Nie twórz drugiego źródła prawdy bez wyraźnej potrzeby operacyjnej.
Skrzynka nie jest też kolejką zadań ani systemem audytu zmian. Kolejka zarządza oczekującą pracą, współbieżnością, dostępnością i próbami wykonania. Skrzynka opisuje odbiór zdarzeń i ich stan operacyjny. Audyt rejestruje, kto, co i kiedy zmienił w domenie. Te elementy mogą być powiązane identyfikatorami, ale każdy odpowiada na inne pytania.
Oddzielenie odbioru, walidacji i przetwarzania
Endpoint powinien weryfikować wymagania dotyczące transportu i autentyczności przed przyjęciem zdarzenia: na przykład walidować podpis zgodnie z mechanizmem dostawcy i sprawdzać, czy treść żądania ma dopuszczalny format. Następnie może zapisać odbiór i przekazać zadanie do kolejki. Sukces odpowiedzi wysyłanej nadawcy powinien mieć precyzyjne znaczenie, na przykład „odebrano i zapisano”, a nie „cały proces biznesowy został zakończony”.
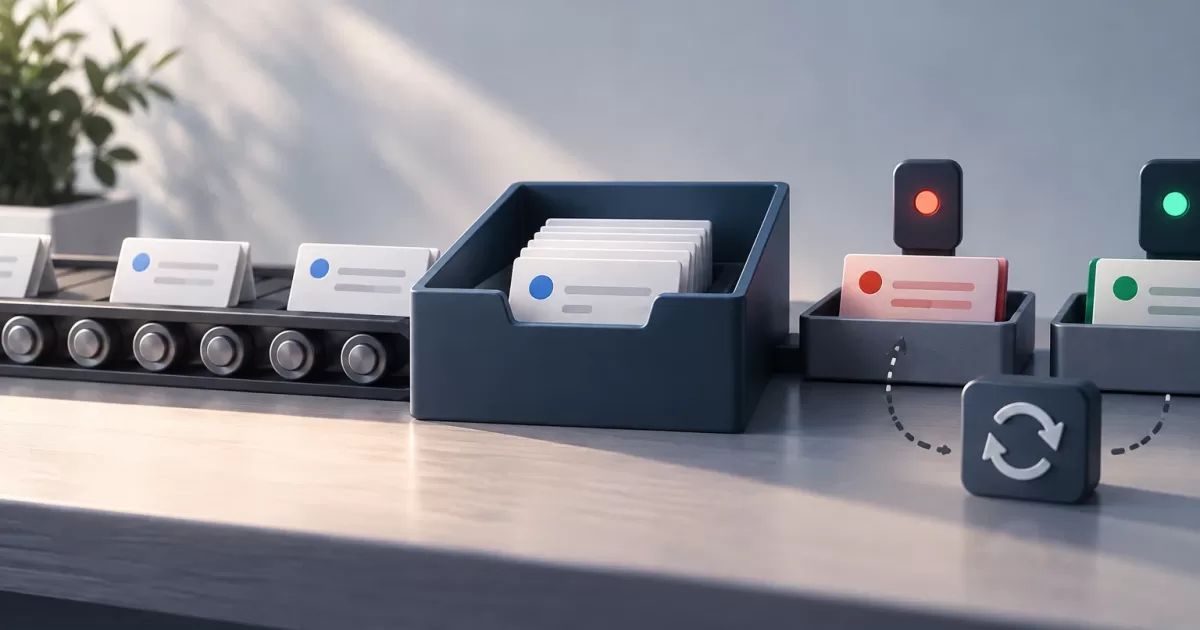
Zdefiniuj jawne stany i przejścia między nimi. Przykładowy zestaw to received, rejected, queued, processing, processed i failed. Dopasuj go do rzeczywistego przepływu: nie używaj tego samego stanu dla nieprawidłowego zdarzenia i zdarzenia, którego przetwarzanie nie powiodło się z powodu chwilowej niedostępności zależności. Zapisuj, kiedy stan uległ zmianie, a w razie potrzeby także bezpieczną kategorię błędu przydatną do diagnostyki. Unikaj niejednoznacznych stanów, takich jak „ukończono”, jeśli zakończył się tylko jeden etap.
Jeśli zapisujesz rekord i publikujesz zadanie w kolejce, weź pod uwagę okno awarii między tymi operacjami. Wzorzec transactional outbox może pomóc zapisać zdarzenie i zamiar publikacji w ramach jednej transakcji, a następnie wysłać ten zamiar do realizacji. Nie eliminuje wszystkich awarii: konsument nadal musi tolerować ponowne dostarczenia.
Co rejestrować, aby prześledzić przebieg
Zaprojektuj rejestr tak, aby można było znaleźć zdarzenie i powiązać jego kolejne etapy. W zależności od dostawcy i potrzeb biznesowych uwzględnij:
- Wewnętrzny identyfikator rekordu oraz identyfikator zdarzenia nadawcy, jeśli istnieje.
- Dostawcę, typ zdarzenia i niewrażliwe odwołanie do konta lub integracji odbierającej zdarzenie.
- Daty odbioru, walidacji, umieszczenia w kolejce i ostatniej aktualizacji, z zachowaniem spójnej konwencji dotyczącej strefy czasowej.
- Aktualny stan, liczbę prób i skrótowy wynik każdego wykonania.
- Identyfikatory korelacji lub śledzenia, a także odwołania do zadania i powiązanych rekordów aplikacji.
- Przydatną operacyjnie kategorię błędu, na przykład błąd walidacji, niedostępność zależności lub konflikt biznesowy.
Zachowuj identyfikator korelacji od endpointu przez zadanie aż po wywoływane usługi. Dzięki temu można rozpocząć od zdarzenia i prześledzić wykonanie w logach lub śladach rozproszonych. Nie kopiuj dużych fragmentów logów do rekordu skrzynki: zapisuj odwołania, a szczegółowe informacje o przebiegu w czasie sprawdzaj w systemie obserwowalności.
Minimalizowanie danych wrażliwych już na etapie projektu
Zapisywanie zawsze pełnej treści żądania wydaje się praktyczne, ale może prowadzić do niepotrzebnego przechowywania danych osobowych, sekretów lub informacji handlowych. Zdecyduj dla każdego pola z osobna, czy jest potrzebne do zidentyfikowania, zwalidowania lub naprawienia błędu. Często wystarczą typ zdarzenia, niejawne identyfikatory i dozwolony skrót informacji. Zanim zapiszesz błędy, usuń tokeny, dane uwierzytelniające i pola wrażliwe.
Jeśli pełna treść jest niezbędna do ponownego przetworzenia lub zbadania problemu, określ powód, uprawniony dostęp, szyfrowanie, okres przechowywania i procedurę usuwania. Rozważ przechowywanie treści w osobnym, ograniczonym magazynie i umieszczenie w skrzynce odwołania do niej. Nie zakładaj, że ukrycie pól w interfejsie oznacza ich ochronę w bazie danych, kopiach zapasowych lub logach.
Interfejs, który pomaga podejmować decyzje, a nie tylko przeglądać dane
Widok operacyjny powinien umożliwiać filtrowanie według integracji, typu, stanu, przedziału czasu oraz identyfikatora zewnętrznego lub wewnętrznego. W szczegółach pokaż oś czasu, próby, skrót błędu, odwołania korelacyjne i dostępne działania. Wyraźnie wskazuj, kiedy dane zdarzenie odebrano, a kiedy przetworzono — to różne momenty.
Zapewnij możliwość podjęcia konkretnych działań: poprawienia konfiguracji, zaczekania na zależność, eskalacji do odpowiedzialnego zespołu lub zlecenia ponownego przetwarzania. Jeśli przyczyna wskazuje na problem po stronie dostawcy, interfejs nie powinien przedstawiać lokalnej ponownej próby jako gwarantowanego rozwiązania. Ważne są również metryki i alerty: monitoruj wiek oczekujących zdarzeń, awarie według typu oraz zdarzenia przekraczające ustalony limit prób.
Bezpieczne ponawianie prób i idempotencja
Przycisk ponowienia nie powinien bezpośrednio uruchamiać nieodwracalnej operacji bez kontroli. Zanim na to pozwolisz, sprawdź, czy zdarzenie kwalifikuje się do ponowienia, czy jego stan dopuszcza tę czynność i czy nie trwa równoległe wykonanie. Zapisuj, kto zlecił ponowienie, kiedy i dlaczego oraz jakie wykonanie utworzono. Uprawnienia powinny rozróżniać przeglądanie danych od działań, które mogą wpłynąć na biznes.
Idempotencja chroni przed ponownym dostarczeniem i ponawianiem prób: wielokrotne przetworzenie tego samego zdarzenia nie powinno tworzyć dwóch płatności, zamówień ani powiadomień. Używaj stabilnego klucza dostawcy, jeśli jest wiarygodny, wraz z ograniczeniami unikatowości lub mechanizmami idempotencji na granicy domeny biznesowej. Sama deduplikacja w skrzynce nie gwarantuje, że zewnętrzne wywołanie nie zostanie powtórzone, jeśli proces zakończy się awarią po jego wykonaniu.
Określ limity prób, odstępy między nimi i warunki wstrzymania ponawiania. Niektóre błędy wymagają poprawienia danych lub konfiguracji przed ponownym wykonaniem; inne mają charakter przejściowy. W przypadku operacji wywołujących skutki zewnętrzne określ, jak uzgadniać niepewny wynik — na przykład gdy po wysłaniu żądania, ale przed otrzymaniem potwierdzenia, połączenie zostanie przerwane. Jeśli nie da się ustalić wyniku, eskalacja może być bezpieczniejsza niż ponawianie na ślepo.
Retencja, uprawnienia i identyfikowalność działań
Ustal okres przechowywania odpowiedni do potrzeb zespołu wsparcia i obowiązujących wymogów. Usuwaj lub anonimizuj rekordy, których okres przechowywania upłynął, i sprawdź, czy polityka obejmuje również treści przechowywane osobno oraz kopie zapasowe, zgodnie z ich cyklem życia. Ograniczaj dostęp według roli: możliwość przeglądania zdarzenia nie oznacza prawa do wglądu w jego wrażliwą treść ani do ponownego przetwarzania.
Rejestruj działania administracyjne jako osobne zdarzenia audytowe, niezależne od stanu webhooka: aktora, działanie, datę, powód i wynik. Pozwala to odróżnić informacje wysłane przez dostawcę od działań podjętych przez osobę w narzędziu. Chroń te rekordy przed nieautoryzowanymi zmianami i nie zapisuj sekretów w uzasadnieniach ani komunikatach o błędach.
Lista kontrolna dla istniejącej integracji
- Czy określono, co oznacza poprawna odpowiedź endpointu i kiedy potwierdzany jest trwały zapis?
- Czy stany odzwierciedlają odrębne etapy i istnieje ścieżka obsługi zdarzeń nieprawidłowych oraz zakończonych niepowodzeniem?
- Czy każde zdarzenie można powiązać z zadaniami i logami bez niepotrzebnego powielania informacji?
- Czy zidentyfikowano i ograniczono dane wrażliwe oraz określono zasady dostępu i retencji?
- Czy ponawianie prób uwzględnia uprawnienia, limity, idempotencję i obsługę niepewnych wyników?
- Czy skonfigurowano alerty dotyczące narastających zaległości, uporczywych awarii i zdarzeń wymagających interwencji?
Użyteczna skrzynka skraca czas potrzebny na zrozumienie awarii, ponieważ zachowuje kontekst i pokazuje przebieg zdarzenia. Jej jakość nie zależy od liczby zgromadzonych pól, lecz od tego, czy każda informacja ma cel, każdy stan ma konkretne znaczenie, a każde działanie operacyjne jest bezpieczne i możliwe do prześledzenia.