Когда интеграция дает сбой, ответ на вопрос «что получила наша система?» приходится искать в логах, запросах к базе данных и панелях провайдера. Входящий журнал вебхуков на PHP фиксирует полученные события и их путь внутри системы. Его задача — восстановить, что именно поступило, какие действия предпринимались и что требует внимания, а не заменить все компоненты обработки.
Чтобы правильно спроектировать такой журнал, нужно разделить прием, проверку и выполнение; записывать полезные метаданные, не накапливая чувствительные данные; а также определить, как повторять операцию, не дублируя бизнес-эффекты. Инструмент должен явно показывать границы известных ему сведений: запись о принятом событии не доказывает, что последующая операция завершилась.
Когда нужен входящий журнал
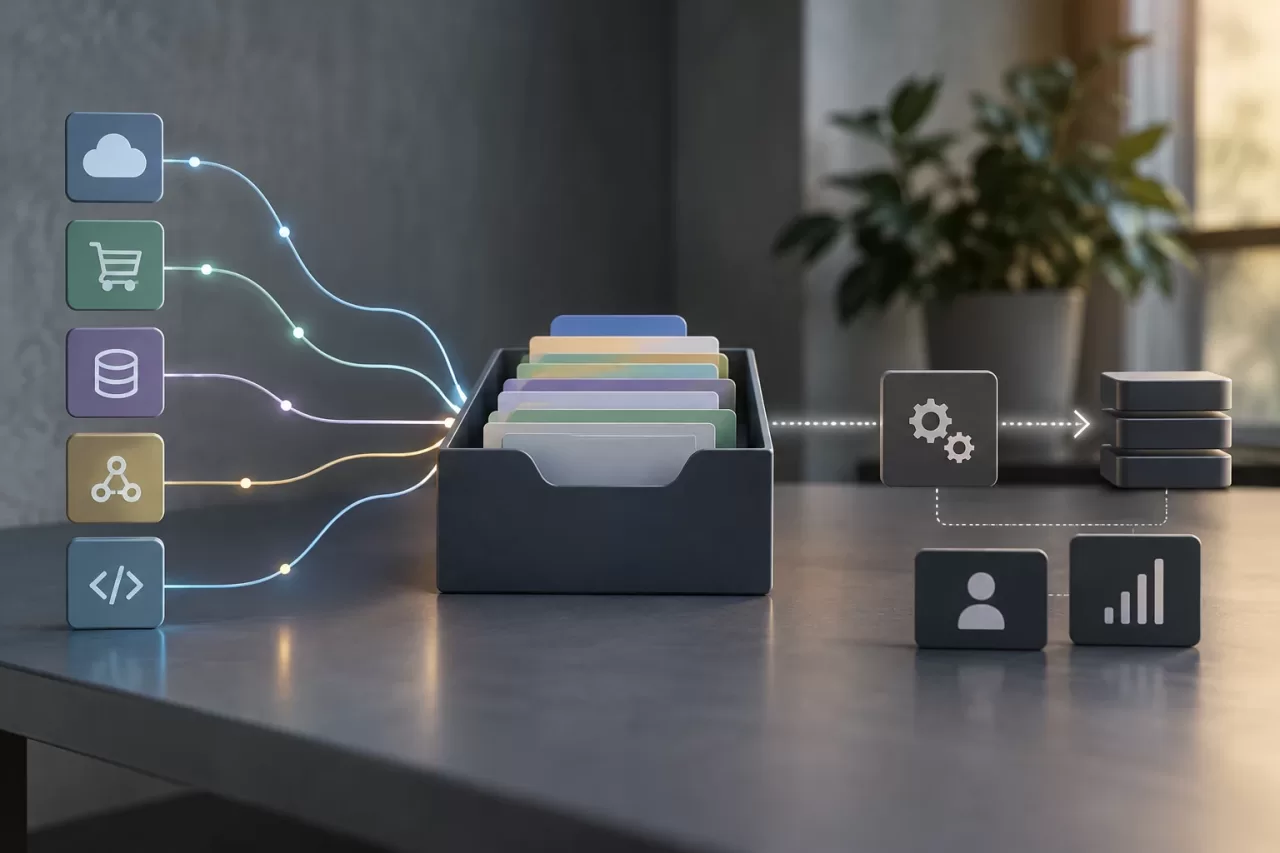
Он может быть полезен, если система получает события от нескольких провайдеров, если периодические сбои трудно воспроизвести или если службе поддержки и инженерам нужно просматривать историю без прямого доступа к production. Журнал также помогает в случаях, когда успешный HTTP-ответ лишь подтверждает получение события, а его обработка продолжается асинхронно.
Создавать собственный интерфейс нужно не всегда. Для простой интеграции с небольшим объемом событий и ошибками, которые уже видны в существующих инструментах, достаточно структурированных логов и оповещений. Прежде чем добавлять журнал, выясните, какую информацию предоставляет провайдер, как долго хранится его история и какими инструментами наблюдаемости пользуется команда. Не создавайте второй источник истины без четкой операционной необходимости.
Журнал также не является очередью задач или системой аудита изменений. Очередь управляет ожидающими задачами, конкурентностью, доступностью и попытками выполнения. Журнал описывает прием событий и их операционное состояние. Аудит фиксирует, кто, что и когда изменил в домене. Эти компоненты можно связывать идентификаторами, но каждый из них отвечает на разные вопросы.
Разделение приема, проверки и обработки
Конечная точка должна проверить требования к передаче и аутентичности, прежде чем принять событие: например, проверить подпись предусмотренным провайдером способом и убедиться, что тело запроса имеет допустимый формат. Затем можно зафиксировать получение события и передать задачу в очередь. Успешный ответ отправителю должен иметь точный смысл, например «получено и сохранено», а не «весь бизнес-процесс завершен».
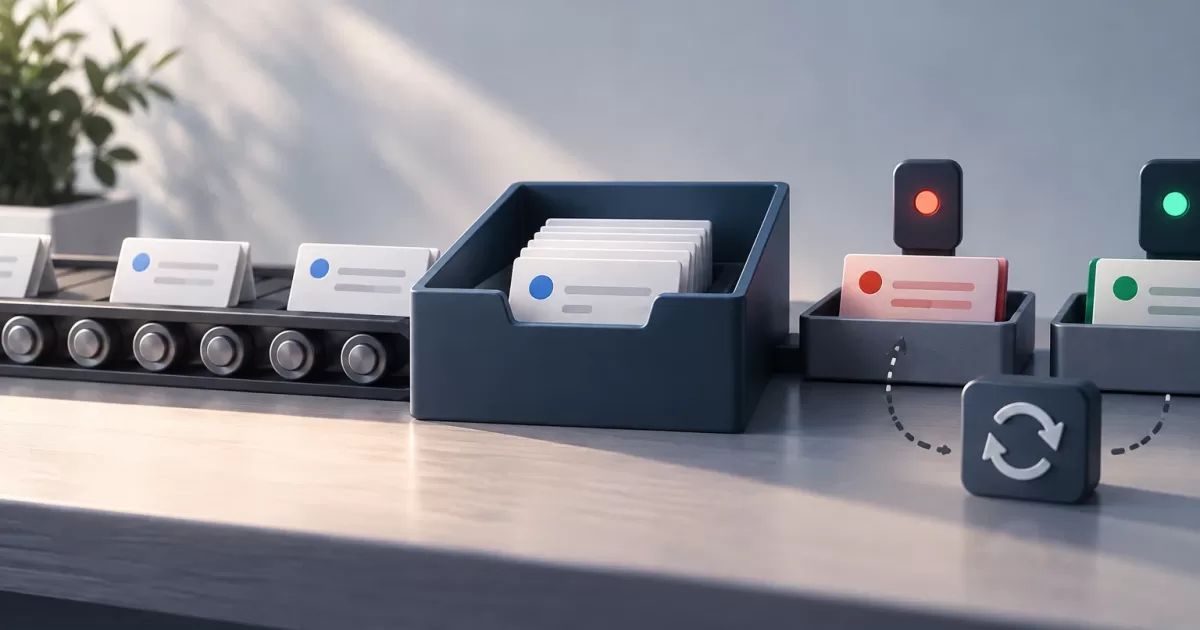
Определите явные статусы и переходы между ними. Возможный набор: received, rejected, queued, processing, processed и failed. Адаптируйте его к реальному процессу: не используйте один статус для недопустимого события и события, обработка которого прервалась из-за временной недоступности зависимости. Фиксируйте время смены статуса и, если уместно, безопасную для диагностики категорию ошибки. Избегайте неоднозначных статусов вроде «завершено», если закончился только один этап.
Если запись сохраняется, а задача публикуется в очередь, учитывайте возможность сбоя между этими операциями. Помочь может шаблон transactional outbox: он позволяет в одной транзакции записать событие и намерение опубликовать его, а затем отправить это намерение в очередь. Однако он не устраняет все сбои: обработчик (консьюмер) по-прежнему должен корректно обрабатывать повторные доставки.
Какие данные записывать для расследования обработки
Спроектируйте запись так, чтобы можно было найти событие и связать между собой этапы его обработки. В зависимости от провайдера и бизнес-процесса включите в нее:
- Внутренний идентификатор записи и идентификатор события у отправителя, если он есть.
- Провайдера, тип события и несекретную ссылку на аккаунт или интеграцию-получателя.
- Время получения, проверки, постановки в очередь и последнего обновления с единым часовым стандартом.
- Текущий статус, число попыток и краткий результат каждой попытки выполнения.
- Идентификаторы корреляции или трассировки, а также ссылки на задачу и связанные записи приложения.
- Полезную для эксплуатации категорию сбоя, например ошибку проверки, недоступность зависимости или бизнес-конфликт.
Передавайте идентификатор корреляции от конечной точки до задачи и вызываемых сервисов. Тогда можно начать с события и проследить выполнение в логах или распределенных трассировках. Не копируйте большие фрагменты логов в запись журнала: сохраняйте ссылки, а подробности за нужный период смотрите в системе наблюдаемости.
Минимизация чувствительных данных на этапе проектирования
Хранить полное содержимое запроса кажется удобным, но это может привести к ненужному хранению персональных данных, секретов или коммерческой информации. Решайте для каждого поля отдельно, нужно ли оно для идентификации события, проверки или устранения сбоя. Часто достаточно типа события, непрозрачных идентификаторов и разрешенного к хранению краткого описания. Удаляйте из логов токены, учетные данные и чувствительные поля до записи ошибок.
Если полное содержимое необходимо для повторной обработки или расследования, определите причину хранения, круг лиц с разрешенным доступом, шифрование, срок хранения и процедуру удаления. Рассмотрите возможность хранить содержимое отдельно, с ограниченным доступом, а в журнале оставить ссылку на него. Не считайте, что скрытие полей в интерфейсе защищает их в базе данных, резервных копиях или логах.
Интерфейс для принятия решений, а не только просмотра
Операционный интерфейс должен позволять фильтровать события по интеграции, типу, статусу, временному интервалу и внешнему или внутреннему идентификатору. В карточке события показывайте хронологию, попытки, краткое описание ошибки, ссылки для корреляции и доступные действия. Четко указывайте, когда данные были получены и когда событие обработано: это разные моменты времени.
Предусмотрите действия, помогающие решить проблему: исправить конфигурацию, дождаться восстановления зависимости, передать вопрос ответственной команде или запросить повторную обработку. Если причина связана с провайдером, интерфейс не должен представлять локальный повторный запуск как гарантированное решение. Важны и метрики с оповещениями: отслеживайте возраст ожидающих событий, сбои по типам и события, превысившие установленный лимит попыток.
Безопасные повторы и идемпотентность
Кнопка повтора не должна без дополнительных проверок запускать необратимую операцию. Прежде чем разрешить повтор, проверьте, подходит ли событие для него, допускает ли текущий статус это действие и не выполняется ли уже параллельная обработка. Фиксируйте, кто, когда и зачем запросил повтор и какой запуск был создан. Права на просмотр должны отличаться от прав на действия, способные повлиять на бизнес-процессы.
Идемпотентность защищает от повторных доставок и запусков: повторная обработка одного и того же события не должна создавать два платежа, заказа или уведомления. Используйте стабильный идентификатор события от провайдера, если ему можно доверять, а также уникальные ограничения или механизмы идемпотентности на границе бизнес-логики. Одной дедупликации во входящем журнале недостаточно, чтобы гарантировать отсутствие повторного внешнего вызова, если процесс завершится сбоем после его выполнения.
Определите лимиты попыток, интервалы ожидания и условия остановки повторов. Для некоторых ошибок перед новым запуском нужно исправить данные или конфигурацию; другие ошибки носят временный характер. Для операций с внешними эффектами предусмотрите способ сверки неопределенного результата — например, если соединение прервалось после отправки запроса, но до получения подтверждения. Если установить результат невозможно, передача ситуации ответственным специалистам может быть безопаснее слепого повтора.
Сроки хранения, права доступа и отслеживание действий
Установите срок хранения с учетом потребностей поддержки и применимых обязательств. Удаляйте записи с истекшим сроком хранения или анонимизируйте их; убедитесь, что политика также охватывает отдельно хранящиеся данные и резервные копии с учетом их жизненного цикла. Ограничьте доступ по ролям: возможность просматривать событие не означает права видеть его чувствительное содержимое или запускать повторную обработку.
Записывайте административные действия в отдельные события аудита, не смешивая их со статусом вебхука: указывайте исполнителя, действие, дату, причину и результат. Это позволяет отличить отправленное провайдером от действий пользователя в инструменте. Защитите эти записи от несанкционированных изменений и не сохраняйте секреты в причинах или сообщениях об ошибках.
Контрольный список для существующей интеграции
- Определено ли, что означает успешный ответ конечной точки и в какой момент подтверждается сохранение данных?
- Отражают ли статусы разные этапы и предусмотрен ли сценарий для недопустимых и неудачно обработанных событий?
- Можно ли связать каждое событие с задачами и логами, не дублируя ненужную информацию?
- Выявлены и минимизированы ли чувствительные данные, определены ли правила доступа и хранения?
- Предусмотрены ли для повторной обработки права доступа, лимиты, идемпотентность и обработка неопределенных результатов?
- Настроены ли оповещения о накоплении событий, постоянных сбоях и событиях, требующих вмешательства?
Полезный входящий журнал сокращает время на выяснение причин сбоя: он сохраняет контекст и показывает путь события. Его качество определяется не количеством полей, а тем, что у каждого поля есть назначение, у каждого статуса — четкий смысл, а каждое операционное действие безопасно и отслеживаемо.