Cuando falla una integración, responder «¿qué recibió nuestra aplicación?» puede exigir buscar entre logs, consultas a la base de datos y paneles del proveedor. Una bandeja de entrada de webhooks en PHP ofrece un registro operativo de los eventos recibidos y de su recorrido dentro del sistema. Su propósito es reconstruir qué llegó, qué se intentó hacer y qué necesita atención, no sustituir todos los componentes de procesamiento.
Diseñarla bien requiere separar recepción, validación y ejecución; registrar metadatos útiles sin acumular datos sensibles; y definir cómo repetir una operación sin duplicar efectos de negocio. La herramienta debe hacer visibles los límites de lo que sabe: registrar que se aceptó un evento no demuestra que el efecto posterior se completara.
Cuándo hace falta una bandeja de entrada
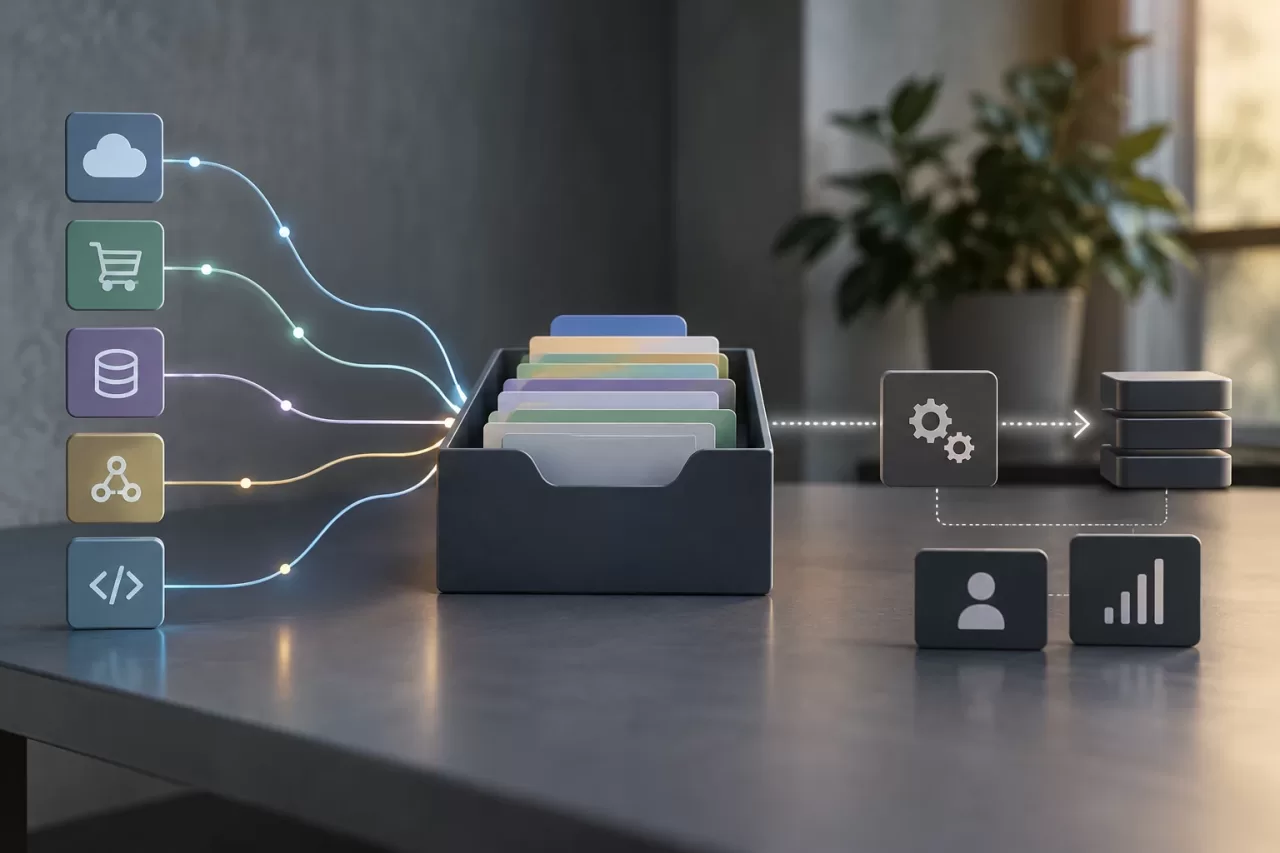
Puede ser útil si un sistema recibe eventos de varios proveedores, si hay fallos intermitentes difíciles de reproducir o si soporte e ingeniería necesitan consultar el historial sin acceso directo a producción. También ayuda cuando una respuesta HTTP correcta solo confirma la recepción, mientras el procesamiento continúa de forma asíncrona.
No siempre hace falta construir una interfaz propia. Para una integración sencilla, con poco volumen y errores ya visibles en herramientas existentes, bastan logs estructurados y alertas. Antes de añadir una bandeja, comprueba qué información ofrece el proveedor, cuánto dura su historial y qué herramientas de observabilidad tiene el equipo. Evita crear una segunda fuente de verdad sin una necesidad operativa clara.
La bandeja tampoco es una cola de trabajos ni un sistema de auditoría de cambios. La cola administra trabajo pendiente, concurrencia, disponibilidad e intentos de ejecución. La bandeja describe la recepción y el estado operativo de eventos. La auditoría registra quién cambió qué y cuándo en el dominio. Pueden relacionarse mediante identificadores, pero cada uno responde preguntas distintas.
Separar recepción, validación y procesamiento
Un endpoint debería verificar los requisitos de transporte y autenticidad antes de aceptar el evento: por ejemplo, validar la firma según el mecanismo del proveedor y comprobar que el cuerpo tiene un formato admisible. Después puede registrar la recepción y derivar el trabajo a una cola. Una respuesta exitosa al emisor debe tener un significado preciso, como «recibido y persistido», no «todo el proceso de negocio terminó».
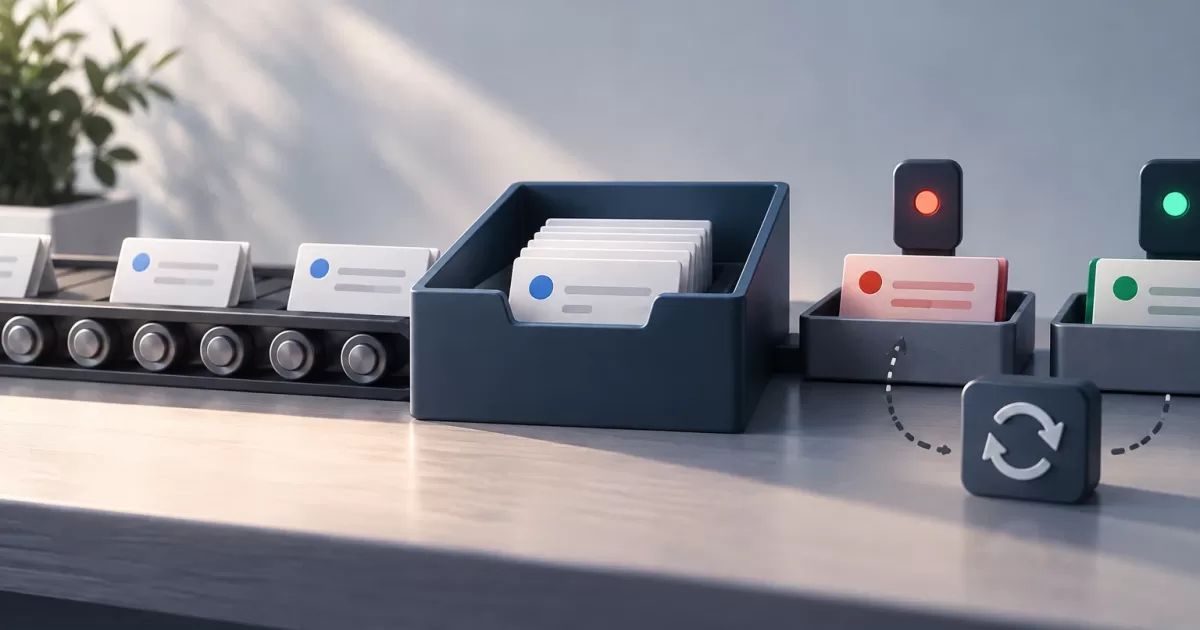
Define estados explícitos y sus transiciones. Un conjunto posible es received, rejected, queued, processing, processed y failed. Adáptalo al flujo real: no uses el mismo estado para un evento inválido y uno que falló por una dependencia temporal. Registra cuándo cambió el estado y, si procede, una categoría de error segura para diagnóstico. Evita estados ambiguos como «completo» si solo terminó una etapa.
Si se guarda el registro y se publica un trabajo en una cola, considera la ventana de fallo entre ambas operaciones. El patrón de outbox transaccional puede ayudar a escribir el evento y la intención de publicar en una misma transacción, y luego despachar esa intención. No elimina todos los fallos: el consumidor todavía necesita tolerar entregas repetidas.
Qué registrar para investigar el recorrido
Diseña un registro que permita encontrar un evento y conectar sus pasos. Según el proveedor y el negocio, incluye:
- Un identificador interno del registro y el identificador del evento del emisor, si existe.
- El proveedor, el tipo de evento y una referencia no sensible a la cuenta o integración receptora.
- Fechas de recepción, validación, encolado y última actualización, con una convención horaria consistente.
- Estado actual, número de intentos y resultado resumido de cada ejecución.
- Identificadores de correlación o traza, además de referencias al trabajo y a los registros de aplicación relacionados.
- Una categoría de fallo útil para operar, como error de validación, dependencia no disponible o conflicto de negocio.
Conserva el identificador de correlación desde el endpoint hasta el trabajo y los servicios llamados. Así, una persona puede partir del evento y seguir la ejecución en logs o trazas distribuidas. No copies grandes bloques de logs dentro del registro de bandeja: guarda referencias y consulta el sistema de observabilidad para el detalle temporal.
Minimizar datos sensibles desde el diseño
Guardar siempre la carga completa parece práctico, pero puede retener datos personales, secretos o información comercial sin necesidad. Decide campo por campo qué se necesita para identificar, validar o reparar un fallo. A menudo bastan el tipo de evento, identificadores opacos y un resumen permitido. Redacta tokens, credenciales y campos sensibles antes de registrar errores.
Si la carga completa es imprescindible para una repetición o investigación, define la razón, el acceso autorizado, el cifrado, el plazo de retención y el procedimiento de eliminación. Considera guardar el contenido en almacenamiento separado y restringido, con una referencia desde la bandeja. No asumas que ocultar campos en la interfaz equivale a protegerlos en la base de datos, copias de seguridad o logs.
Una interfaz para decidir, no solo para consultar
La vista operativa debería permitir filtrar por integración, tipo, estado, intervalo temporal e identificador externo o interno. En el detalle, muestra la cronología, los intentos, el error resumido, las referencias de correlación y las acciones disponibles. Indica claramente cuándo el dato se recibió y cuándo se procesó; son momentos distintos.
Ofrece una salida accionable: corregir configuración, esperar una dependencia, escalar al equipo responsable o solicitar un nuevo procesamiento. Si la causa apunta al proveedor, la interfaz no debe presentar un reintento local como solución garantizada. Las métricas y alertas también importan: vigila antigüedad de eventos pendientes, fallos por tipo y eventos que superan el umbral de intentos definido.
Reintentos seguros e idempotencia
Un botón de reintento no debe ejecutar directamente una operación irreversible sin controles. Antes de permitirlo, comprueba que el evento es elegible, que su estado admite la acción y que no hay una ejecución concurrente. Registra quién pidió el reintento, cuándo, por qué y qué ejecución se creó. Los permisos deben distinguir consulta de acciones que puedan afectar al negocio.
La idempotencia protege frente a entregas repetidas y reintentos: el mismo evento no debería crear dos pagos, pedidos o notificaciones si se procesa más de una vez. Usa una clave estable del proveedor cuando sea fiable, junto con restricciones únicas o mecanismos idempotentes en la frontera de negocio. La deduplicación en la bandeja, por sí sola, no garantiza que una llamada externa no se repita si el proceso falla después de ejecutarla.
Define límites de intentos, pausas y condiciones para detener la repetición. Algunos errores requieren corregir datos o configuración antes de volver a ejecutar; otros son transitorios. Para operaciones con efectos externos, establece cómo reconciliar un resultado incierto, por ejemplo cuando la conexión se interrumpe tras enviar una solicitud pero antes de recibir confirmación. Si no puede determinarse el resultado, escalar puede ser más seguro que reintentar a ciegas.
Retención, permisos y trazabilidad de acciones
Establece un periodo de conservación acorde con la necesidad de soporte y las obligaciones aplicables. Elimina o anonimiza registros vencidos y verifica que la política cubre también cargas separadas y copias de seguridad según su ciclo de vida. Restringe el acceso por función: consultar un evento no implica poder ver su contenido sensible ni volver a procesarlo.
Registra las acciones administrativas como eventos de auditoría separados del estado del webhook: actor, acción, fecha, motivo y resultado. Así se distingue lo que envió el proveedor de lo que hizo una persona desde la herramienta. Protege estos registros frente a modificaciones no autorizadas y evita guardar secretos dentro de los motivos o mensajes de error.
Lista de comprobación para una integración existente
- ¿Está definido qué significa una respuesta exitosa del endpoint y cuándo se confirma la persistencia?
- ¿Los estados reflejan etapas distintas y existe una ruta para eventos inválidos y fallidos?
- ¿Cada evento puede correlacionarse con trabajos y logs sin duplicar información innecesaria?
- ¿Se han identificado y minimizado datos sensibles, con acceso y retención definidos?
- ¿La repetición tiene permisos, límites, idempotencia y tratamiento de resultados inciertos?
- ¿Hay alertas para acumulación, fallos persistentes y eventos que requieren intervención?
Una bandeja útil reduce el tiempo que se tarda en entender un fallo porque conserva contexto y hace visible el recorrido. Su calidad no depende de acumular campos, sino de que cada dato tenga un propósito, cada estado signifique algo y cada acción operativa sea segura y trazable.