Quando un’integrazione non funziona, rispondere alla domanda «che cosa ha ricevuto la nostra applicazione?» può richiedere ricerche tra log, query al database e dashboard del provider. Un’inbox per webhook in PHP offre un registro operativo degli eventi ricevuti e del loro percorso all’interno del sistema. Il suo scopo è ricostruire che cosa è arrivato, che cosa si è tentato di fare e che cosa richiede attenzione, non sostituire tutti i componenti di elaborazione.
Per progettarla bene occorre separare ricezione, validazione ed esecuzione; registrare metadati utili senza accumulare dati sensibili; e definire come ripetere un’operazione senza duplicare gli effetti di business. Lo strumento deve rendere visibili i limiti di ciò che sa: registrare che un evento è stato accettato non dimostra che l’effetto successivo sia stato completato.
Quando serve un’inbox
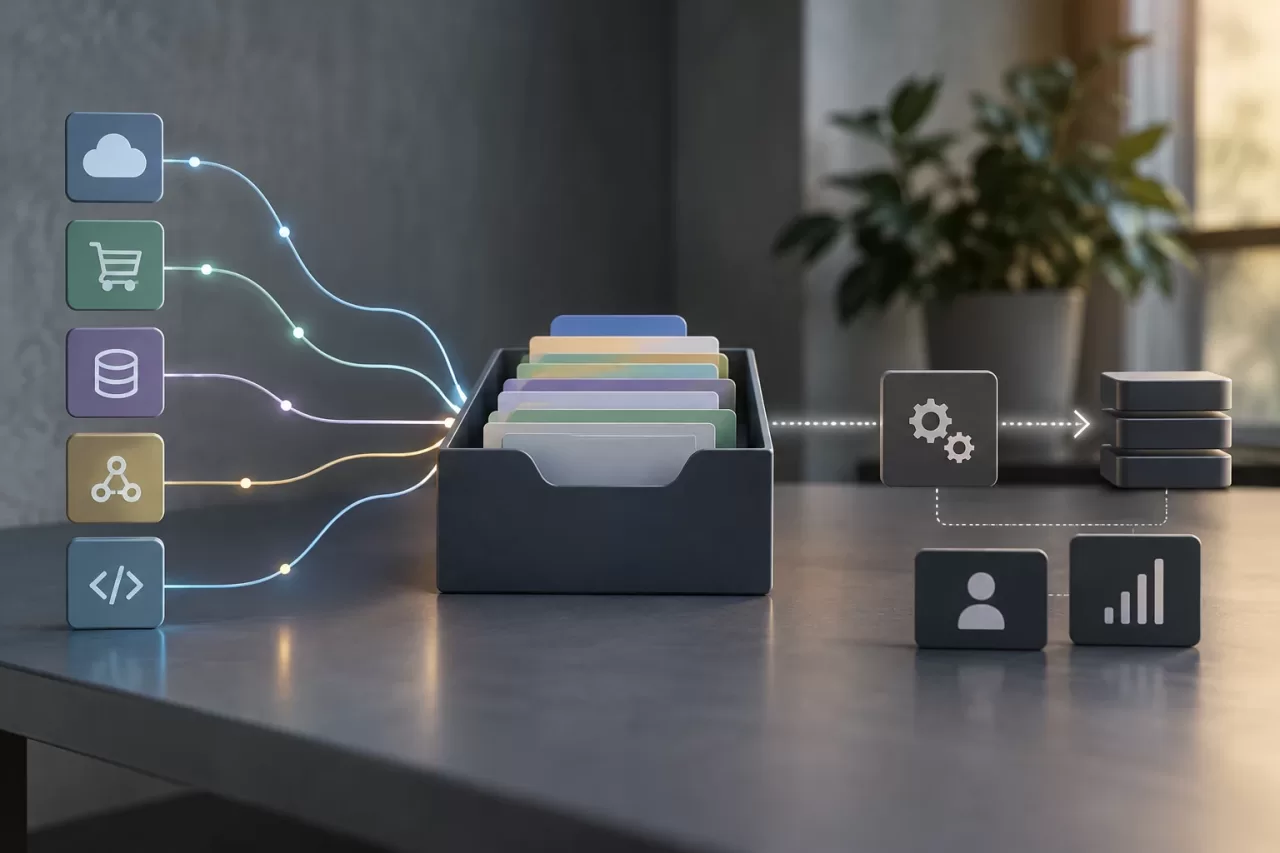
Può essere utile se un sistema riceve eventi da più provider, se si verificano errori intermittenti difficili da riprodurre o se i team di supporto e ingegneria devono consultare la cronologia senza accesso diretto alla produzione. È utile anche quando una risposta HTTP corretta conferma solo la ricezione, mentre l’elaborazione prosegue in modo asincrono.
Non è sempre necessario creare un’interfaccia dedicata. Per un’integrazione semplice, con volumi ridotti ed errori già visibili negli strumenti esistenti, possono bastare log strutturati e avvisi. Prima di aggiungere un’inbox, verifica quali informazioni offre il provider, per quanto tempo conserva la cronologia e quali strumenti di osservabilità usa il team. Evita di creare una seconda fonte di verità senza una chiara necessità operativa.
L’inbox non è nemmeno una coda di job né un sistema di audit delle modifiche. La coda gestisce il lavoro in sospeso, la concorrenza, la disponibilità e i tentativi di esecuzione. L’inbox descrive la ricezione e lo stato operativo degli eventi. L’audit registra chi ha modificato cosa e quando nel dominio applicativo. I tre componenti possono essere collegati tramite identificatori, ma rispondono a domande diverse.
Separare ricezione, validazione ed elaborazione
Prima di accettare l’evento, un endpoint dovrebbe verificare i requisiti di trasporto e autenticità: per esempio, validare la firma secondo il meccanismo del provider e controllare che il corpo della richiesta abbia un formato ammesso. In seguito può registrare la ricezione e inviare il lavoro a una coda. Una risposta positiva al mittente deve avere un significato preciso, come «ricevuto e salvato», non «l’intero processo di business è terminato».
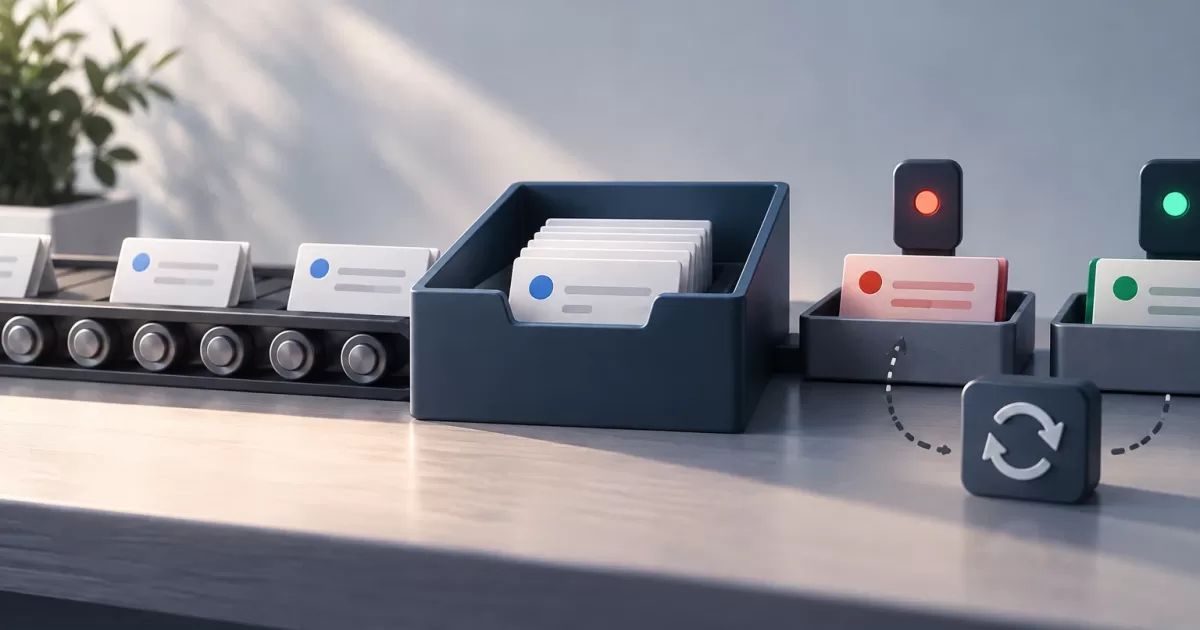
Definisci stati espliciti e le relative transizioni. Un possibile insieme è received, rejected, queued, processing, processed e failed. Adattalo al flusso effettivo: non usare lo stesso stato per un evento non valido e per uno non riuscito a causa di una dipendenza temporaneamente indisponibile. Registra quando è cambiato lo stato e, se opportuno, una categoria di errore sicura per la diagnosi. Evita stati ambigui come «completato» se si è conclusa solo una fase.
Se il record viene salvato e un job viene pubblicato in una coda, considera la finestra di errore tra le due operazioni. Il pattern transactional outbox può aiutare a scrivere l’evento e l’intenzione di pubblicarlo nella stessa transazione, per poi inviare tale intenzione. Non elimina tutti gli errori: il consumer deve comunque tollerare le consegne ripetute.
Che cosa registrare per ricostruire il percorso
Progetta un record che permetta di trovare un evento e collegarne le varie fasi. A seconda del provider e del business, includi:
- Un identificatore interno del record e l’identificatore dell’evento del mittente, se presente.
- Il provider, il tipo di evento e un riferimento non sensibile all’account o all’integrazione destinataria.
- Le date di ricezione, validazione, accodamento e ultimo aggiornamento, usando una convenzione oraria coerente.
- Lo stato attuale, il numero di tentativi e un riepilogo dell’esito di ogni esecuzione.
- Gli identificatori di correlazione o di trace, oltre ai riferimenti al job e ai record applicativi correlati.
- Una categoria di errore utile per la gestione operativa, come errore di validazione, dipendenza non disponibile o conflitto di business.
Conserva l’identificatore di correlazione dall’endpoint fino al job e ai servizi invocati. In questo modo, è possibile partire dall’evento e seguire l’esecuzione nei log o nelle trace distribuite. Non copiare grandi blocchi di log nel record dell’inbox: salva i riferimenti e consulta il sistema di osservabilità per i dettagli temporali.
Ridurre al minimo i dati sensibili fin dalla progettazione
Salvare sempre il payload completo sembra pratico, ma può comportare la conservazione non necessaria di dati personali, segreti o informazioni commerciali. Decidi campo per campo che cosa serve per identificare, validare o correggere un errore. Spesso bastano il tipo di evento, identificatori opachi e un riepilogo consentito. Oscura token, credenziali e campi sensibili prima di registrare gli errori.
Se il payload completo è indispensabile per un nuovo tentativo o un’indagine, definisci la motivazione, gli accessi autorizzati, la cifratura, il periodo di conservazione e la procedura di eliminazione. Valuta di salvare il contenuto in uno storage separato e con accesso ristretto, mantenendone un riferimento nell’inbox. Non dare per scontato che nascondere i campi nell’interfaccia equivalga a proteggerli nel database, nei backup o nei log.
Un’interfaccia per decidere, non solo consultare
La vista operativa dovrebbe consentire di filtrare per integrazione, tipo, stato, intervallo temporale e identificatore esterno o interno. Nel dettaglio, mostra la cronologia, i tentativi, il riepilogo dell’errore, i riferimenti di correlazione e le azioni disponibili. Indica chiaramente quando il dato è stato ricevuto e quando è stato elaborato: sono momenti distinti.
Offri un percorso che consenta di agire: correggere la configurazione, attendere che una dipendenza torni disponibile, coinvolgere il team responsabile o richiedere una nuova elaborazione. Se la causa sembra dipendere dal provider, l’interfaccia non deve presentare un nuovo tentativo locale come una soluzione garantita. Contano anche metriche e avvisi: monitora l’età degli eventi in sospeso, gli errori per tipo e gli eventi che superano la soglia di tentativi definita.
Nuovi tentativi sicuri e idempotenza
Un pulsante per ripetere un’operazione non deve avviare direttamente un’azione irreversibile senza controlli. Prima di consentirlo, verifica che l’evento sia idoneo, che il suo stato permetta l’azione e che non sia già in corso un’esecuzione concorrente. Registra chi ha richiesto il nuovo tentativo, quando, perché e quale esecuzione è stata creata. Le autorizzazioni devono distinguere la consultazione dalle azioni che possono avere effetti sul business.
L’idempotenza protegge dalle consegne ripetute e dai nuovi tentativi: lo stesso evento non dovrebbe creare due pagamenti, ordini o notifiche se viene elaborato più di una volta. Usa una chiave stabile del provider, se affidabile, insieme a vincoli univoci o meccanismi idempotenti nel punto di ingresso del dominio applicativo. La deduplicazione nell’inbox, da sola, non garantisce che una chiamata esterna non venga ripetuta se il processo fallisce dopo averla eseguita.
Definisci i limiti dei tentativi, gli intervalli di attesa e le condizioni per interrompere la ripetizione. Per alcuni errori occorre correggere i dati o la configurazione prima di eseguire di nuovo l’operazione; altri sono transitori. Per le operazioni con effetti esterni, stabilisci come riconciliare un esito incerto, per esempio quando la connessione si interrompe dopo l’invio di una richiesta ma prima della conferma. Se non è possibile determinare l’esito, coinvolgere il team responsabile può essere più sicuro che riprovare alla cieca.
Conservazione, autorizzazioni e tracciabilità delle azioni
Stabilisci un periodo di conservazione adeguato alle esigenze di supporto e agli obblighi applicabili. Elimina o anonimizza i record scaduti e verifica che la policy includa anche i payload separati e i backup, in base al loro ciclo di vita. Limita gli accessi in base al ruolo: poter consultare un evento non implica poter vedere i suoi contenuti sensibili o richiederne una nuova elaborazione.
Registra le azioni amministrative come eventi di audit separati dallo stato del webhook: attore, azione, data, motivazione ed esito. In questo modo è possibile distinguere ciò che ha inviato il provider da ciò che una persona ha fatto tramite lo strumento. Proteggi questi record da modifiche non autorizzate ed evita di includere segreti nelle motivazioni o nei messaggi di errore.
Lista di controllo per un’integrazione esistente
- È stato definito il significato di una risposta positiva dell’endpoint e il momento in cui viene confermato il salvataggio?
- Gli stati rappresentano fasi diverse ed esiste un percorso per gli eventi non validi e non riusciti?
- È possibile correlare ogni evento con i job e i log senza duplicare informazioni non necessarie?
- I dati sensibili sono stati identificati e ridotti al minimo, con accessi e conservazione definiti?
- I nuovi tentativi prevedono autorizzazioni, limiti, idempotenza e gestione degli esiti incerti?
- Sono presenti avvisi per gli accumuli, gli errori persistenti e gli eventi che richiedono un intervento?
Un’inbox utile riduce il tempo necessario per comprendere un errore, perché conserva il contesto e rende visibile il percorso. La sua qualità non dipende dall’accumulo di campi, ma dal fatto che ogni dato abbia uno scopo, ogni stato abbia un significato e ogni azione operativa sia sicura e tracciabile.