Wenn eine Integration fehlschlägt, kann die Antwort auf die Frage „Was hat unsere Anwendung empfangen?“ eine Suche in Logs, Datenbankabfragen und Anbieter-Dashboards erfordern. Ein Webhook-Posteingang in PHP bietet ein operatives Register der empfangenen Ereignisse und ihres Wegs durch das System. Sein Zweck ist es, nachvollziehen zu können, was eingegangen ist, was versucht wurde und was Aufmerksamkeit erfordert – nicht, sämtliche Verarbeitungskomponenten zu ersetzen.
Für einen guten Entwurf müssen Empfang, Validierung und Ausführung getrennt werden, nützliche Metadaten erfasst werden, ohne sensible Daten anzuhäufen, und es muss festgelegt werden, wie ein Vorgang wiederholt werden kann, ohne Geschäftseffekte zu duplizieren. Das Tool muss die Grenzen dessen, was es weiß, sichtbar machen: Die Erfassung, dass ein Ereignis angenommen wurde, beweist nicht, dass der nachgelagerte Effekt abgeschlossen wurde.
Wann ein Posteingang benötigt wird
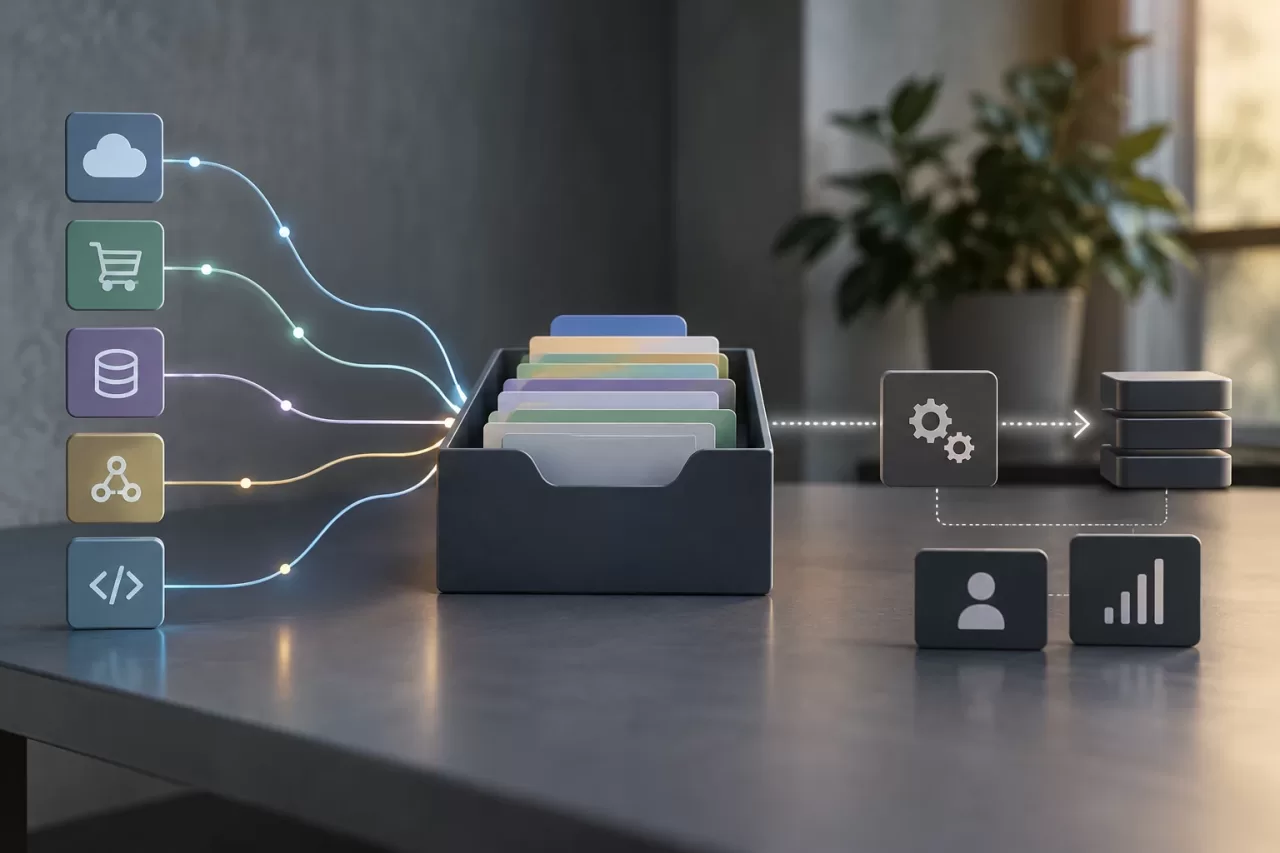
Ein Posteingang kann nützlich sein, wenn ein System Ereignisse von mehreren Anbietern empfängt, wenn intermittierende Fehler schwer zu reproduzieren sind oder wenn Support und Engineering den Verlauf ohne direkten Zugriff auf die Produktionsumgebung einsehen müssen. Er ist auch hilfreich, wenn eine erfolgreiche HTTP-Antwort lediglich den Empfang bestätigt, während die Verarbeitung asynchron weiterläuft.
Es ist nicht immer erforderlich, eine eigene Benutzeroberfläche zu entwickeln. Bei einer einfachen Integration mit geringem Volumen und Fehlern, die in vorhandenen Tools bereits sichtbar sind, reichen strukturierte Logs und Alerts aus. Prüfen Sie vor dem Hinzufügen eines Posteingangs, welche Informationen der Anbieter bereitstellt, wie lange sein Verlauf verfügbar ist und welche Observability-Tools dem Team zur Verfügung stehen. Vermeiden Sie eine zweite Quelle der Wahrheit, wenn kein klarer betrieblicher Bedarf dafür besteht.
Der Posteingang ist auch keine Job-Warteschlange und kein Audit-System für Änderungen. Die Warteschlange verwaltet ausstehende Arbeit, Parallelität, Verfügbarkeit und Ausführungsversuche. Der Posteingang beschreibt den Empfang und den operativen Status von Ereignissen. Das Audit protokolliert, wer wann was im Domänenmodell geändert hat. Die Komponenten können über IDs miteinander verknüpft werden, beantworten aber unterschiedliche Fragen.
Empfang, Validierung und Verarbeitung trennen
Ein Endpoint sollte die Transport- und Authentizitätsanforderungen prüfen, bevor er das Ereignis annimmt: beispielsweise die Signatur anhand des Verfahrens des Anbieters validieren und überprüfen, ob der Body ein zulässiges Format hat. Anschließend kann er den Empfang protokollieren und die Arbeit an eine Warteschlange weitergeben. Eine erfolgreiche Antwort an den Absender muss eine präzise Bedeutung haben, etwa „empfangen und persistiert“, nicht „der gesamte Geschäftsprozess ist abgeschlossen“.
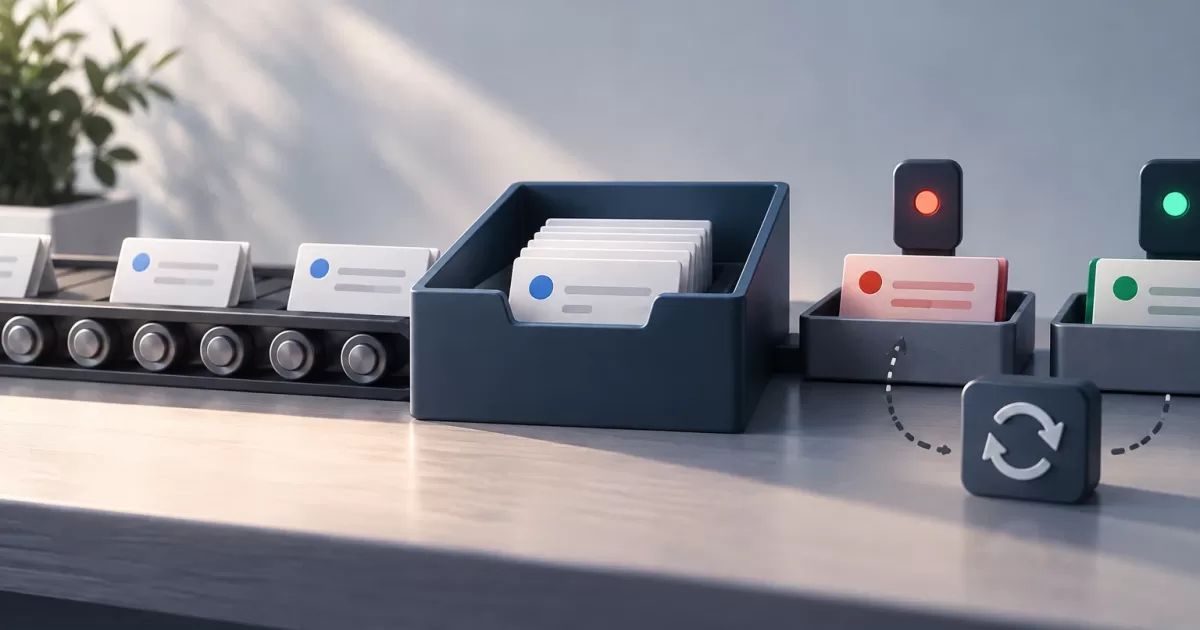
Legen Sie eindeutige Statuswerte und ihre Übergänge fest. Ein mögliches Set ist received, rejected, queued, processing, processed und failed. Passen Sie es an den tatsächlichen Ablauf an: Verwenden Sie nicht denselben Status für ein ungültiges Ereignis und eines, dessen Verarbeitung wegen einer vorübergehend nicht verfügbaren Abhängigkeit fehlgeschlagen ist. Protokollieren Sie, wann sich der Status geändert hat, und gegebenenfalls eine sichere Fehlerkategorie zur Diagnose. Vermeiden Sie mehrdeutige Statuswerte wie „abgeschlossen“, wenn nur ein Verarbeitungsschritt beendet wurde.
Wenn der Datensatz gespeichert und ein Job in eine Warteschlange gestellt wird, berücksichtigen Sie das Fehlerfenster zwischen diesen beiden Vorgängen. Das transaktionale Outbox-Pattern kann dabei helfen, das Ereignis und die Absicht zur Veröffentlichung in derselben Transaktion zu schreiben und diese Absicht anschließend zu übermitteln. Es beseitigt nicht alle Fehler: Der Consumer muss weiterhin wiederholte Zustellungen tolerieren.
Welche Daten für die Untersuchung des Ablaufs erfasst werden sollten
Entwerfen Sie einen Datensatz, mit dem sich ein Ereignis finden und seine einzelnen Schritte verknüpfen lassen. Erfassen Sie je nach Anbieter und Geschäftsbereich Folgendes:
- Eine interne ID des Datensatzes und, falls vorhanden, die Ereignis-ID des Absenders.
- Den Anbieter, den Ereignistyp und eine nicht sensible Referenz auf das empfangende Konto oder die Integration.
- Zeitpunkte für Empfang, Validierung, Einreihung in die Warteschlange und letzte Aktualisierung, mit einer einheitlichen Zeitzonenkonvention.
- Den aktuellen Status, die Anzahl der Versuche und eine zusammengefasste Darstellung des Ergebnisses jeder Ausführung.
- Korrelations- oder Trace-IDs sowie Referenzen auf den Job und zugehörige Anwendungsdatensätze.
- Eine für den Betrieb nützliche Fehlerkategorie, etwa Validierungsfehler, nicht verfügbare Abhängigkeit oder Geschäftskonflikt.
Übernehmen Sie die Korrelations-ID vom Endpoint bis zum Job und zu den aufgerufenen Services. So kann eine Person beim Ereignis beginnen und die Ausführung in Logs oder verteilten Traces verfolgen. Kopieren Sie keine großen Log-Blöcke in den Posteingangsdatensatz: Speichern Sie Referenzen und rufen Sie die Details zum zeitlichen Ablauf im Observability-System ab.
Sensible Daten von Anfang an minimieren
Die vollständige Payload immer zu speichern, erscheint praktisch, kann jedoch unnötig personenbezogene Daten, Geheimnisse oder Geschäftsinformationen aufbewahren. Entscheiden Sie für jedes Feld einzeln, ob es zur Identifizierung, Validierung oder Behebung eines Fehlers benötigt wird. Oft genügen der Ereignistyp, opake IDs und eine zulässige Zusammenfassung. Schwärzen Sie Tokens, Zugangsdaten und sensible Felder, bevor Sie Fehler protokollieren.
Wenn die vollständige Payload für eine Wiederholung oder Untersuchung unverzichtbar ist, legen Sie den Grund, den autorisierten Zugriff, die Verschlüsselung, die Aufbewahrungsfrist und das Löschverfahren fest. Erwägen Sie, den Inhalt in einem separaten, zugriffsbeschränkten Speicher abzulegen und vom Posteingang aus darauf zu verweisen. Gehen Sie nicht davon aus, dass das Ausblenden von Feldern in der Benutzeroberfläche sie auch in der Datenbank, in Backups oder Logs schützt.
Eine Benutzeroberfläche, die Entscheidungen ermöglicht – nicht nur Abfragen
Die operative Ansicht sollte Filter nach Integration, Typ, Status, Zeitraum sowie externer oder interner ID ermöglichen. In der Detailansicht sollten der zeitliche Ablauf, die Versuche, der zusammengefasste Fehler, Korrelationsreferenzen und verfügbare Aktionen angezeigt werden. Machen Sie deutlich, wann die Daten empfangen und wann sie verarbeitet wurden – das sind unterschiedliche Zeitpunkte.
Bieten Sie eine umsetzbare Option: Konfiguration korrigieren, auf eine Abhängigkeit warten, an das zuständige Team eskalieren oder eine erneute Verarbeitung anfordern. Wenn die Ursache beim Anbieter liegt, darf die Benutzeroberfläche einen lokalen Wiederholungsversuch nicht als garantierte Lösung darstellen. Auch Metriken und Alerts sind wichtig: Überwachen Sie das Alter ausstehender Ereignisse, Fehler nach Typ und Ereignisse, die den festgelegten Schwellenwert für Versuche überschreiten.
Sichere Wiederholungen und Idempotenz
Eine Schaltfläche zum Wiederholen darf nicht ohne Schutzmaßnahmen direkt einen unumkehrbaren Vorgang ausführen. Prüfen Sie vor der Freigabe, ob das Ereignis dafür infrage kommt, ob sein Status die Aktion zulässt und ob keine parallele Ausführung stattfindet. Protokollieren Sie, wer die Wiederholung angefordert hat, wann und warum dies geschah und welche Ausführung dadurch angelegt wurde. Bei Berechtigungen sollte zwischen dem Anzeigen von Daten und Aktionen mit möglichen Geschäftsauswirkungen unterschieden werden.
Idempotenz schützt vor wiederholten Zustellungen und Wiederholungsversuchen: Dasselbe Ereignis sollte nicht zwei Zahlungen, Bestellungen oder Benachrichtigungen auslösen, wenn es mehr als einmal verarbeitet wird. Verwenden Sie einen stabilen Schlüssel des Anbieters, sofern dieser zuverlässig ist, zusammen mit eindeutigen Einschränkungen oder idempotenten Mechanismen an der Geschäftsgrenze. Eine Deduplizierung im Posteingang allein garantiert nicht, dass ein externer Aufruf nicht wiederholt wird, wenn der Prozess nach seiner Ausführung fehlschlägt.
Legen Sie Höchstzahlen für Versuche, Wartezeiten und Bedingungen fest, unter denen Wiederholungen beendet werden. Bei manchen Fehlern müssen Daten oder Konfiguration korrigiert werden, bevor die Ausführung erneut gestartet wird; andere sind vorübergehend. Legen Sie bei Vorgängen mit externen Auswirkungen fest, wie ein ungewisses Ergebnis abgeglichen wird, zum Beispiel wenn die Verbindung nach dem Senden einer Anfrage, aber vor dem Empfang einer Bestätigung abbricht. Lässt sich das Ergebnis nicht feststellen, kann eine Eskalation sicherer sein als ein blinder Wiederholungsversuch.
Aufbewahrung, Berechtigungen und Nachvollziehbarkeit von Aktionen
Legen Sie eine Aufbewahrungsfrist fest, die dem Supportbedarf und den geltenden Verpflichtungen entspricht. Löschen oder anonymisieren Sie abgelaufene Datensätze und überprüfen Sie, ob die Richtlinie auch separate Payloads und Backups gemäß ihrem Lebenszyklus abdeckt. Beschränken Sie den Zugriff rollenbasiert: Ein Ereignis anzeigen zu können bedeutet nicht automatisch, seinen sensiblen Inhalt einsehen oder es erneut verarbeiten zu dürfen.
Protokollieren Sie administrative Aktionen als separate Audit-Ereignisse und nicht als Status des Webhooks: Akteur, Aktion, Zeitpunkt, Grund und Ergebnis. So lässt sich unterscheiden, was der Anbieter gesendet hat und was eine Person über das Tool getan hat. Schützen Sie diese Datensätze vor unbefugten Änderungen und speichern Sie keine Geheimnisse in Begründungen oder Fehlermeldungen.
Checkliste für eine bestehende Integration
- Ist festgelegt, was eine erfolgreiche Antwort des Endpoints bedeutet und wann die Persistierung bestätigt wird?
- Spiegeln die Statuswerte unterschiedliche Verarbeitungsschritte wider, und gibt es einen Ablauf für ungültige und fehlgeschlagene Ereignisse?
- Lässt sich jedes Ereignis mit Jobs und Logs korrelieren, ohne unnötige Informationen zu duplizieren?
- Wurden sensible Daten identifiziert und minimiert und Zugriff sowie Aufbewahrung festgelegt?
- Sind für Wiederholungen Berechtigungen, Grenzen, Idempotenz und der Umgang mit ungewissen Ergebnissen definiert?
- Gibt es Alerts für Rückstände, anhaltende Fehler und Ereignisse, die ein Eingreifen erfordern?
Ein nützlicher Posteingang verkürzt die Zeit, die zum Verständnis eines Fehlers benötigt wird, weil er Kontext bewahrt und den Ablauf sichtbar macht. Seine Qualität hängt nicht davon ab, möglichst viele Felder anzuhäufen, sondern davon, dass jedes Datenfeld einen Zweck hat, jeder Status eine Bedeutung und jede operative Aktion sicher und nachvollziehbar ist.