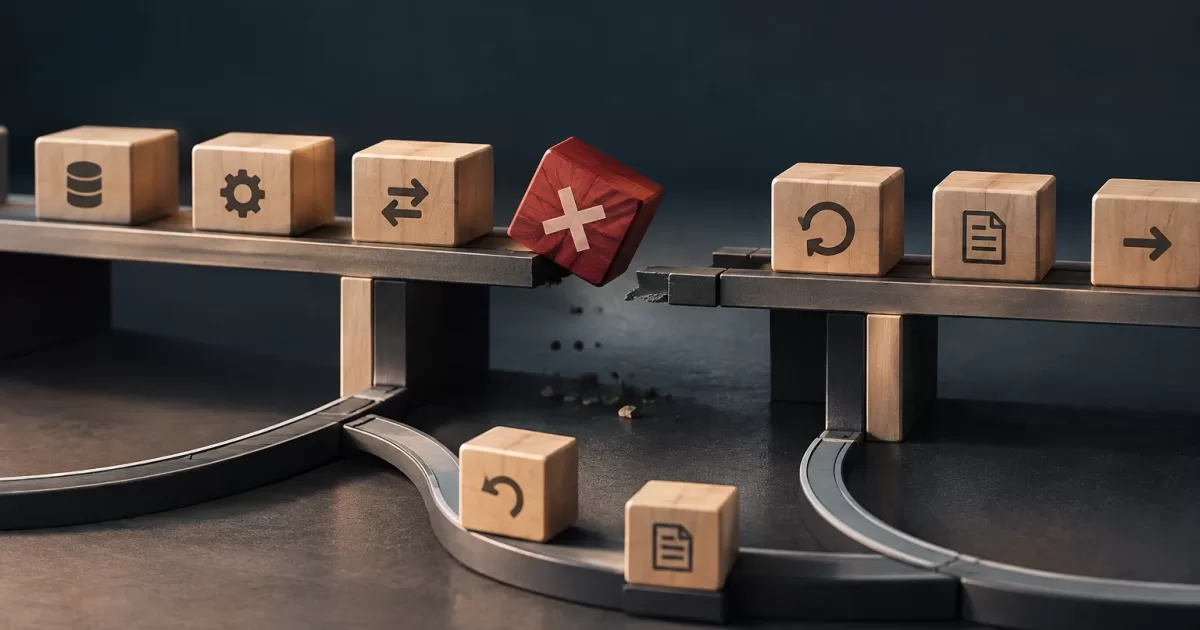
Un proceso de negocio puede completar una parte de su trabajo y fallar antes de terminar. Por ejemplo, una aplicación PHP crea una cuenta en su base de datos, pero no consigue aprovisionarla en un servicio externo. En ese momento, repetir el flujo sin más puede duplicar efectos; darlo por fallido puede dejar sistemas incoherentes. Las compensaciones en procesos distribuidos con PHP permiten definir cómo responder a estos resultados parciales, sin asumir que varios sistemas participan en una única transacción atómica.
La decisión importante no es solo cómo deshacer lo ocurrido. Algunos efectos no se pueden revertir exactamente, y una compensación también puede fallar. El diseño debe hacer visible el estado real de la operación, permitir recuperarla y señalar cuándo se necesita intervención humana.
Transacciones locales, reintentos y compensaciones resuelven problemas distintos
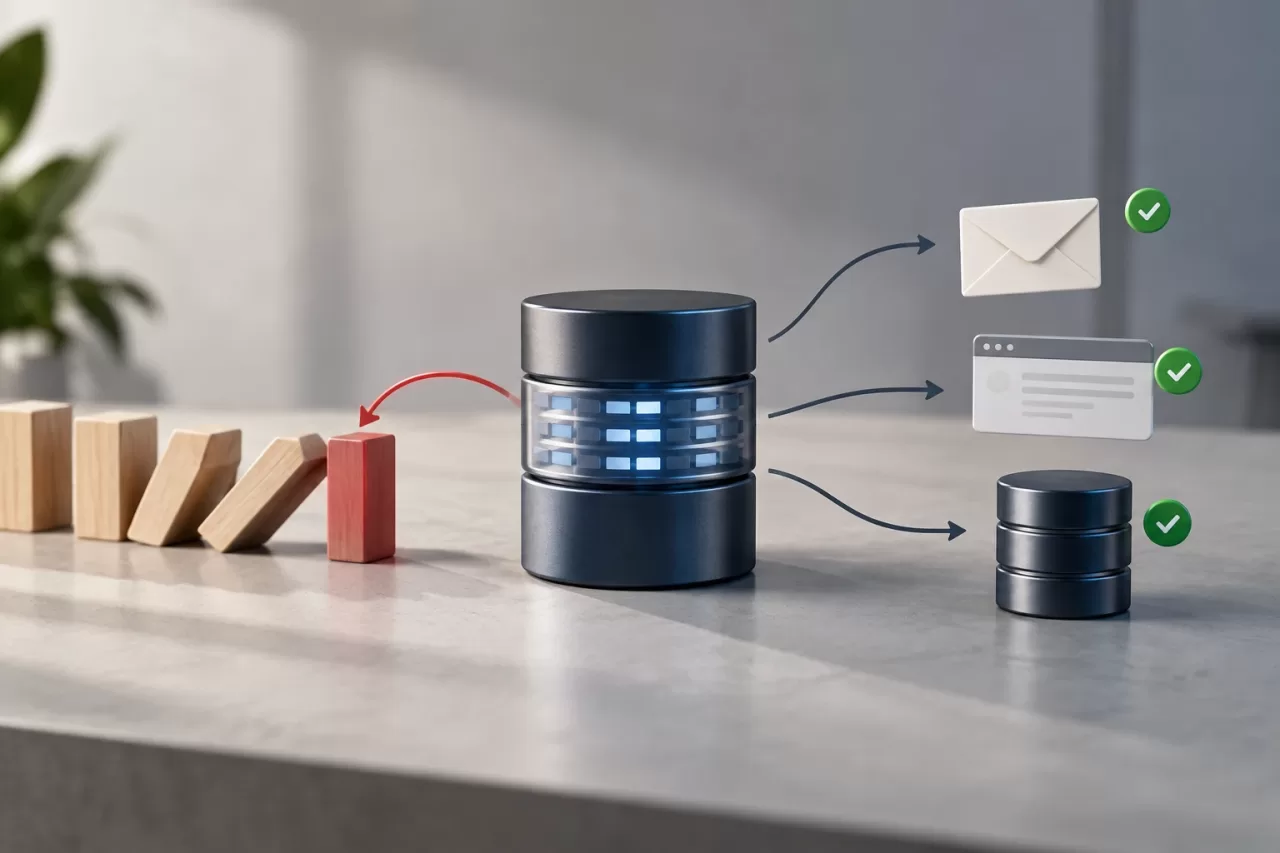
Una transacción de base de datos protege cambios dentro de los límites de esa base de datos. Si el proceso guarda varias filas y una operación falla antes del COMMIT, puede ejecutar un ROLLBACK para descartar esos cambios. Pero ese rollback no retira un correo enviado, no cancela automáticamente una solicitud ya aceptada por una API y no revierte cambios confirmados en otra base de datos.
Un reintento vuelve a ejecutar una acción que pudo fallar por un problema temporal, como un timeout o una indisponibilidad. Es apropiado solo si se conocen las consecuencias de repetirla. La solicitud pudo llegar al sistema externo aunque la respuesta se perdiera; sin una clave de idempotencia o una consulta de estado, el reintento podría crear un duplicado.
Una compensación ejecuta una acción de negocio que contrarresta un paso ya completado: por ejemplo, desactivar un acceso que se acaba de crear. No es un rollback técnico ni garantiza recuperar exactamente el estado anterior. Una conciliación, en cambio, compara lo registrado localmente con el estado de los sistemas implicados y ayuda a detectar y resolver discrepancias. Puede ser necesaria incluso cuando existen reintentos y compensaciones.
Modela cada operación como una secuencia de pasos observables
Antes de escribir manejadores de excepciones, describe el flujo como pasos independientes. Para cada uno, especifica qué sistema modifica, qué resultado cuenta como éxito, cómo se identifica la operación, si es seguro repetirlo y qué alternativa existe si no puede completarse. Define también cuáles son los efectos que deben mantenerse coherentes; esa regla de negocio es el invariante que guiará la recuperación.
Persiste un registro de la operación y de sus pasos en la aplicación. Un modelo sencillo puede incluir un identificador estable de operación, el estado general, el nombre del paso, el resultado, los intentos, las marcas de tiempo y el último error relevante. Estados como pendiente, en curso, completado, fallido, compensando y requiere revisión ayudan a distinguir lo que se sabe de lo que aún no se ha confirmado.
Guarda el cambio local y el registro de trabajo de forma atómica cuando deban mantenerse vinculados. Una cola de trabajo puede procesar después la llamada externa; el patrón de outbox es una opción para evitar que el cambio en la base de datos se confirme mientras se pierde la notificación que debía iniciar el siguiente paso. No elimina los fallos de red: el consumidor todavía necesita tolerar mensajes repetidos y resultados inciertos.
Evita mantener abierta una transacción de base de datos durante una llamada de red. Las llamadas externas tienen latencia y pueden quedar bloqueadas, mientras que la transacción prolongada retiene recursos y no hace atómicos a los dos sistemas. Confirma el trabajo local según una secuencia explícita y registra lo necesario para continuar o compensar.
Diseña compensaciones explícitas, limitadas e idempotentes
Para cada paso que produce un efecto, decide si existe una compensación y cuándo debe ejecutarse. La compensación no tiene por qué ser la inversa literal. Si una cuenta ya recibió una notificación, no se puede borrar el hecho de que el mensaje fue leído; puede corresponder registrar una corrección o avisar de la cancelación. Si una acción es irreversible o tiene consecuencias legales o financieras, quizá la respuesta correcta sea detener el flujo y escalarlo.
- Idempotencia: ejecutar dos veces la misma compensación no debe crear efectos adicionales. Usa un identificador estable de operación o una clave idempotente cuando el sistema lo permita, y registra el resultado.
- Orden: define qué pasos se compensan y en qué secuencia. Habitualmente se intenta revertir en orden inverso al de ejecución, pero las dependencias y reglas del negocio pueden exigir otro orden.
- Límites: establece qué errores permiten reintentos, cuántos intentos realizar y cuándo detenerse. Aplica esperas entre intentos y evita reintentos indefinidos.
- Incertidumbre: si vence el tiempo de espera de una API, consulta su estado o usa una clave de idempotencia antes de repetir una creación o ejecutar una compensación potencialmente incorrecta.
La lógica de compensación debe ser una operación de negocio identificable, no un bloque genérico que borra datos al capturar cualquier excepción. Conserva el historial necesario para explicar qué ocurrió y comprobar que la respuesta cumple las reglas del producto.
Ejemplo hipotético: alta de una cuenta en dos sistemas
Supongamos un flujo que crea una cuenta local y solicita a un proveedor externo activar un espacio de trabajo. La aplicación asigna un identificador de operación y registra el alta como pendiente. En una transacción local, guarda la cuenta y un trabajo para solicitar el aprovisionamiento. Un trabajador PHP procesa el trabajo y registra el identificador externo y el resultado de la solicitud.
Si el proveedor confirma la activación, el flujo marca la operación como completada. Si responde con un error temporal conocido, el trabajo puede reintentarse con límites y la misma clave idempotente. Si la respuesta es incierta, la aplicación primero intenta averiguar si el espacio de trabajo existe. Si el proveedor confirma que se creó, pero un requisito local posterior impide completar el alta, el sistema puede solicitar su desactivación como compensación y guardar ese resultado.
Si la desactivación falla, no se debe declarar que el alta está revertida. La operación queda en un estado visible de recuperación pendiente o revisión, con los identificadores local y externo, los intentos y el error. El equipo de operaciones necesita un procedimiento para comprobar el proveedor, decidir la acción permitida y registrar el desenlace. El ejemplo es hipotético: las acciones concretas dependen de las capacidades de la API y de las reglas del negocio.
Cuando la compensación también falla: visibilidad y revisión
Un flujo distribuido no puede prometer que toda acción se deshará automáticamente. Diseña una salida explícita para el agotamiento de reintentos, una respuesta externa ambigua o el fallo de la compensación. Conserva el estado sin ocultar la incoherencia y evita presentar la operación al usuario como completada si aún no lo está.
Proporciona a soporte u operaciones una vista que muestre el estado por paso, el último error, los identificadores de correlación y las acciones permitidas. La revisión humana debe tener controles de acceso y dejar una auditoría de la decisión. Expón métricas y alertas para detectar operaciones atascadas, compensaciones fallidas y discrepancias que superen el tiempo operativo aceptable. Una tarea de conciliación periódica puede contrastar registros locales con el sistema externo y abrir casos para resolver diferencias.
Prueba fallos parciales y decide si necesitas compensación
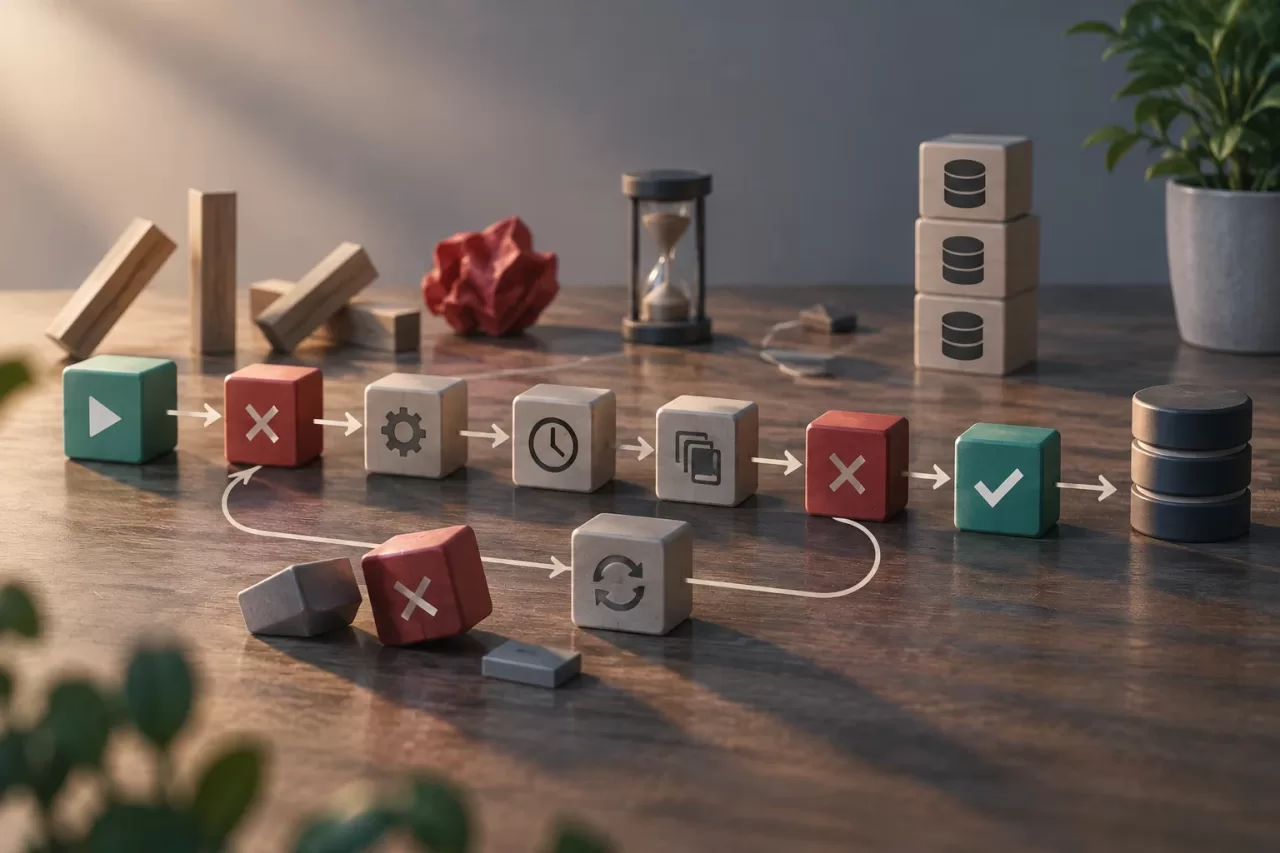
Las pruebas deben cubrir más que la ruta exitosa. Simula errores antes y después de cada efecto, respuestas tardías, timeouts con resultado desconocido, mensajes duplicados, procesos interrumpidos y fallos durante la compensación. Verifica el estado persistido tras reiniciar el trabajador y confirma que los reintentos no duplican cuentas ni otras operaciones.
- ¿Se conservan el identificador de operación y los resultados de cada paso?
- ¿Un mensaje repetido produce el mismo resultado sin efectos duplicados?
- ¿Se consulta el estado externo cuando la respuesta de una solicitud es incierta?
- ¿La compensación se ejecuta en el orden previsto y es segura si se repite?
- ¿Un fallo de compensación deja la operación visible y la envía al circuito de revisión?
- ¿Se puede conciliar después el estado local con el sistema externo?
- ¿Las pruebas comprueban los invariantes del negocio, no solo los códigos de respuesta?
Si el flujo afecta a un único sistema y una transacción local protege todos sus cambios, puede bastar con esa transacción y una recuperación sencilla. Si hay efectos externos repetibles con garantías conocidas, quizá basten reintentos idempotentes y conciliación. Cuando un paso confirmado debe contrarrestarse para preservar una regla de negocio, define una compensación. La complejidad adicional merece la pena cuando el coste de dejar estados parciales sin detectar supera el de mantener el registro, las pruebas y el procedimiento operativo.