Aplikacja może mieć dziesiątki technicznych metryk na czerwono, a mimo to nadal świadczyć główną usługę. Może też być odwrotnie: CPU, pamięć i łączność wyglądają normalnie, lecz użytkownicy nie mogą ukończyć krytycznej operacji. Celem alertów wymagających działania dla aplikacji PHP nie jest wykrywanie każdej anomalii, lecz powiadamianie wtedy, gdy osoba musi podjąć konkretną decyzję, aby ograniczyć konsekwencję operacyjną.
Użyteczny alert odpowiada, jeszcze przed otwarciem panelu, na cztery pytania: jaka funkcjonalność lub usługa jest dotknięta problemem, kogo on dotyczy, od kiedy trwa oraz jakie początkowe działanie jest bezpieczne. Jeśli nie pozwala sformułować hipotezy ani zdecydować o interwencji, prawdopodobnie jest telemetrią diagnostyczną, a nie alertem dyżurowym.
Rozdzielanie sygnałów, symptomów i incydentów
Sygnał to pojedyncza obserwacja: wzrost wykorzystania połączeń, restarty procesów PHP-FPM, przyrost kolejki lub wolna odpowiedź API. Symptom wyraża obserwowalną degradację usługi: więcej błędów podczas potwierdzania zamówień, krytyczne zadania, które nie kończą się w wymaganym czasie, lub utrzymujący się wzrost opóźnienia istotnej ścieżki. Incydent to sytuacja wymagająca koordynacji i reakcji ze względu na jej rzeczywisty lub przewidywalny wpływ.
To rozróżnienie zapobiega przekształcaniu każdej metryki infrastruktury w przerwę w działaniu. Na przykład przejściowe nasycenie CPU może być przydatne przy badaniu pojemności. Powinno eskalować do alertu, jeśli zbiega się z nieudanymi żądaniami lub z opóźnieniem uniemożliwiającym korzystanie z funkcji priorytetowej. Podobnie duża liczba wyjątków PHP zasługuje na uwagę, gdy koncentruje się w operacji biznesowej lub dotyczy istotnej części żądań, a nie wyłącznie dlatego, że występuje w logach.
- Sygnały diagnostyczne: wykorzystanie dysku, liczba procesów, trafienia cache, pojedyncze ponowienia lub ślady wyjątków.
- Symptomy wymagające alertu: niedostępność, utrzymujący się wskaźnik błędów w krytycznym przepływie, opóźnienie przetwarzania lub bliskie wyczerpanie zasobu z weryfikowalnym skutkiem.
- Wskaźniki incydentu: zasięg wśród użytkowników, możliwa utrata lub duplikacja danych, niedotrzymanie terminu operacyjnego oraz brak rozsądnej alternatywy ręcznej.
Budowanie minimalnej mapy usługi
Zanim ustalisz progi, rozrysuj przebieg istotnych przepływów. Nie trzeba inwentaryzować całej platformy: wystarczy przedstawić ścieżki, które dostarczają wartość lub generują ryzyko. W typowej aplikacji PHP występują żądanie webowe, uwierzytelnianie, logika domenowa, baza danych, cache, publikowanie w kolejce, konsumenci asynchroniczni i API stron trzecich.
Dla każdego odcinka udokumentuj, jakie dane wejściowe otrzymuje, jaki obserwowalny wynik powinien wytworzyć, jakiej zależności potrzebuje i jak zachowuje się przy awarii. Żądanie może odpowiedzieć poprawnie po umieszczeniu zadania w kolejce, choć końcowa akcja nie została jeszcze ukończona. Dlatego monitorowanie wyłącznie kodu HTTP warstwy webowej pozostawia zespół ślepym na opóźnienia lub błędy przetwarzania asynchronicznego.
Priorytetyzowanie według konsekwencji, nie komponentów
Sklasyfikuj każdy przepływ według konsekwencji jego zatrzymania: utrata przychodów, niewypełnienie zobowiązania operacyjnego, ekspozycja danych, blokada wsparcia lub zwykła degradacja estetyczna. Następnie zidentyfikuj pomiar, który potwierdza tę konsekwencję. Dla rejestracji użytkownika może to być potwierdzone utworzenie konta; dla importu — wiek najstarszego oczekującego elementu; dla integracji rozliczeniowej — odsetek operacji kończących się stanem odzyskiwalnym lub ostatecznym.
Warto utrzymywać testy syntetyczne spoza procesu PHP dla kluczowych ścieżek. Test wewnętrzny może wskazywać, że proces działa, ale nie że równoważenie obciążenia, dane uwierzytelniające, magazyn sesji i ścieżka biznesowa funkcjonują łącznie.
Cztery rodziny alertów, które zwykle wspierają podjęcie decyzji
Postrzegana dostępność mierzy, czy można ukończyć reprezentatywną operację. Może łączyć test syntetyczny z odsetkiem poprawnych odpowiedzi na krytycznych ścieżkach. Jest bardziej wartościowa niż alertowanie o odizolowanym procesie, chociaż oba te dane mogą współistnieć w diagnostyce.
Błędy biznesowe wychwytują nieprawidłowe wyniki, których kod HTTP nie ujawnia: walidacje nieoczekiwanie kończące się niepowodzeniem, płatności odrzucone z powodu zmiany wewnętrznej, niewygenerowane dokumenty lub niemożliwe przejścia stanu. Powinny wykorzystywać zdarzenia domenowe z identyfikatorami umożliwiającymi badanie bez dołączania niepotrzebnych danych osobowych.
Opóźnienie należy mierzyć według ścieżki i percentyli, a nie tylko za pomocą średnich. Akceptowalna średnia może ukrywać mniejszość nadmiernie wolnych żądań. Wysyłaj alert, gdy opóźnienie się utrzymuje i dotyczy istotnej operacji; krótki skok może wymagać obserwacji, a nie budzenia osoby.
Opóźnienie przetwarzania mierzy czas od przyjęcia zadania do jego zakończenia. Jest szczególnie ważne w kolejkach, ponieważ całkowita liczba wiadomości nie zawsze oznacza pilność: duża kumulacja może być normalna, jeśli konsumenci opróżniają ją w wymaganym czasie.
Definiowanie progów na podstawie poziomu bazowego
Nie kopiuj ogólnej wartości CPU, opóźnienia ani rozmiaru kolejki. Zbierz poziom bazowy według pory dnia i typu obciążenia, w tym przewidywalnych szczytów. Następnie zdefiniuj poziom na podstawie wpływu: jak długo przepływ może trwać, zanim naruszy oczekiwanie użytkownika, okno operacyjne lub wewnętrzne zobowiązanie.
Solidna reguła łączy cztery elementy: okno oceny, minimalną trwałość, skalę i zasięg. Na przykład nie wystarczy wykryć wzrost błędów; ustal, że wzrost utrzymuje się przez kilka okien i stanowi znaczącą część operacji przepływu. W ten sposób ogranicza się powiadomienia wywołane przejściowymi wdrożeniami, udanymi ponowieniami lub odosobnionym anormalnym ruchem.
Rozróżniaj wdrożenie, które instaluje wersję, od udostępnienia, które włącza zmianę zachowania dla użytkowników. Oba stanowią istotny kontekst, ale nie są równoważne. Alert po wdrożeniu może wskazywać na rollback lub badanie techniczne; alert po stopniowej aktywacji może wymagać zatrzymania ekspozycji zmiany przed wycofaniem kodu.
Kolejki, baza danych i integracje zewnętrzne
Kolejki: monitorowanie wieku i efektywnej pojemności
Dla każdej krytycznej kolejki mierz wiek najstarszego oczekującego zadania, tempo napływu, tempo ukończeń, ostateczne błędy i ponowienia. Dodaj sygnały dotyczące dostępnych konsumentów oraz czasu wykonania. Alert, który najlepiej wskazuje potrzebę działania, zwykle opiera się na wieku: bezpośrednio wiąże opóźnienie ze zobowiązaniem przepływu.
Wzrost kolejki jest diagnostyczny, dopóki nie przekroczy zdolności opróżniania lub nie zagrozi terminowi. Jeśli jednocześnie rosną wiek, błędy i brak konsumentów, powiadomienie powinno zgrupować te symptomy jako możliwą degradację przetwarzania, zamiast wysyłać jedno na metrykę.
W bazie danych priorytetowo traktuj wyczerpanie połączeń, utrzymujące się błędy połączeń, długotrwałe blokady oraz opóźnienie zapytań przekładające się na wolne lub nieudane ścieżki. Kosztowne zapytanie zidentyfikowane w obserwowalności jest sygnałem do optymalizacji; staje się alertem, gdy generuje symptom usługi. Dla zewnętrznych API mierz dostępność, opóźnienie, kody błędów, limity kwotowe i ponowienia. Rozdziel błędy odzyskiwalne od ostatecznych i sprawdź, czy istnieje kolejka, cache, tryb degradacji lub procedura ręczna.
Dołączanie kontekstu i klasyfikowanie odpowiedzi
Powiadomienie powinno zawierać nazwę usługi i dotkniętego przepływu, poziom krytyczności, początek i przebieg, szacowany zasięg, region lub środowisko, metryki, które uruchomiły regułę, wdrożoną wersję lub niedawno aktywowaną zmianę oraz dostęp do paneli diagnostycznych. Uwzględnij również bezpieczne pierwsze kroki: sprawdzenie stanu konsumentów, zweryfikowanie danych uwierzytelniających zależności, wstrzymanie stopniowej aktywacji lub sprawdzenie błędów według kategorii.
Unikaj destrukcyjnych automatycznych instrukcji, takich jak opróżnianie kolejki lub bezkrytyczne restartowanie. Automatyzacja przywracania usługi powinna mieć ograniczenia, rejestrowanie, odwracalność i jasny warunek eskalacji do przeglądu przez człowieka.
- Informacyjne: anomalia bez bieżącego wpływu, którą należy obserwować w godzinach pracy.
- Planowana interwencja: degradacja zagrażająca terminowi, ale z zachowanym marginesem i alternatywą operacyjną.
- Natychmiastowa eskalacja: krytyczna operacja niedostępna, ryzyko dla danych, kumulacja niemożliwa do nadrobienia lub rosnący wpływ bez znanego sposobu ograniczenia skutków.
Unikanie zmęczenia alertami i przegląd każdej reguły
Deduplikuj identyczne zdarzenia, grupuj alerty według prawdopodobnej przyczyny i ograniczaj powtarzanie, gdy incydent pozostaje otwarty. Alert pomocniczy powinien wzbogacać główny, a nie z nim konkurować. Jeśli zewnętrzny dostawca ulega awarii i powoduje ponowienia, błędy aplikacji oraz opóźnienia w kolejce, centralne powiadomienie powinno opisywać prawdopodobną zależność i dołączać skorelowane symptomy.
Po każdym incydencie sprawdź, czy brakowało wczesnego alertu, który z nich dotarł bez prowadzenia do decyzji i jakie dowody umożliwiły zidentyfikowanie przyczyny. Usuń lub obniż reguły, które generują wyłącznie rutynowe potwierdzenia. Mierz rezultat jakościowo: jeśli osoba odbierająca rozumie wpływ i wykonuje odpowiedni pierwszy krok bez szukania rozproszonego kontekstu, reguła spełnia swoją funkcję.
Przykład projektu dla przepływu asynchronicznego
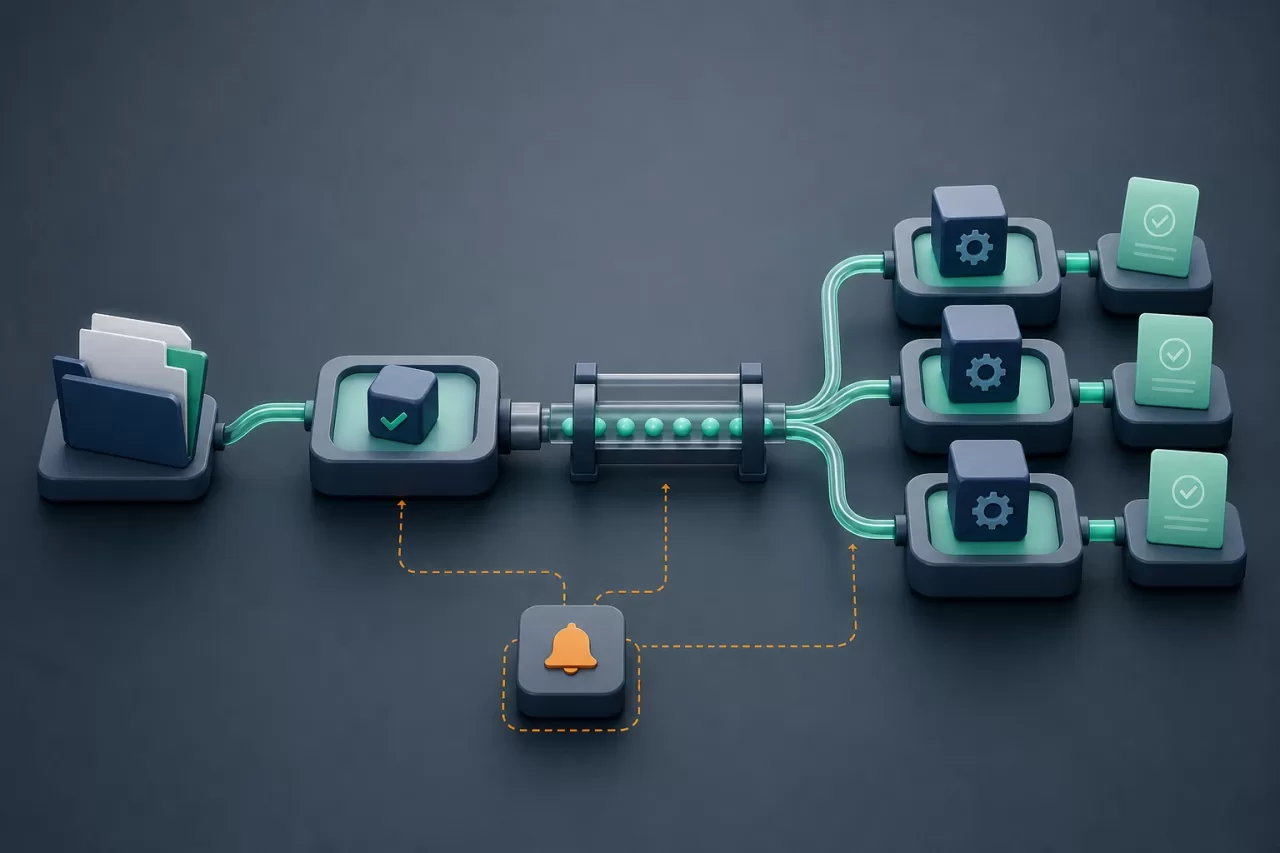
Wyobraź sobie przepływ odbioru, walidacji i późniejszego przetwarzania plików. Żądanie PHP potwierdza odbiór po zapisaniu metadanych i opublikowaniu zadania. Konsumenci walidują zawartość i generują wynik. Alerty nie powinny ograniczać się do wykrywania, że kolejka zawiera wiadomości.
- Alert dostępności, jeśli odbiór stale kończy się niepowodzeniem w istotnej części żądań.
- Alert opóźnienia, jeśli wiek oczekującego zadania przekracza akceptowalny termin dostarczenia wyniku.
- Alert jakości, jeśli rosną błędy walidacji z przyczyny wewnętrznej, z rozróżnieniem od nieprawidłowych plików przesyłanych przez użytkowników.
- Alert zależności, jeśli system pamięci masowej lub wymagane API odpowiada utrzymującymi się błędami i nie istnieje skuteczna ścieżka automatycznego odzyskiwania.
Aby opublikować nową regułę, na końcu zweryfikuj: zdefiniowany przepływ i właściciela, wpływ wyrażony w kategoriach operacyjnych, dostępny poziom bazowy, próg z oknem i trwałością, uzasadniony poziom krytyczności, skonfigurowaną deduplikację, dołączony kontekst, udokumentowany bezpieczny pierwszy krok oraz zaplanowany przegląd. Ten filtr przekształca alerty wymagające działania dla aplikacji PHP w system decyzyjny, a nie kolejne źródło przerw.