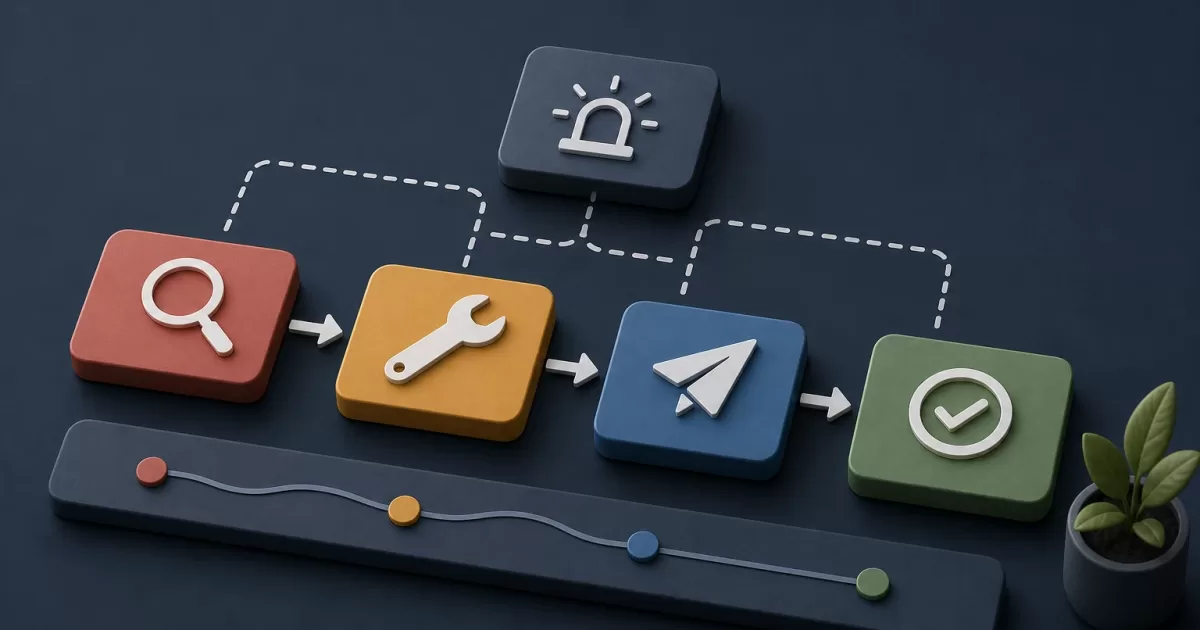
Eine Anwendung kann Dutzende technische Metriken im roten Bereich aufweisen und dennoch den Hauptservice weiterhin bereitstellen. Auch das Gegenteil kann eintreten: CPU, Arbeitsspeicher und Konnektivität wirken normal, doch die Benutzer können einen kritischen Vorgang nicht abschließen. Das Ziel von handlungsrelevanten Warnmeldungen für PHP-Anwendungen besteht nicht darin, jede Anomalie zu erkennen, sondern dann zu warnen, wenn eine Person eine konkrete Entscheidung treffen muss, um eine betriebliche Auswirkung zu begrenzen.
Eine nützliche Warnmeldung beantwortet noch vor dem Öffnen eines Dashboards vier Fragen: Welche Funktion ist beeinträchtigt, wen betrifft sie, seit wann besteht die Beeinträchtigung, und welche erste Maßnahme ist sicher? Wenn sie keine Hypothese oder Entscheidung über einen Eingriff ermöglicht, handelt es sich wahrscheinlich um Diagnose-Telemetrie und nicht um eine Warnmeldung für den Bereitschaftsdienst.
Signale, Symptome und Incidents trennen
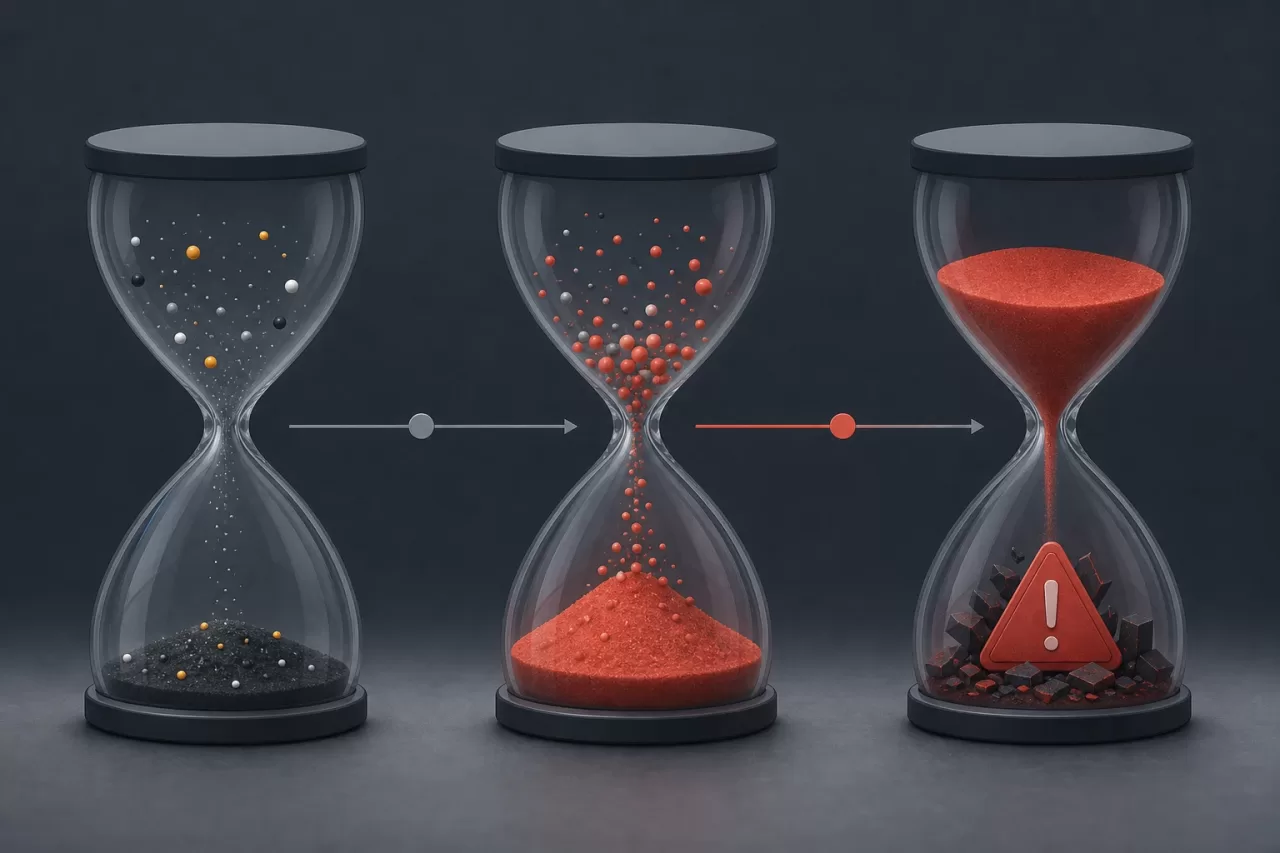
Ein Signal ist eine isolierte Beobachtung: steigende Auslastung von Verbindungen, Neustarts von PHP-FPM-Prozessen, Wachstum einer Warteschlange oder eine langsame API-Antwort. Ein Symptom drückt eine beobachtbare Serviceverschlechterung aus: mehr Fehler beim Abschließen von Bestellungen, kritische Jobs, die nicht innerhalb der Frist abgeschlossen werden, oder ein anhaltender Anstieg der Latenz einer relevanten Route. Ein Incident ist die Situation, die aufgrund ihrer tatsächlichen oder vorhersehbaren Auswirkung Koordination und Reaktion erfordert.
Diese Unterscheidung verhindert, dass jede Infrastrukturmetrik in eine Unterbrechung verwandelt wird. Beispielsweise kann eine vorübergehende CPU-Sättigung für die Untersuchung der Kapazität nützlich sein. Sie sollte zu einer Warnmeldung eskalieren, wenn sie mit fehlgeschlagenen Requests oder mit einer Latenz zusammenfällt, die die Nutzung einer prioritären Funktion verhindert. Ebenso verdienen viele PHP-Exceptions Aufmerksamkeit, wenn sie sich auf einen Geschäftsvorgang konzentrieren oder einen relevanten Anteil der Requests betreffen, nicht allein deshalb, weil sie in den Logs vorhanden sind.
- Diagnosesignale: Festplattenverbrauch, Anzahl der Prozesse, Cache-Treffer, einzelne Wiederholungsversuche oder Exception-Traces.
- Warnwürdige Symptome: Nichtverfügbarkeit, anhaltende Fehlerrate in einem kritischen Ablauf, Verarbeitungsverzögerung oder drohende Erschöpfung einer Ressource mit nachweisbarer Auswirkung.
- Incident-Indikatoren: Umfang der betroffenen Benutzer, möglicher Datenverlust oder mögliche Datenduplizierung, Verstoß gegen eine operative Frist und Fehlen einer angemessenen manuellen Alternative.
Eine minimale Servicekarte erstellen
Zeichnen Sie vor der Festlegung von Schwellenwerten den Ablauf der relevanten Abläufe. Es ist nicht nötig, die gesamte Plattform zu inventarisieren: Es genügt, die Pfade darzustellen, die Wert liefern oder Risiken erzeugen. In einer üblichen PHP-Anwendung finden sich der Web-Request, Authentifizierung, Domänenlogik, Datenbank, Cache, das Einreihen eines Jobs in eine Warteschlange, asynchrone Worker und APIs von Drittanbietern.
Dokumentieren Sie für jeden Abschnitt, welche Eingabe er erhält, welches beobachtbare Ergebnis er erzeugen muss, welche Abhängigkeit er benötigt und wie er sich bei einem Fehler verhält. Ein Request kann erfolgreich antworten, nachdem er einen Job in die Warteschlange eingereiht hat, obwohl die abschließende Aktion noch nicht abgeschlossen ist. Daher macht die ausschließliche Überwachung des HTTP-Codes der Webschicht das Team blind für Verzögerungen oder Fehler der asynchronen Verarbeitung.
Nach Folgen priorisieren, nicht nach Komponenten
Klassifizieren Sie jeden Ablauf danach, welche Folge sein Ausfall hätte: Umsatzeinbußen, Verstoß gegen operative Vorgaben, Offenlegung von Daten, Blockierung des Supports oder bloße ästhetische Verschlechterung. Identifizieren Sie anschließend eine Messung, die diese Folge nachweist. Bei einer Benutzerregistrierung kann dies die bestätigte Erstellung des Kontos sein; bei einem Import das Alter des ältesten ausstehenden Elements; bei einer Rechnungsintegration die Quote der Vorgänge, die in einem wiederherstellbaren oder endgültigen Zustand enden.
Für die wesentlichen Abläufe empfiehlt es sich, synthetische Prüfungen außerhalb des PHP-Prozesses beizubehalten. Eine interne Prüfung kann anzeigen, dass der Prozess läuft, aber nicht, dass Load Balancing, Zugangsdaten, Session-Speicher und der Geschäftspfad zusammen funktionieren.
Die vier Familien von Warnmeldungen, die meist Entscheidungen ermöglichen
Die wahrgenommene Verfügbarkeit misst, ob ein repräsentativer Vorgang abgeschlossen werden kann. Sie kann eine synthetische Prüfung mit dem Prozentsatz erfolgreicher Antworten kritischer Routen kombinieren. Sie ist wertvoller als eine Warnmeldung für einen isolierten Prozess, obwohl beide Daten in der Diagnose nebeneinander bestehen können.
Geschäftsfehler erfassen falsche Ergebnisse, die ein HTTP-Code nicht offenlegt: unerwartet fehlschlagende Validierungen, aufgrund einer internen Änderung abgelehnte Zahlungen, nicht erzeugte Dokumente oder unmögliche Zustandsübergänge. Sie sollten Domänenereignisse mit Kennungen verwenden, die Untersuchungen ermöglichen, ohne unnötige personenbezogene Informationen einzubeziehen.
Die Latenz muss pro Route und anhand von Perzentilen gemessen werden, nicht nur über Durchschnittswerte. Ein akzeptabler Durchschnitt kann eine Minderheit übermäßig langsamer Requests verbergen. Warnen Sie, wenn die Latenz anhält und einen relevanten Vorgang betrifft; eine kurze Spitze kann Beobachtung erfordern, nicht das Wecken einer Person.
Die Verarbeitungsverzögerung misst die Zeit von der Annahme eines Jobs bis zu seinem Abschluss. Sie ist besonders bei Warteschlangen wichtig, da die Gesamtzahl der Nachrichten nicht immer Dringlichkeit bedeutet: Ein großer Backlog kann normal sein, wenn die Worker ihn innerhalb der erforderlichen Frist abarbeiten.
Schwellenwerte aus der Baseline definieren
Kopieren Sie keinen generischen Wert für CPU, Latenz oder Warteschlangengröße. Erheben Sie eine Baseline nach Tageszeit und Lasttyp, einschließlich vorhersehbarer Spitzen. Definieren Sie das Niveau anschließend anhand der Auswirkung: Wie lange darf ein Ablauf dauern, bevor er eine Benutzererwartung, ein Betriebsfenster oder eine interne Verpflichtung verletzt?
Eine robuste Regel kombiniert vier Elemente: ein Auswertungsfenster, eine Mindestpersistenz, Größenordnung und Umfang. Beispielsweise reicht es nicht aus, einen Fehleranstieg festzustellen; legen Sie fest, dass der Anstieg über mehrere Fenster anhält und einen erheblichen Anteil der Vorgänge des Ablaufs darstellt. So werden Benachrichtigungen durch vorübergehende Deployments, erfolgreiche Wiederholungsversuche oder isolierten anomalen Traffic reduziert.
Unterscheiden Sie das Einsatz, das eine Version installiert, vom Freigeben, das eine Verhaltensänderung für Benutzer aktiviert. Beide sind relevanter Kontext, aber nicht gleichbedeutend. Eine Warnmeldung nach einem Deployment kann ein Rollback oder eine technische Untersuchung nahelegen; eine Warnmeldung nach einer schrittweisen Aktivierung kann erfordern, die Freigabe der Änderung zu stoppen, bevor Code zurückgerollt wird.
Warteschlangen, Datenbank und externe Integrationen
Warteschlangen: Alter und effektive Kapazität überwachen
Messen Sie für jede kritische Warteschlange das Alter des ältesten ausstehenden Jobs, die Eingangsrate, die Abschlussrate, endgültige Fehler und Wiederholungsversuche. Ergänzen Sie Signale zu verfügbaren Workern und Ausführungsdauer. Die handlungsrelevanteste Warnmeldung basiert meist auf dem Alter: Sie verknüpft die Verzögerung direkt mit der Verpflichtung des Ablaufs.
Ein Wachstum der Warteschlange ist Diagnose, bis es die Abarbeitungskapazität übersteigt oder die Einhaltung einer Frist bedroht. Wenn gleichzeitig Alter, Fehler und der Mangel an Workern zunehmen, sollte die Benachrichtigung diese Symptome unter einer möglichen Verschlechterung der Verarbeitung bündeln, statt eine pro Metrik zu versenden.
In der Datenbank sollten Sie die Erschöpfung von Verbindungen, anhaltende Verbindungsfehler, lang andauernde Sperren und Abfragelatenz priorisieren, die sich in langsame oder fehlgeschlagene Routen übersetzt. Eine in der Observability identifizierte kostspielige Abfrage ist ein Signal zur Optimierung; sie wird zur Warnmeldung, wenn sie ein Service-Symptom erzeugt. Messen Sie bei externen APIs Verfügbarkeit, Latenz, Fehlercodes, Quotenlimits und Wiederholungsversuche. Trennen Sie wiederherstellbare von endgültigen Fehlern und prüfen Sie, ob es eine Warteschlange, einen Cache, einen Degradationsmodus oder ein manuelles Verfahren gibt.
Kontext anhängen und die Reaktion klassifizieren
Eine Benachrichtigung sollte den Namen des betroffenen Services und Ablaufs, Schweregrad, Beginn und Entwicklung, geschätzten Umfang, Region oder Umgebung, die Metriken, die die Regel ausgelöst haben, die bereitgestellte Version oder die kürzlich aktivierte Änderung sowie Zugriff auf die Untersuchungs-Dashboards enthalten. Nehmen Sie außerdem sichere erste Schritte auf: den Status der Worker prüfen, Zugangsdaten einer Abhängigkeit validieren, eine schrittweise Aktivierung pausieren oder Fehler nach Kategorie überprüfen.
Vermeiden Sie destruktive automatische Anweisungen, etwa das Leeren einer Warteschlange oder wahllose Neustarts. Die Wiederherstellungsautomatisierung muss Grenzen, Protokollierung, Reversibilität und eine klare Bedingung für die Eskalation zur menschlichen Prüfung aufweisen.
- Informativ: Anomalie ohne aktuelle Auswirkung, die während der Geschäftszeiten beobachtet werden sollte.
- Geplante Intervention: Beeinträchtigung, die eine Frist zu überschreiten droht, für die jedoch noch Spielraum und eine operative Alternative bestehen.
- Sofortige Eskalation: kritischer Vorgang nicht verfügbar, Datenrisiko, nicht mehr aufholbarer Backlog oder zunehmende Auswirkung ohne bekannte Minderung.
Alarmmüdigkeit vermeiden und jede Regel überprüfen
Deduplizieren Sie identische Ereignisse, gruppieren Sie Warnmeldungen nach wahrscheinlicher Ursache und begrenzen Sie Wiederholungen, solange der Incident offen bleibt. Eine sekundäre Warnmeldung sollte die primäre anreichern, nicht mit ihr konkurrieren. Wenn ein externer Anbieter ausfällt und Wiederholungsversuche, Anwendungsfehler und Verzögerungen in der Warteschlange verursacht, sollte die zentrale Benachrichtigung die wahrscheinliche Abhängigkeit beschreiben und die korrelierten Symptome anhängen.
Prüfen Sie nach jedem Incident, ob eine frühe Warnmeldung fehlte, welche Warnmeldung einging, ohne dass daraus eine Entscheidung hervorging, und welche Evidenz die Identifizierung der Ursache ermöglichte. Entfernen oder stufen Sie Regeln herab, die nur routinemäßige Bestätigungen erzeugen. Messen Sie das Ergebnis qualitativ: Wenn die empfangende Person die Auswirkung versteht und einen angemessenen ersten Schritt ausführt, ohne nach verstreutem Kontext suchen zu müssen, erfüllt die Regel ihre Funktion.
Entwurfsbeispiel für einen asynchronen Ablauf
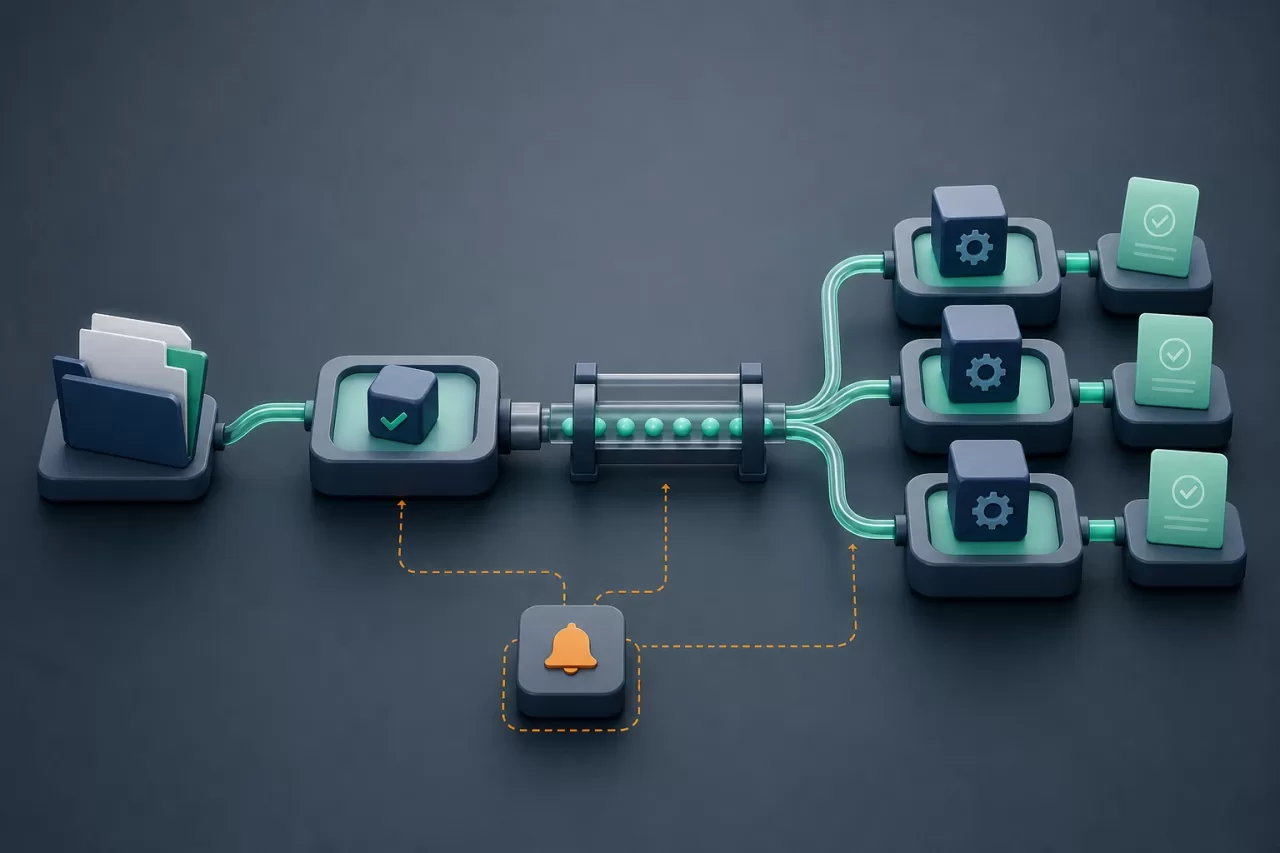
Stellen Sie sich einen Ablauf für die Entgegennahme, Validierung und nachgelagerte Verarbeitung von Dateien vor. Der PHP-Request bestätigt den Empfang, nachdem er Metadaten gespeichert und einen Job in die Warteschlange eingereiht hat. Die Worker validieren den Inhalt und erzeugen ein Ergebnis. Die Warnmeldungen sollten sich nicht darauf beschränken zu erkennen, dass die Warteschlange Nachrichten enthält.
- Verfügbarkeitswarnmeldung, wenn der Empfang bei einem relevanten Anteil der Requests anhaltend fehlschlägt.
- Verzögerungswarnmeldung, wenn das Alter des ausstehenden Jobs die akzeptable Frist für die Bereitstellung des Ergebnisses überschreitet.
- Qualitätswarnmeldung, wenn Validierungsfehler aufgrund einer internen Ursache zunehmen, wobei sie von ungültigen, durch Benutzer gesendeten Dateien unterschieden werden.
- Abhängigkeitswarnmeldung, wenn der Speicher oder eine erforderliche API mit anhaltenden Fehlern antwortet und kein wirksamer automatischer Wiederherstellungspfad besteht.
Prüfen Sie abschließend vor der Veröffentlichung einer neuen Regel: Ablauf und Eigentümer definiert, Auswirkung in betrieblichen Begriffen ausgedrückt, Baseline verfügbar, Schwellenwert mit Fenster und Persistenz, Schweregrad begründet, Deduplizierung konfiguriert, Kontext angehängt, sicherer erster Schritt dokumentiert und Überprüfung vorgesehen. Dieser Filter macht handlungsrelevante Warnmeldungen für PHP-Anwendungen zu einem Entscheidungssystem und nicht zu einer weiteren Quelle von Unterbrechungen.