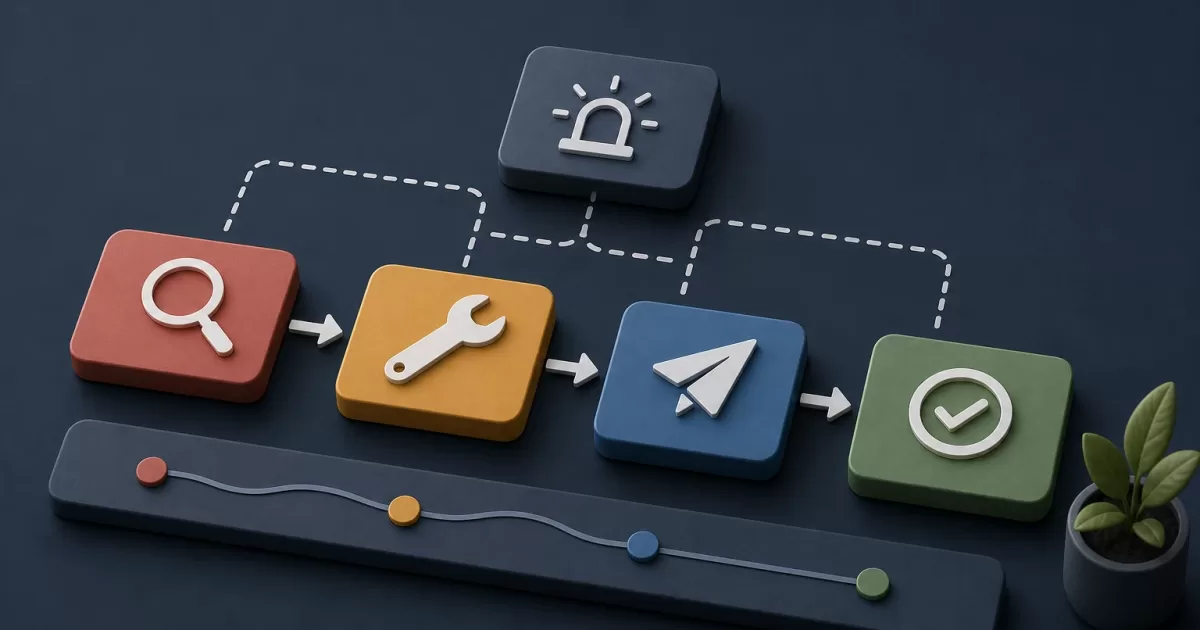
アプリケーションでは、技術的なメトリクスが数十件赤信号でも、主要サービスを継続して提供できる場合があります。逆も起こり得ます。CPU、メモリ、接続性は正常に見えても、ユーザーが重要な操作を完了できないことがあります。PHPアプリケーションのアクショナブルなアラートの目的は、すべての異常を検出することではなく、運用上の影響を抑えるために担当者が具体的な判断を下すべき時点を通知することです。
有用なアラートは、ダッシュボードを開く前に4つの問いへ答えます。どの機能が影響を受けているか、誰に影響するか、いつからか、そして安全な初動は何かです。仮説を立てたり介入を決めたりできないなら、それはおそらく診断テレメトリであり、オンコールアラートではありません。
シグナル、症状、インシデントを分ける
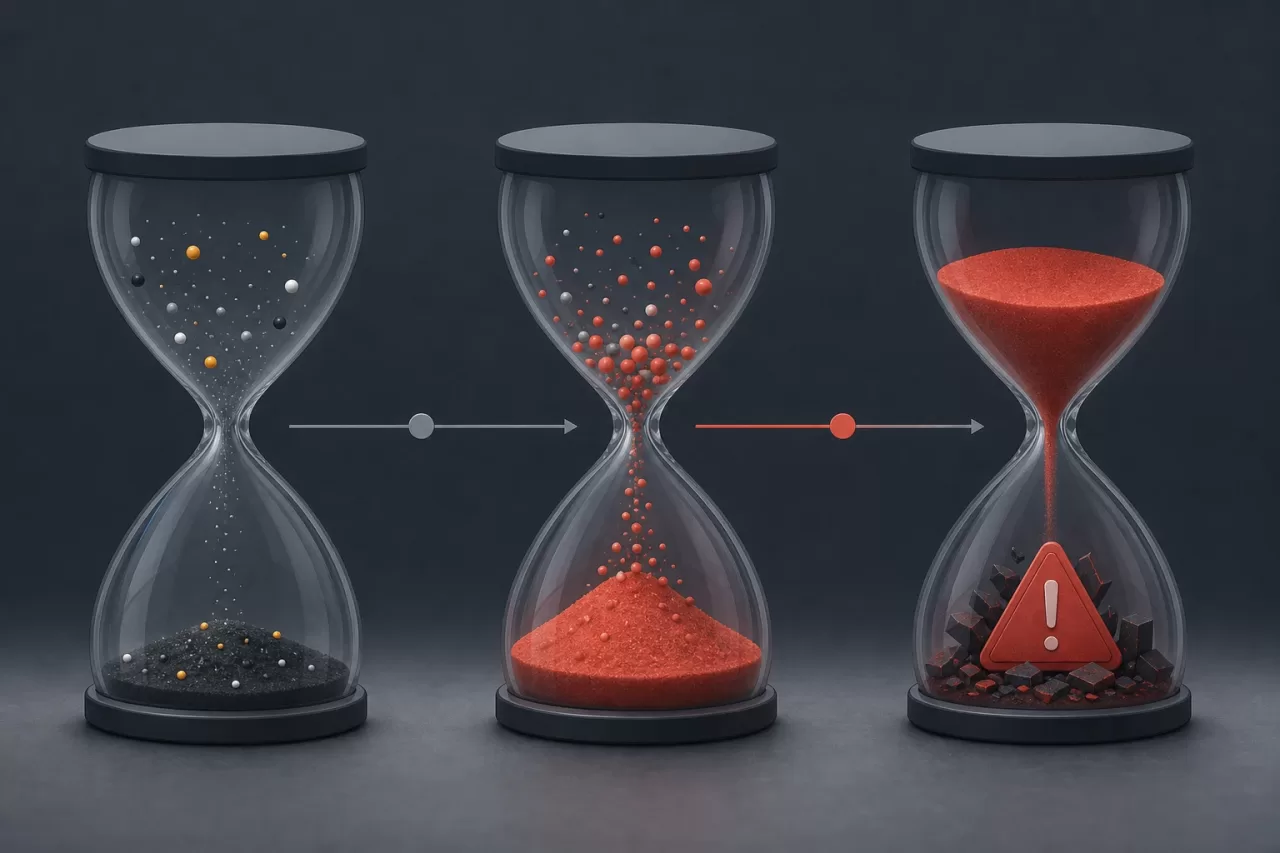
シグナルは単独の観測です。接続使用量の増加、PHP-FPMプロセスの再起動、キューの増加、API応答の低速化などが該当します。症状は観測可能なサービス劣化を示します。注文確定時のエラー増加、重要なジョブが期限内に完了しないこと、重要なルートのレイテンシが継続的に増加することなどです。インシデントは、実際または予見可能な影響のために、連携と対応を必要とする状況です。
この区別により、インフラストラクチャの各メトリクスを障害に変えてしまうことを防げます。たとえば、一時的なCPU飽和はキャパシティ調査には有用です。失敗リクエストや、優先機能の利用を妨げるレイテンシと重なる場合に、アラートへエスカレーションすべきです。同様に、多数のPHP例外は、単にログに存在するからではなく、特定の業務操作に集中している場合、または相当な割合のリクエストに影響する場合に注意を要します。
- 診断シグナル:ディスク消費量、プロセス数、キャッシュヒット、個別リトライ、例外トレース。
- アラート可能な症状:利用不能、重要フローにおける継続的な失敗率、処理遅延、または検証可能な影響を伴うリソース枯渇の接近。
- インシデント指標:影響を受けるユーザーの範囲、データ損失または重複の可能性、運用期限の未達、合理的な手動代替手段の不在。
最小限のサービスマップを作る
しきい値を設定する前に、重要なフローの経路を描いてください。プラットフォーム全体を棚卸しする必要はありません。価値を提供する、またはリスクを生む経路を表現すれば十分です。一般的なPHPアプリケーションには、Webリクエスト、認証、ドメインロジック、データベース、キャッシュ、キューへの公開、非同期コンシューマー、サードパーティAPIが含まれます。
各区間について、受け取る入力、生成すべき観測可能な結果、必要な依存先、障害時の挙動を文書化してください。リクエストはジョブをキューに入れた後、正しく応答できても、最終アクションはまだ完了していないことがあります。そのため、Web層のHTTPステータスコードだけを監視すると、チームは非同期処理の遅延やエラーを把握できません。
コンポーネントではなく影響で優先順位を付ける
各フローを、停止時の影響で分類します。収益損失、運用要件の未達、データ露出、サポートの停滞、または単なる見た目の劣化です。次に、その影響を実証する測定値を特定します。ユーザー登録ならアカウント作成の確認、インポートなら保留中の最古要素の経過時間、請求連携なら回復可能または確定状態で終了する操作の割合が該当します。
重要な経路については、PHPプロセスの外部から合成チェックを維持することが推奨されます。内部チェックではプロセスが稼働していることを示せても、ロードバランシング、認証情報、セッションストレージ、業務経路が一体として機能していることまでは示せません。
判断につながりやすい4つのアラート分類
知覚される可用性は、代表的な操作を完了できるかを測定します。合成チェックと、重要なルートの正常応答率を組み合わせることができます。どちらのデータも診断では併存できますが、単独プロセスへのアラートより価値があります。
業務エラーは、HTTPステータスコードでは分からない不正な結果を捉えます。予期せず失敗するバリデーション、内部変更による支払い拒否、生成されないドキュメント、不可能な状態遷移などです。不必要な個人情報を含めずに調査できる識別子を持つドメインイベントを使用すべきです。
レイテンシは平均値だけでなく、ルートごとおよびパーセンタイルごとに測定する必要があります。許容可能な平均値が、極端に遅い少数のリクエストを隠すことがあります。レイテンシが継続し、重要な操作に影響する場合にアラートを出してください。短時間のスパイクは、担当者を起こすのではなく観測を要する場合があります。
処理遅延は、ジョブが受理されてから完了するまでの時間を測定します。特にキューでは重要です。コンシューマーが必要な期限内に処理を完了できるなら、メッセージ総数が多くても必ずしも緊急性を意味しないためです。
ベースラインからしきい値を定義する
一般的なCPU、レイテンシ、キューサイズの値をそのままコピーしないでください。予測可能なピークを含め、時間帯および負荷種別ごとのベースラインを収集します。その後、影響に基づいて水準を定義します。ユーザーの期待、運用ウィンドウ、内部義務に違反するまでに、フローがどれだけ遅延できるかです。
堅牢なルールは、評価ウィンドウ、最小継続時間、規模、範囲の4要素を組み合わせます。たとえば、エラー増加を検出するだけでは不十分です。増加が複数のウィンドウで継続し、フローの操作に占める有意な割合であることを定めます。これにより、一時的なデプロイ、正常なリトライ、孤立した異常トラフィックによる通知を減らせます。
バージョンをインストールするデプロイと、ユーザー向けの挙動変更を有効化するリリースを区別してください。どちらも重要なコンテキストですが、同義ではありません。デプロイ後のアラートはロールバックまたは技術的調査の手掛かりになり得ます。一方、段階的有効化後のアラートでは、コードをロールバックする前に変更の露出を停止する必要がある場合があります。
キュー、データベース、外部連携
キュー:経過時間と実効処理能力を監視する
重要な各キューについて、保留中の最古ジョブの経過時間、流入率、完了率、恒久的失敗、リトライを測定してください。利用可能なコンシューマーと実行時間に関するシグナルも追加します。最もアクショナブルなアラートは通常、経過時間に基づきます。遅延をフローのコミットメントへ直接結び付けるためです。
キューの増加は、処理能力を超えるか期限を脅かすまで診断情報です。経過時間、エラー、コンシューマー不足が同時に増える場合、メトリクスごとに通知するのではなく、処理劣化の可能性としてこれらの症状をまとめて通知すべきです。
データベースでは、接続枯渇、継続的な接続エラー、長時間のロック、遅いまたは失敗するルートにつながるクエリレイテンシを優先します。可観測性で特定された高コストなクエリは最適化のためのシグナルです。サービス症状を発生させた時点でアラートになります。外部APIでは、可用性、レイテンシ、エラーコード、クォータ制限、リトライを測定してください。回復可能な失敗と恒久的な失敗を分け、キュー、キャッシュ、縮退モード、または手動手順があるかを確認します。
コンテキストを添付し、対応を分類する
通知には、影響を受けたサービスとフローの名称、重大度、開始時刻と推移、推定範囲、リージョンまたは環境、ルールを発火させたメトリクス、最近デプロイされたバージョンまたは有効化された変更、調査用ダッシュボードへのアクセスを含めるべきです。また、コンシューマーの状態確認、依存先の認証情報の検証、段階的有効化の一時停止、カテゴリ別エラーの確認など、安全な初動も含めます。
キューの消去や無差別な再起動のような、破壊的な自動指示は避けてください。復旧自動化には、制限、記録、可逆性、人によるレビューへエスカレーションする明確な条件が必要です。
- 情報提供:現時点では影響がなく、営業時間中に観測すべき異常。
- 計画的介入:期限を脅かすものの、余裕と運用上の代替手段がある劣化。
- 即時エスカレーション:重要な操作が利用不能、データリスク、回復不能な蓄積、または既知の緩和策なく影響が拡大している状態。
アラート疲れを防ぎ、各ルールを見直す
同一イベントを重複排除し、アラートを推定原因ごとにグループ化し、インシデントが継続中は繰り返しを制限してください。二次アラートは主アラートを充実させるべきであり、競合してはなりません。外部プロバイダーの障害がリトライ、アプリケーションエラー、キュー遅延を引き起こす場合、中心となる通知は推定される依存先を説明し、相関する症状を添付すべきです。
各インシデント後には、早期アラートが不足していたか、判断につながらない通知はどれか、原因特定にどの証拠が役立ったかを見直してください。定型的な確認しか生まないルールは削除または重要度を下げます。結果を定性的に測定します。受信者が散在するコンテキストを探さずに影響を理解し、適切な初動を実行できるなら、そのルールは役割を果たしています。
非同期フローの設計例
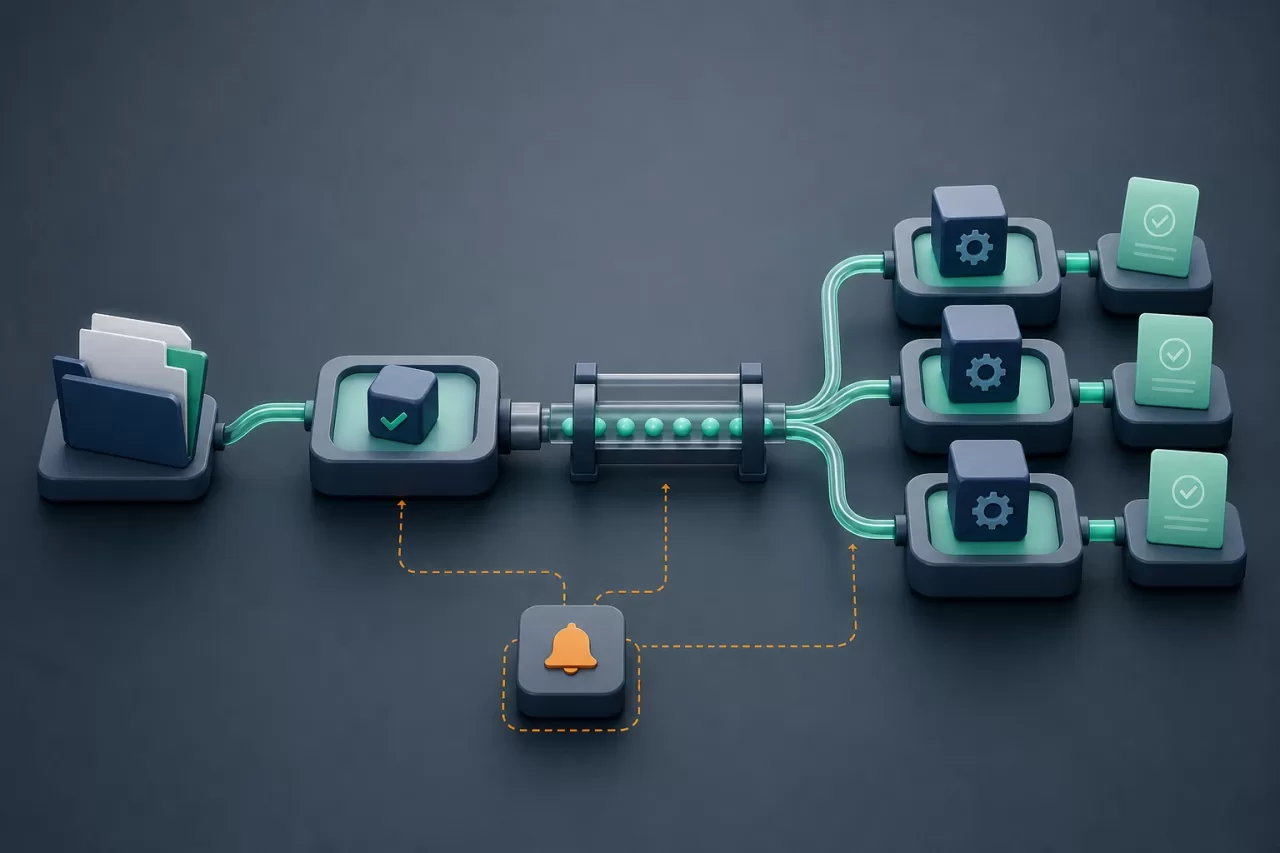
ファイルの受信、検証、後続処理から成るフローを想定します。PHPリクエストは、メタデータを保存してジョブを公開した後に受信を確認します。コンシューマーはコンテンツを検証し、結果を生成します。アラートは、キューにメッセージが含まれていることの検出だけに限定すべきではありません。
- 相当な割合のリクエストで受信が継続的に失敗する場合の可用性アラート。
- 保留中ジョブの経過時間が、結果を提供する許容期限を超える場合の遅延アラート。
- ユーザーが送信した無効なファイルと区別し、内部原因によるバリデーション失敗が増加した場合の品質アラート。
- ストレージまたは必要なAPIが継続的に失敗応答を返し、有効な自動復旧経路が存在しない場合の依存関係アラート。
新しいルールを公開する際は、最後に以下を確認してください。フローと所有者が定義されていること、影響が運用上の用語で表現されていること、ベースラインが利用可能であること、しきい値にウィンドウと継続時間があること、重大度が正当化されていること、重複排除が設定されていること、コンテキストが添付されていること、安全な初動が文書化されていること、レビューが予定されていること。このフィルターにより、PHPアプリケーションのアクショナブルなアラートは、別の中断要因ではなく意思決定システムになります。