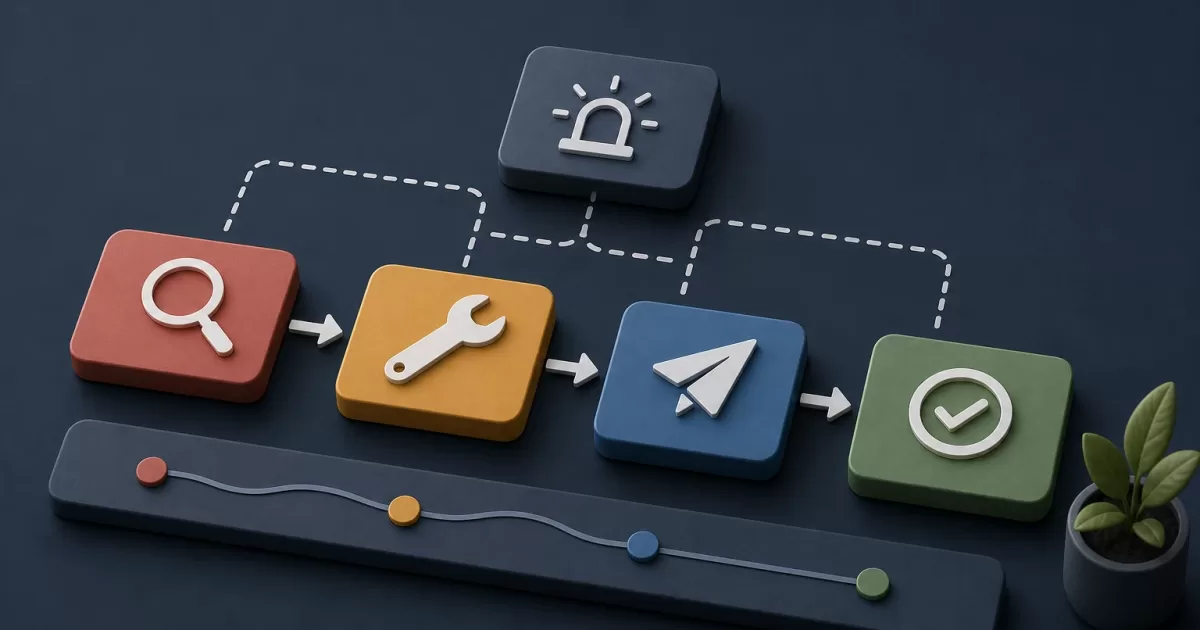
Een applicatie kan tientallen technische metrics in het rood hebben en toch de primaire service blijven leveren. Het tegenovergestelde kan ook gebeuren: CPU, geheugen en connectiviteit lijken normaal, maar gebruikers kunnen een kritieke handeling niet voltooien. Het doel van actiegerichte alerts voor PHP-applicaties is niet om elke anomalie te detecteren, maar om te waarschuwen wanneer iemand een concrete beslissing moet nemen om een operationeel gevolg te beperken.
Een bruikbare alert beantwoordt, nog vóór een dashboard wordt geopend, vier vragen: welke dienstfunctionaliteit wordt geraakt, wie wordt getroffen, sinds wanneer en welke eerste actie veilig is. Als een alert niet helpt om een hypothese te formuleren of een interventie te kiezen, is het waarschijnlijk diagnostische telemetrie en geen on-callalert.
Signalen, symptomen en incidenten scheiden
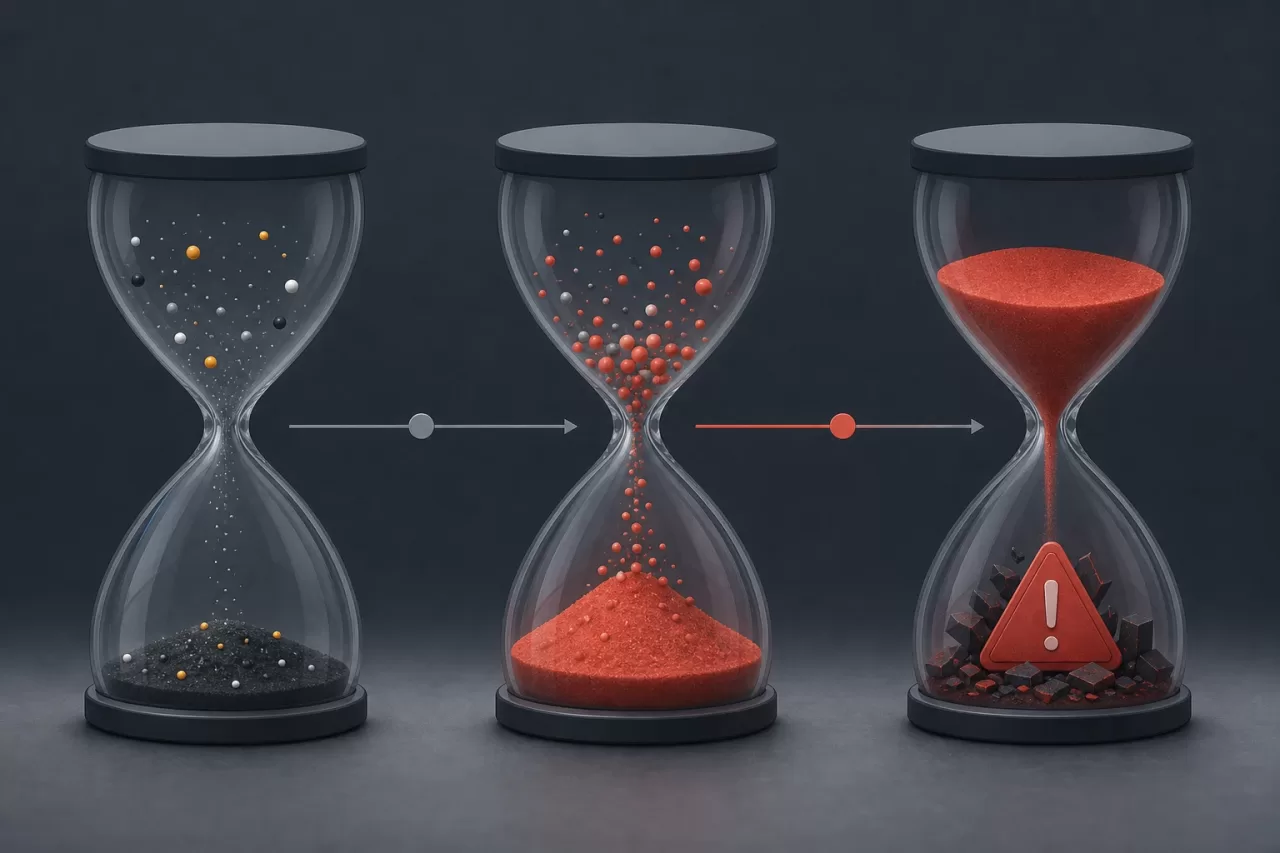
Een signaal is een geïsoleerde observatie: toegenomen gebruik van verbindingen, herstarts van PHP-FPM-processen, groei van een queue of een trage respons van een API. Een symptoom drukt waarneembare degradatie van de service uit: meer fouten bij het bevestigen van bestellingen, kritieke jobs die niet binnen de termijn eindigen of een aanhoudende toename van de latency van een relevante route. Een incident is de situatie die vanwege de werkelijke of voorzienbare impact coördinatie en respons vereist.
Dit onderscheid voorkomt dat elke infrastructuurmetric in een onderbreking verandert. Zo kan een tijdelijke CPU-verzadiging nuttig zijn om capaciteit te onderzoeken. Die moet escaleren naar een alert als deze samenvalt met mislukte requests of met latency die het gebruik van een prioritaire functie verhindert. Evenzo verdient een hoog aantal PHP-exceptions aandacht wanneer dit zich concentreert in een bedrijfsoperatie of een relevant aandeel van de requests treft, niet alleen omdat het in de logs voorkomt.
- Diagnostische signalen: schijfgebruik, aantal processen, cache hits, individuele retries of exception traces.
- Alertwaardige symptomen: onbeschikbaarheid, een aanhoudend foutenpercentage in een kritieke flow, verwerkingsvertraging of dreigende uitputting van een resource met aantoonbaar effect.
- Incidentindicatoren: gebruikersbereik, mogelijk verlies of duplicatie van data, het niet halen van een operationele termijn en het ontbreken van een redelijk handmatig alternatief.
Een minimale servicemap opbouwen
Teken vóór je drempelwaarden vastlegt het traject van de relevante flows. Het is niet nodig om het hele platform te inventariseren: het volstaat om de routes weer te geven die waarde leveren of risico creëren. In een gebruikelijke PHP-applicatie komen het webrequest, authenticatie, domeinlogica, database, cache, publicatie naar een queue, asynchrone consumers en API's van derden voor.
Documenteer voor elk onderdeel welke invoer het ontvangt, welk waarneembaar resultaat het moet opleveren, welke dependency het nodig heeft en hoe het zich bij een fout gedraagt. Een request kan correct antwoorden nadat het een job in de queue heeft geplaatst, hoewel de uiteindelijke actie nog niet is voltooid. Daarom blijft het team blind voor vertragingen of fouten in de asynchrone verwerking als het alleen de HTTP-statuscode van de weblaag bewaakt.
Prioriteren op gevolgen, niet op componenten
Classificeer elke flow op basis van het gevolg als deze stopt: omzetverlies, operationele non-compliance, blootstelling van data, blokkering van support of louter esthetische degradatie. Identificeer daarna een meting die het gevolg bewijst. Voor een gebruikersregistratie kan dat de bevestigde creatie van het account zijn; voor een import de leeftijd van het oudste openstaande item; voor een factureringsintegratie het percentage operaties dat eindigt in een herstelbare of definitieve status.
Het is raadzaam om synthetische checks buiten het PHP-proces te onderhouden voor essentiële trajecten. Een interne check kan aangeven dat het proces draait, maar niet dat load balancing, credentials, sessieopslag en de bedrijfsroute als geheel werken.
De vier alertfamilies die doorgaans tot een beslissing leiden
De ervaren beschikbaarheid meet of een representatieve handeling kan worden voltooid. Deze kan een synthetische check combineren met het percentage correcte responses van kritieke routes. Dit is waardevoller dan alerten op een geïsoleerd proces, ook al kunnen beide gegevens naast elkaar bestaan in de diagnose.
Businessfouten vangen onjuiste resultaten op die een HTTP-statuscode niet blootlegt: validaties die onverwacht falen, betalingen die door een interne wijziging worden afgewezen, documenten die niet worden gegenereerd of onmogelijke statustransities. Ze moeten domeinevents gebruiken met identifiers die onderzoek mogelijk maken zonder onnodige persoonsgegevens op te nemen.
Latency moet per route en per percentiel worden gemeten, niet alleen via gemiddelden. Een aanvaardbaar gemiddelde kan een minderheid van extreem trage requests verbergen. Alarmeer wanneer latency aanhoudt en een relevante operatie treft; een korte piek kan observatie vereisen, niet het wekken van iemand.
Verwerkingsvertraging meet de tijd vanaf het moment dat een job wordt geaccepteerd tot deze voltooid is. Dit is vooral belangrijk bij queues, omdat het totale aantal berichten niet altijd urgentie impliceert: een grote ophoping kan normaal zijn als consumers deze binnen de vereiste termijn verwerken.
Drempelwaarden vanuit de baseline definiëren
Kopieer geen generieke waarde voor CPU, latency of queuegrootte. Verzamel een baseline per tijdsblok en per type belasting, inclusief voorspelbare pieken. Bepaal daarna het niveau op basis van de impact: hoe lang een flow mag duren voordat deze niet meer voldoet aan een gebruikersverwachting, een operationeel tijdvenster of een interne verplichting.
Een robuuste regel combineert vier elementen: een evaluatievenster, minimale persistentie, omvang en bereik. Het is bijvoorbeeld niet genoeg om een toename van fouten te detecteren; leg vast dat de toename meerdere vensters aanhoudt en een significant deel van de operaties van de flow vertegenwoordigt. Zo worden meldingen door tijdelijke deployments, correcte retries of geïsoleerd afwijkend verkeer verminderd.
Maak onderscheid tussen de deployment, die een versie installeert, en de release, die een gedragswijziging voor gebruikers inschakelt. Beide zijn relevante context, maar zijn niet hetzelfde. Een alert na een deployment kan een rollback of technisch onderzoek sturen; een alert na een geleidelijke activering kan vereisen dat de blootstelling van de wijziging wordt gestopt voordat code wordt teruggedraaid.
Queues, database en externe integraties
Queues: leeftijd en effectieve capaciteit bewaken
Meet voor elke kritieke queue de leeftijd van de oudste openstaande job, de instroomsnelheid, de voltooiingssnelheid, definitieve fouten en retries. Voeg signalen toe over beschikbare consumers en uitvoeringsduur. De meest actiegerichte alert is doorgaans gebaseerd op leeftijd: deze brengt de vertraging rechtstreeks in verband met de vereiste termijn van de flow.
Groei van de queue is diagnostisch totdat deze de verwerkingscapaciteit overschrijdt of een termijn bedreigt. Als de leeftijd en de fouten tegelijkertijd toenemen en er consumers ontbreken, moet de melding deze symptomen groeperen onder een mogelijke degradatie van de verwerking, in plaats van er één per metric te versturen.
Geef in de database prioriteit aan uitputting van verbindingen, aanhoudende verbindingsfouten, langdurige locks en querylatency die zich vertaalt in trage of mislukte routes. Een kostbare query die in observability wordt vastgesteld, is een signaal voor optimalisatie; het wordt een alert wanneer deze een servicesymptoom veroorzaakt. Meet voor externe API's beschikbaarheid, latency, foutcodes, quotumlimieten en retries. Scheid herstelbare fouten van definitieve fouten en controleer of er een queue, cache, degraded mode of handmatige procedure bestaat.
Context toevoegen en de respons classificeren
Een melding moet de naam van de getroffen service en flow, ernst, begin en verloop, geschat bereik, regio of omgeving, metrics die de regel activeerden, recent gedeployde versie of geactiveerde wijziging en toegang tot onderzoeksdashboards bevatten. Neem ook veilige eerste stappen op: de status van consumers controleren, credentials van een dependency valideren, een geleidelijke activering pauzeren of fouten per categorie verifiëren.
Vermijd destructieve automatische instructies, zoals een queue leegmaken of willekeurig herstarten. Herstelautomatisering moet limieten, logging, omkeerbaarheid en een duidelijke voorwaarde hebben om naar menselijke beoordeling te escaleren.
- Informatief: anomalie zonder huidige impact die tijdens kantooruren moet worden geobserveerd.
- Geplande interventie: degradatie die een termijn bedreigt, maar ruimte en een operationeel alternatief heeft.
- Onmiddellijke escalatie: kritieke operatie niet beschikbaar, datarisico, onherstelbare ophoping of toenemende impact zonder bekende mitigatie.
Alertmoeheid voorkomen en elke regel herzien
Dedupliceer identieke events, groepeer alerts op vermoedelijke oorzaak en beperk herhaling zolang het incident open blijft. Een secundaire alert moet de hoofdalert verrijken, niet ermee concurreren. Als een externe provider faalt en retries, applicatiefouten en vertragingen in de queue veroorzaakt, moet de centrale melding de vermoedelijke dependency beschrijven en de gecorreleerde symptomen bijvoegen.
Beoordeel na elk incident of een vroege alert ontbrak, welke alert arriveerde zonder een beslissing op te leveren en welk bewijs hielp om de oorzaak te identificeren. Verwijder of verlaag regels die alleen routinematige bevestigingen genereren. Meet het resultaat kwalitatief: als de ontvanger de impact begrijpt en een passende eerste stap uitvoert zonder verspreide context te moeten opzoeken, vervult de regel zijn functie.
Voorbeeld van ontwerp voor een asynchrone flow
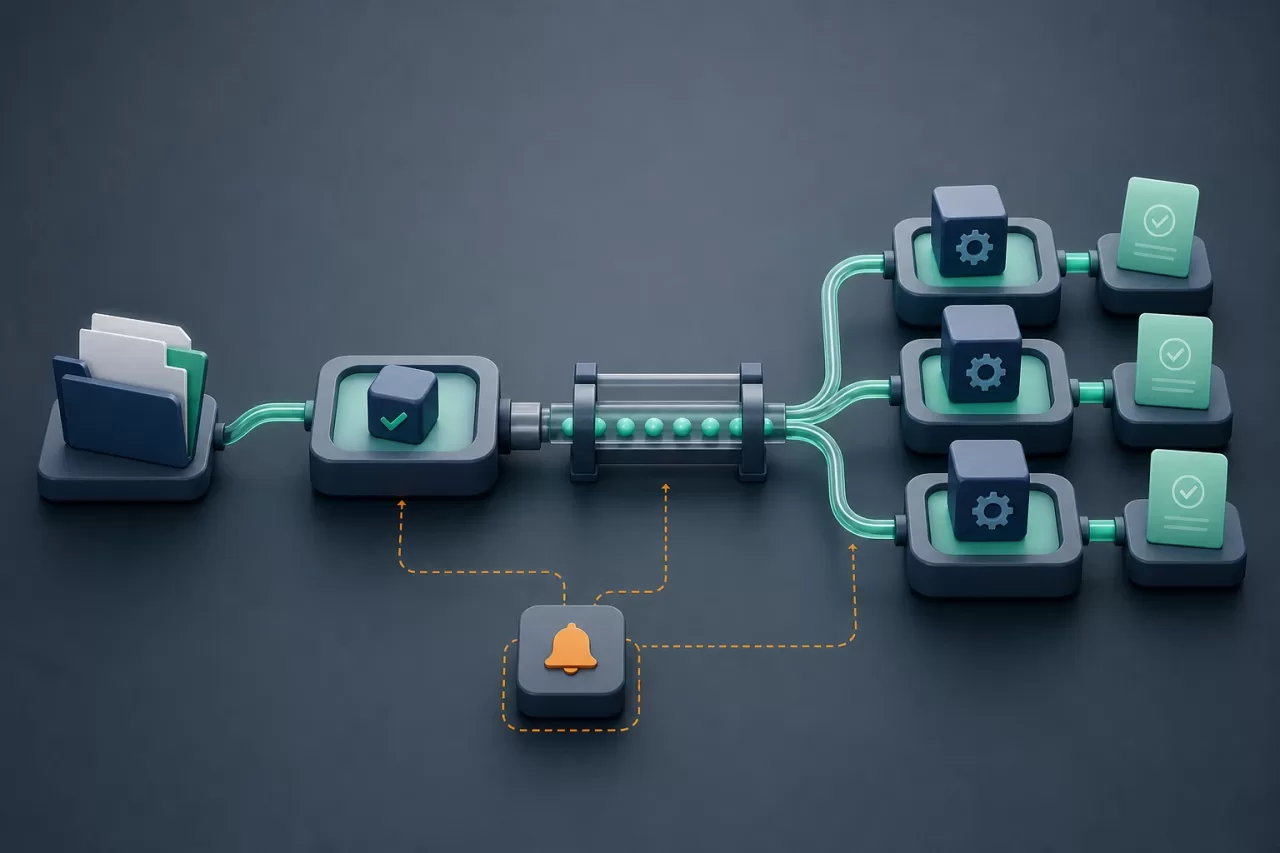
Stel je een flow voor voor ontvangst, validatie en verdere verwerking van bestanden. Het PHP-request bevestigt de ontvangst nadat metadata is opgeslagen en een job is gepubliceerd. De consumers valideren de inhoud en genereren een resultaat. De alerts mogen niet beperkt blijven tot het detecteren dat de queue berichten bevat.
- Beschikbaarheidsalert als de ontvangst gedurende langere tijd faalt voor een relevant aandeel van de requests.
- Vertragingsalert als de leeftijd van de openstaande job de aanvaardbare termijn voor het leveren van het resultaat overschrijdt.
- Kwaliteitsalert als validatiefouten door een interne oorzaak toenemen, waarbij deze worden onderscheiden van ongeldige bestanden die door gebruikers zijn verzonden.
- Dependency-alert als opslag of een vereiste API met aanhoudende fouten antwoordt en er geen effectieve automatische herstelroute bestaat.
Controleer ten slotte bij het publiceren van een nieuwe regel: flow en eigenaar gedefinieerd, impact uitgedrukt in operationele termen, baseline beschikbaar, drempelwaarde met venster en persistentie, ernst onderbouwd, deduplicatie geconfigureerd, context toegevoegd, veilige eerste stap gedocumenteerd en herziening gepland. Dit filter maakt van actiegerichte alerts voor PHP-applicaties een besluitvormingssysteem, en niet nog een bron van onderbrekingen.