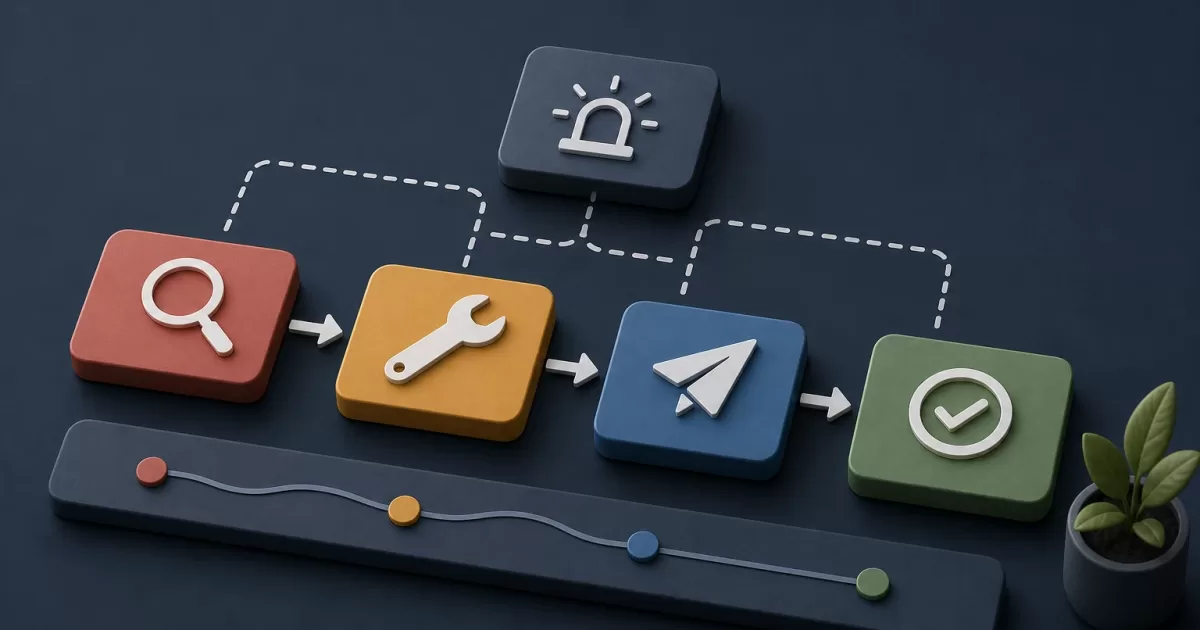
У приложения могут быть десятки технических метрик в красной зоне, и при этом оно всё ещё может предоставлять основной сервис. Возможна и обратная ситуация: процессор, память и сетевое подключение выглядят нормально, но пользователи не могут завершить критически важную операцию. Цель алертов, требующих действий, для PHP-приложений — не выявлять каждую аномалию, а уведомлять, когда человеку необходимо принять конкретное решение, чтобы ограничить операционные последствия.
Полезный алерт ещё до открытия дашборда отвечает на четыре вопроса: какая функция сервиса затронута, кого это затрагивает, с какого момента и какое первоначальное действие безопасно. Если он не позволяет сформулировать гипотезу или принять решение о вмешательстве, вероятно, это диагностическая телеметрия, а не алерт для дежурства.
Разделяйте сигналы, симптомы и инциденты
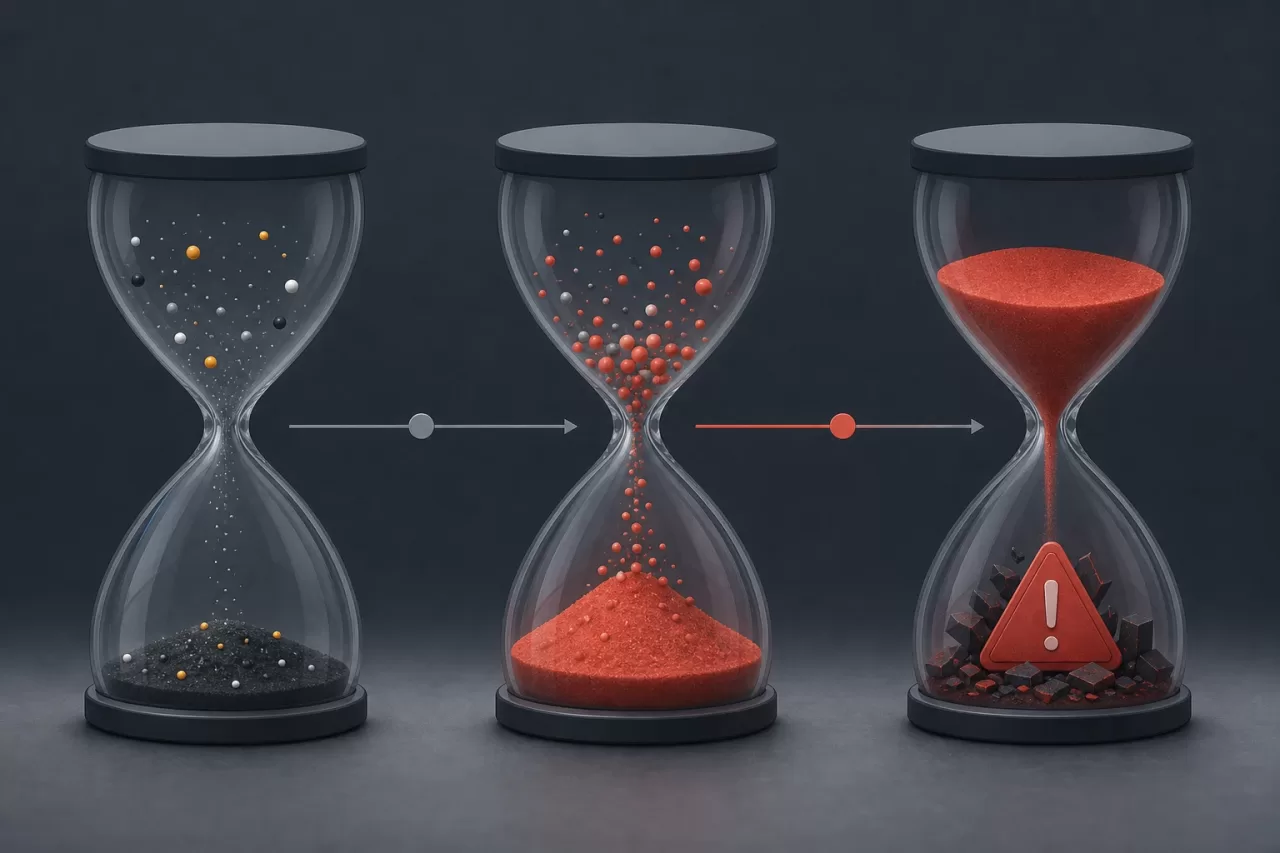
Сигнал — это отдельное наблюдение: рост использования подключений, перезапуски процессов PHP-FPM, увеличение очереди или медленный ответ внешнего интерфейса. Симптом выражает наблюдаемую деградацию сервиса: больше ошибок при подтверждении заказов, критически важные задания не завершаются в срок или устойчивый рост задержки значимого маршрута. Инцидент — это ситуация, требующая координации и реагирования из-за её фактического или предсказуемого воздействия.
Это различие позволяет не превращать каждую инфраструктурную метрику в перебой. Например, кратковременная перегрузка процессора может быть полезна для исследования ёмкости. Она должна эскалироваться до алерта, если совпадает с неуспешными запросами или с задержкой, не позволяющей использовать приоритетную функцию. Аналогично, большое количество PHP-исключений заслуживает внимания, когда оно сосредоточено в бизнес-операции или затрагивает существенную долю запросов, а не только потому, что исключения присутствуют в логах.
- Диагностические сигналы: использование диска, число процессов, коэффициент попаданий в кэш, отдельные повторные попытки или трассировки исключений.
- Симптомы для алертинга: недоступность, устойчивая доля сбоев в критическом потоке, задержка обработки или близкое исчерпание ресурса с проверяемым эффектом.
- Индикаторы инцидента: охват пользователей, возможная потеря или дублирование данных, нарушение операционного срока и отсутствие разумной ручной альтернативы.
Постройте минимальную карту сервиса
Прежде чем задавать пороги, нарисуйте путь значимых потоков. Не нужно инвентаризировать всю платформу: достаточно представить маршруты, создающие ценность или риск. В типичном PHP-приложении это веб-запрос, аутентификация, доменная логика, база данных, кэш, публикация в очередь, асинхронные потребители и сторонние интерфейсы.
Для каждого участка задокументируйте, какие входные данные он получает, какой наблюдаемый результат должен выдавать, от какой зависимости зависит и как ведёт себя при сбое. Запрос может корректно ответить после постановки задания в очередь, хотя финальное действие ещё не завершено. Поэтому мониторинг только HTTP-кода веб-слоя оставляет команду в неведении относительно задержек или ошибок асинхронной обработки.
Приоритизируйте по последствиям, а не по компонентам
Классифицируйте каждый поток по последствиям его остановки: потеря дохода, нарушение операционных обязательств, раскрытие данных, блокирование поддержки или просто эстетическая деградация. Затем определите измерение, подтверждающее это последствие. Для регистрации пользователя это может быть подтверждённое создание учётной записи; для импорта — возраст самого старого ожидающего элемента; для биллинговой интеграции — процент операций, завершающихся в восстанавливаемом или окончательном состоянии.
Для ключевых сценариев стоит поддерживать синтетические проверки, выполняемые вне PHP-процесса. Внутренняя проверка может показать, что процесс работает, но не то, что балансировка, учётные данные, хранилище сессий и бизнес-маршрут работают совместно.
Четыре семейства алертов, которые обычно помогают принять решение
Воспринимаемая доступность измеряет, можно ли завершить репрезентативную операцию. Она может сочетать синтетическую проверку с процентом успешных ответов критических маршрутов. Это ценнее, чем алерт по отдельному процессу, хотя оба показателя могут сосуществовать в диагностике.
Бизнес-ошибки фиксируют некорректные результаты, которые HTTP-код не выявляет: неожиданно неудачные валидации, отклонённые платежи из-за внутреннего изменения, несгенерированные документы или невозможные переходы состояния. Они должны использовать доменные события с идентификаторами, позволяющими расследование без включения ненужной персональной информации.
Задержку следует измерять по маршруту и по перцентилям, а не только средними значениями. Приемлемое среднее может скрывать меньшинство чрезмерно медленных запросов. Отправляйте алерт, когда задержка сохраняется и затрагивает значимую операцию; кратковременный всплеск может требовать наблюдения, а не пробуждения человека.
Задержка обработки измеряет время с момента принятия задания до его завершения. Это особенно важно для очередей, поскольку общее число сообщений не всегда означает срочность: большое накопление может быть нормальным, если потребители обрабатывают его в требуемый срок.
Определяйте пороги на основе базовой линии
Не копируйте типовое значение использования процессора, задержки или размера очереди. Соберите базовую линию по временным интервалам и типам нагрузки, включая ожидаемые пики. Затем определите уровень исходя из воздействия: сколько может длиться поток, прежде чем нарушит ожидание пользователя, операционное окно или внутреннее обязательство.
Надёжное правило сочетает четыре элемента: окно оценки, минимальную продолжительность, величину и охват. Например, недостаточно обнаружить рост ошибок; задайте, чтобы рост сохранялся в течение нескольких окон и представлял значимую долю операций потока. Так сокращаются уведомления из-за кратковременных эффектов развёртывания, успешных повторных попыток или единичного аномального трафика.
Различайте развёртывание, которое устанавливает версию, и релиз, который включает изменение поведения для пользователей. Оба представляют значимый контекст, но не равнозначны. Алерт после развёртывания может указывать на необходимость отката или технического расследования; алерт после постепенной активации может потребовать остановить распространение изменения до отката кода.
Очереди, база данных и внешние интеграции
Очереди: отслеживайте возраст и фактическую производительность
Для каждой критической очереди измеряйте возраст самого старого ожидающего задания, скорость поступления, скорость завершения, окончательные сбои и повторные попытки. Добавьте сигналы о доступных потребителях и длительности выполнения. Наиболее полезный алерт обычно основывается на возрасте: он напрямую связывает задержку с обязательством потока.
Рост очереди остаётся диагностическим показателем, пока не превышает пропускную способность обработки или не угрожает сроку. Если одновременно растут возраст, ошибки и нехватка потребителей, уведомление должно объединять эти симптомы в рамках возможной деградации обработки, а не отправляться по одному на метрику.
В базе данных приоритизируйте исчерпание подключений, устойчивые ошибки подключения, длительные блокировки и задержку запросов, которая приводит к медленным или неуспешным маршрутам. Ресурсоёмкий запрос, выявленный средствами наблюдаемости, — это сигнал для оптимизации; он становится алертом, когда вызывает симптом сервиса. Для внешних интерфейсов измеряйте доступность, задержку, коды ошибок, лимиты квот и повторные попытки. Разделяйте восстанавливаемые и окончательные сбои и проверяйте наличие очереди, кэша, деградированного режима или ручной процедуры.
Прикрепляйте контекст и классифицируйте ответ
Уведомление должно содержать название затронутых сервиса и потока, серьёзность, начало и развитие, предполагаемый охват, регион или окружение, метрики, сработавшие по правилу, недавно развёрнутую версию или включённое изменение, а также доступ к дашбордам для расследования. Также включайте безопасные первые шаги: проверить состояние потребителей, проверить учётные данные зависимости, приостановить постепенную активацию или проверить ошибки по категориям.
Избегайте разрушительных автоматических инструкций, таких как очистка очереди или неизбирательный перезапуск. Автоматизация восстановления должна иметь ограничения, журналирование, обратимость и чёткое условие для эскалации на проверку человеком.
- Информационный: аномалия без текущего воздействия, которую следует наблюдать в рабочее время.
- Плановое вмешательство: деградация, угрожающая сроку, но имеющая запас времени и операционную альтернативу.
- Немедленная эскалация: критическая операция недоступна, существует риск для данных, накопление, которое невозможно устранить, или растущее воздействие без известной меры смягчения.
Предотвращайте усталость и пересматривайте каждое правило
Дедуплицируйте идентичные события, группируйте алерты по вероятной причине и ограничивайте повторы, пока инцидент остаётся открытым. Вторичный алерт должен обогащать основной, а не конкурировать с ним. Если внешний провайдер даёт сбой и вызывает повторные попытки, ошибки приложения и задержки в очереди, центральное уведомление должно описывать вероятную зависимость и прикладывать коррелирующие симптомы.
После каждого инцидента анализируйте, не отсутствовал ли ранний алерт, какой из них пришёл без необходимости принятия решения и какие доказательства позволили установить причину. Удаляйте или понижайте уровень правил, которые создают лишь рутинные подтверждения. Оценивайте результат качественно: если получатель понимает воздействие и выполняет подходящий первый шаг без поиска разрозненного контекста, правило выполняет свою функцию.
Пример проектирования для асинхронного потока
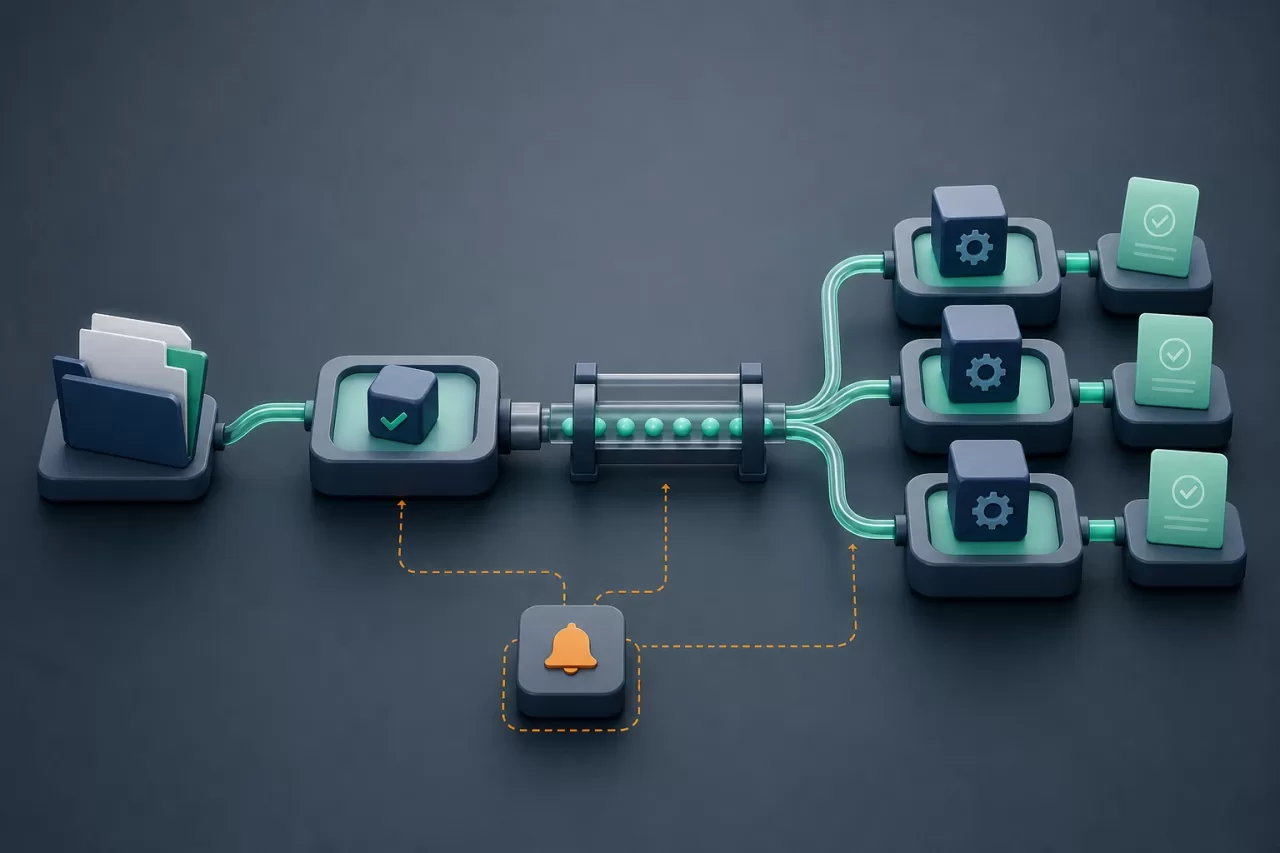
Представьте поток приёма, валидации и последующей обработки файлов. PHP-запрос подтверждает приём после сохранения метаданных и публикации задания. Потребители валидируют содержимое и формируют результат. Алерты не должны ограничиваться обнаружением того, что очередь содержит сообщения.
- Алерт доступности, если приём устойчиво завершается сбоем для значимой доли запросов.
- Алерт задержки, если возраст ожидающего задания превышает приемлемый срок доставки результата.
- Алерт качества, если растёт число сбоев валидации по внутренней причине, с отличием от недопустимых файлов, отправленных пользователями.
- Алерт зависимости, если хранилище или необходимый внешний интерфейс отвечает устойчивыми сбоями и отсутствует эффективный путь автоматического восстановления.
Перед публикацией нового правила окончательно проверьте: поток и владелец определены, воздействие выражено в операционных терминах, базовая линия доступна, порог имеет окно и продолжительность, серьёзность обоснована, дедупликация настроена, контекст приложен, безопасный первый шаг задокументирован и пересмотр запланирован. Этот фильтр превращает алерты, требующие действий, для PHP-приложений в систему принятия решений, а не в ещё один источник перебоев.