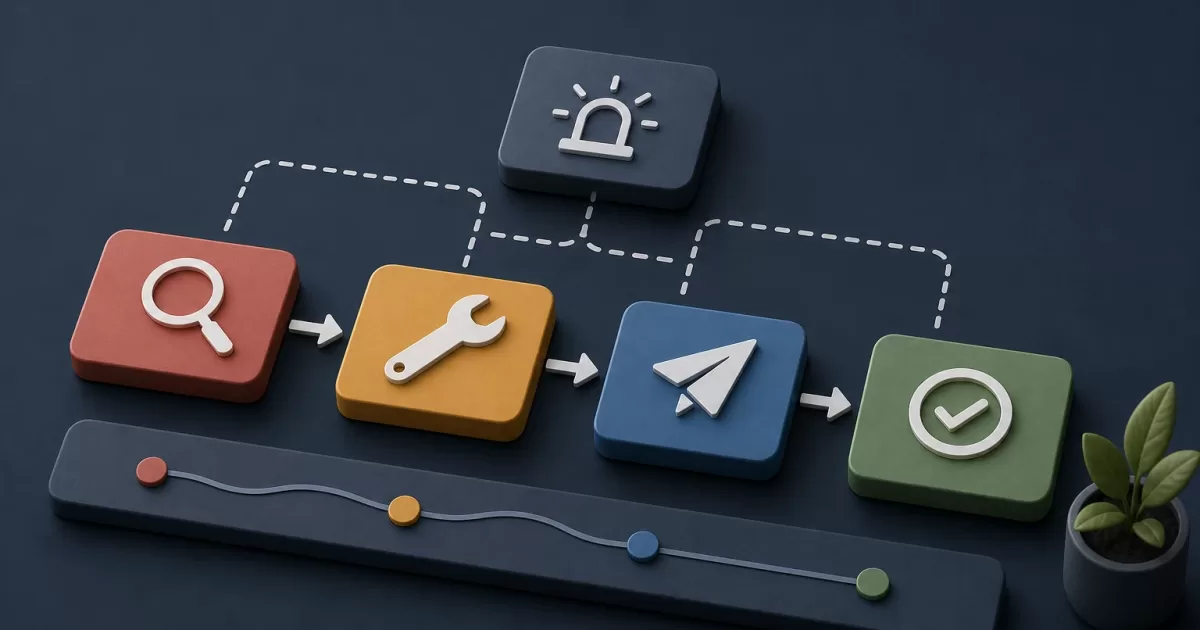
Un'applicazione può avere decine di metriche tecniche in rosso e, nonostante ciò, continuare a erogare il servizio principale. Può verificarsi anche il contrario: CPU, memoria e connettività sembrano normali, ma gli utenti non riescono a completare un'operazione critica. L'obiettivo degli alert azionabili per applicazioni PHP non è rilevare ogni anomalia, ma avvisare quando una persona deve prendere una decisione concreta per limitare una conseguenza operativa.
Un alert utile risponde, prima di aprire un dashboard, a quattro domande: quale funzionalità è interessata, chi è coinvolto, da quando e quale azione iniziale è sicura. Se non consente di formulare un'ipotesi o decidere un intervento, probabilmente è telemetria diagnostica, non un alert di reperibilità.
Separare segnali, sintomi e incidenti
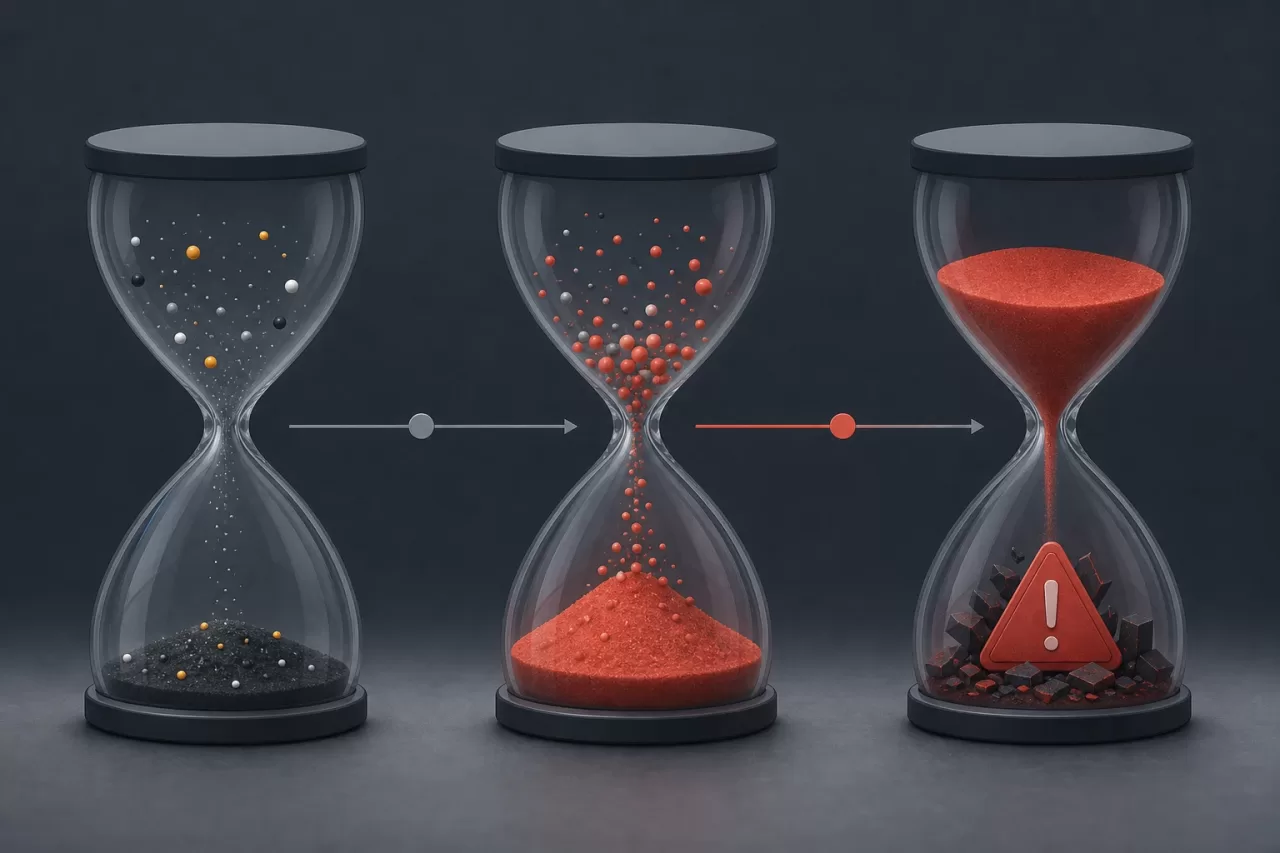
Un segnale è un'osservazione isolata: aumento dell'uso delle connessioni, riavvii dei processi PHP-FPM, crescita di una coda o risposta lenta di un'API. Un sintomo esprime un degrado osservabile del servizio: più errori nella conferma degli ordini, job critici che non terminano entro il tempo previsto o un aumento sostenuto della latenza di una route rilevante. Un incidente è la situazione che richiede coordinamento e risposta per il suo impatto reale o prevedibile.
Questa distinzione evita di trasformare ogni metrica dell'infrastruttura in un'interruzione. Per esempio, una saturazione transitoria della CPU può essere utile per analizzare la capacità. Deve diventare un alert se coincide con richieste non riuscite o con una latenza che impedisce di usare una funzionalità prioritaria. Analogamente, un numero elevato di eccezioni PHP merita attenzione quando si concentra in un'operazione di business o interessa una proporzione rilevante di richieste, non solo perché esiste nei log.
- Segnali diagnostici: utilizzo del disco, numero di processi, cache hit, singoli retry o trace delle eccezioni.
- Sintomi che richiedono alert: indisponibilità, tasso sostenuto di errori in un flusso critico, ritardo di elaborazione o esaurimento imminente di una risorsa con effetto verificabile.
- Indicatori di incidente: numero di utenti coinvolti, possibile perdita o duplicazione di dati, mancato rispetto di un termine operativo e assenza di un'alternativa manuale ragionevole.
Costruire una mappa minima del servizio
Prima di definire le soglie, disegna il percorso dei flussi rilevanti. Non è necessario inventariare l'intera piattaforma: basta rappresentare le route che erogano valore o generano rischio. In una tipica applicazione PHP compaiono la richiesta web, l'autenticazione, la logica di dominio, il database, la cache, la pubblicazione in coda, i consumer asincroni e le API di terze parti.
Per ogni tratto, documenta quale input riceve, quale risultato osservabile deve produrre, da quale dipendenza ha bisogno e come si comporta in caso di errore. Una richiesta può rispondere correttamente dopo aver accodato un job, anche se l'azione finale non è ancora stata completata. Per questo, monitorare solo il codice HTTP del layer web rende il team cieco rispetto a ritardi o errori nell'elaborazione asincrona.
Dare priorità alle conseguenze, non ai componenti
Classifica ogni flusso in base alla sua conseguenza se si arresta: perdita di ricavi, mancato rispetto operativo, esposizione di dati, blocco del supporto o semplice degrado estetico. Quindi identifica una misurazione che dimostri la conseguenza. Per una registrazione utente può essere la creazione confermata dell'account; per un'importazione, l'età dell'elemento in attesa più vecchio; per un'integrazione di fatturazione, la percentuale di operazioni che termina in uno stato recuperabile o definitivo.
È opportuno mantenere controlli sintetici dall'esterno del processo PHP per i percorsi essenziali. Un controllo interno può indicare che il processo è attivo, ma non che il load balancing, le credenziali, l'archiviazione delle sessioni e il percorso di business funzionino congiuntamente.
Le quattro famiglie di alert che solitamente supportano una decisione
La disponibilità percepita misura se è possibile completare un'operazione rappresentativa. Può combinare un controllo sintetico con la percentuale di risposte corrette delle route critiche. È più preziosa di un alert relativo a un processo isolato, anche se entrambi i dati possono coesistere nella diagnostica.
Gli errori di business rilevano risultati errati che un codice HTTP non mostra: validazioni che falliscono inaspettatamente, pagamenti rifiutati a causa di una modifica interna, documenti non generati o transizioni di stato impossibili. Devono utilizzare eventi di dominio con identificatori che consentano di investigare senza includere informazioni personali non necessarie.
La latenza va misurata per route e per percentili, non solo tramite medie. Una media accettabile può nascondere una minoranza di richieste eccessivamente lente. Genera un alert quando la latenza persiste e interessa un'operazione rilevante; un picco breve può richiedere osservazione, non svegliare una persona.
Il ritardo di elaborazione misura il tempo da quando un job viene accettato fino al suo completamento. È particolarmente importante nelle code perché il numero totale di messaggi non implica sempre urgenza: un grande accumulo può essere normale se i consumer lo smaltiscono entro il tempo richiesto.
Definire soglie dalla baseline
Non copiare un valore generico di CPU, latenza o dimensione della coda. Raccogli una baseline per fascia oraria e per tipo di carico, inclusi i picchi prevedibili. Definisci poi il livello in base all'impatto: quanto può ritardare un flusso prima di non soddisfare un'aspettativa dell'utente, una finestra operativa o un obbligo interno.
Una regola solida combina quattro elementi: una finestra di valutazione, persistenza minima, magnitudine e portata. Per esempio, non basta rilevare un aumento degli errori; stabilisci che l'aumento persista per diverse finestre e rappresenti una frazione significativa delle operazioni del flusso. In questo modo si riducono gli avvisi dovuti a deployment transitori, retry corretti o traffico anomalo isolato.
Distingui il deployment, che installa una versione, dal rilascio, che abilita una modifica del comportamento per gli utenti. Entrambi sono contesto rilevante, ma non equivalgono. Un alert dopo un deployment può orientare una reversione o un'indagine tecnica; un alert dopo un'attivazione graduale può richiedere di interrompere l'esposizione della modifica prima di effettuare la reversione del codice.
Code, database e integrazioni esterne
Code: monitorare l'età e la capacità effettiva
Per ogni coda critica, misura l'età del job in attesa più vecchio, il tasso di ingresso, il tasso di completamento, gli errori definitivi e i retry. Aggiungi segnali relativi ai consumer disponibili e alla durata di esecuzione. L'alert più azionabile si basa solitamente sull'età: collega direttamente il ritardo all'impegno assunto per il flusso.
La crescita della coda è diagnostica finché non supera la capacità di smaltimento o minaccia un termine operativo. Se aumentano contemporaneamente l'età, gli errori e la mancanza di consumer, l'avviso deve raggruppare questi sintomi sotto un possibile degrado dell'elaborazione, invece di inviarne uno per metrica.
Nel database, dai priorità all'esaurimento delle connessioni, agli errori di connessione sostenuti, ai lock prolungati e alla latenza delle query che si traduca in route lente o non riuscite. Una query costosa identificata nell'osservabilità è un segnale per l'ottimizzazione; diventa un alert quando genera un sintomo del servizio. Per le API esterne, misura disponibilità, latenza, codici di errore, limiti di quota e retry. Separa gli errori recuperabili da quelli definitivi e verifica se esistono coda, cache, modalità degradata o procedura manuale.
Allegare contesto e classificare la risposta
Una notifica dovrebbe includere il nome del servizio e del flusso interessati, gravità, inizio ed evoluzione, portata stimata, regione o ambiente, metriche che hanno attivato la regola, versione oggetto del deployment o modifica attivata di recente e accesso ai dashboard di indagine. Includi anche primi passi sicuri: controllare lo stato dei consumer, convalidare le credenziali di una dipendenza, sospendere un'attivazione graduale o verificare gli errori per categoria.
Evita istruzioni automatiche distruttive, come svuotare una coda o riavviare indiscriminatamente. L'automazione del ripristino deve avere limiti, registrazione, reversibilità e una condizione chiara per l'escalation alla revisione umana.
- Informativo: anomalia senza impatto attuale che deve essere osservata durante l'orario lavorativo.
- Intervento pianificato: degrado che minaccia un termine operativo, ma dispone di margine e alternativa operativa.
- Escalation immediata: operazione critica non disponibile, rischio per i dati, accumulo irrecuperabile o impatto crescente senza mitigazione nota.
Evitare l'affaticamento da alert e rivedere ogni regola
Deduplica gli eventi identici, raggruppa gli alert per causa probabile e limita la ripetizione mentre l'incidente rimane aperto. Un alert secondario deve arricchire quello principale, non competere con esso. Se un provider esterno fallisce e provoca retry, errori dell'applicazione e ritardi in coda, la notifica centrale deve descrivere la dipendenza probabile e allegare i sintomi correlati.
Dopo ogni incidente, verifica se è mancato un alert precoce, quale è arrivato senza generare una decisione e quali evidenze hanno consentito di identificare la causa. Rimuovi o declassa le regole che generano solo conferme di routine. Misura il risultato qualitativamente: se la persona destinataria comprende l'impatto ed esegue un primo passo appropriato senza cercare contesto disperso, la regola sta svolgendo la sua funzione.
Esempio di progettazione per un flusso asincrono
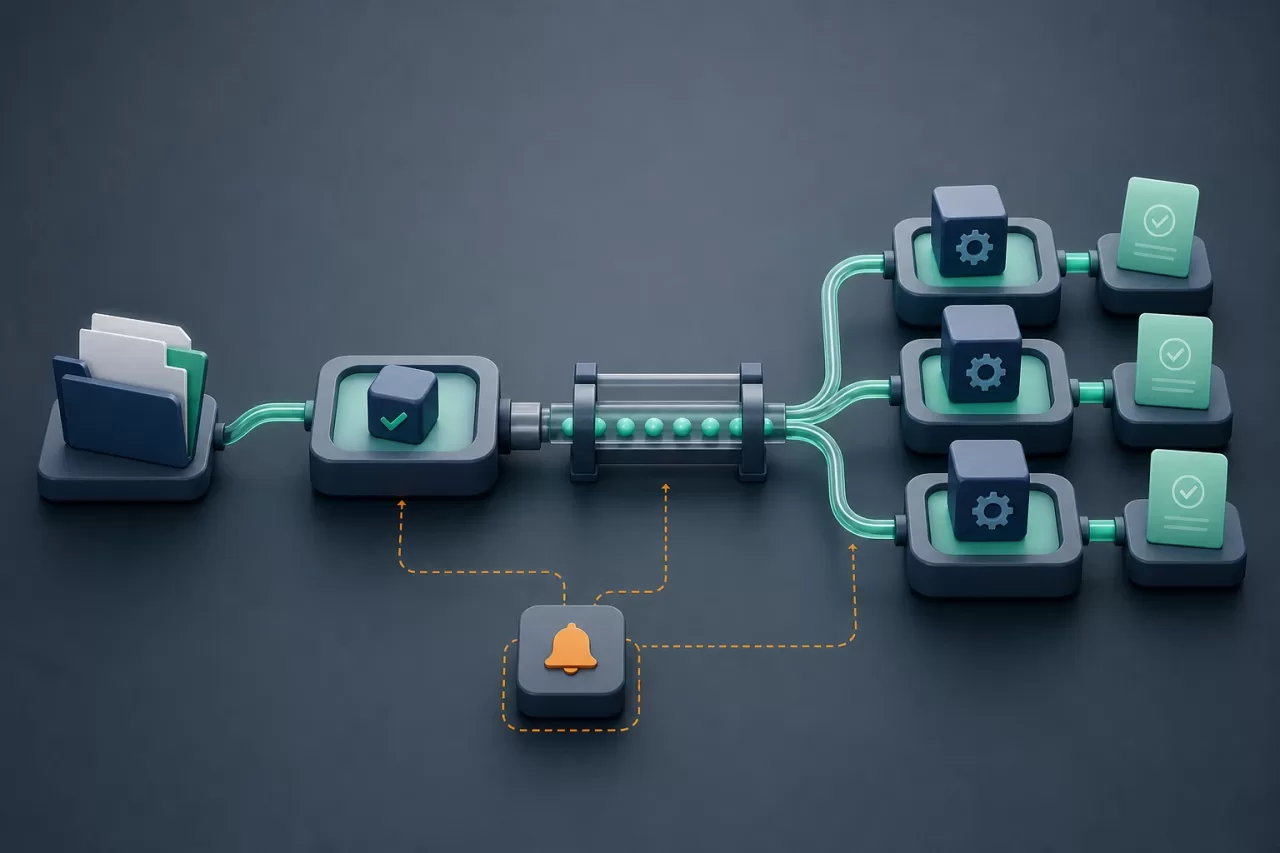
Immagina un flusso di ricezione, validazione ed elaborazione successiva di file. La richiesta PHP conferma la ricezione dopo aver salvato i metadati e pubblicato un job. I consumer convalidano il contenuto e generano un risultato. Gli alert non dovrebbero limitarsi a rilevare che la coda contiene messaggi.
- Alert di disponibilità se la ricezione fallisce in modo sostenuto in una proporzione rilevante delle richieste.
- Alert di ritardo se l'età del job in attesa supera il tempo accettabile per consegnare il risultato.
- Alert di qualità se aumentano gli errori di validazione per una causa interna, distinguendoli dai file non validi inviati dagli utenti.
- Alert di dipendenza se lo storage o un'API richiesta risponde con errori sostenuti e non esiste un percorso di recupero automatico efficace.
Per pubblicare una nuova regola, verifica infine: flusso e responsabile definiti, impatto espresso in termini operativi, baseline disponibile, soglia con finestra e persistenza, gravità giustificata, deduplicazione configurata, contesto allegato, primo passo sicuro documentato e revisione prevista. Questo filtro trasforma gli alert azionabili per applicazioni PHP in un sistema decisionale, non in un'altra fonte di interruzioni.