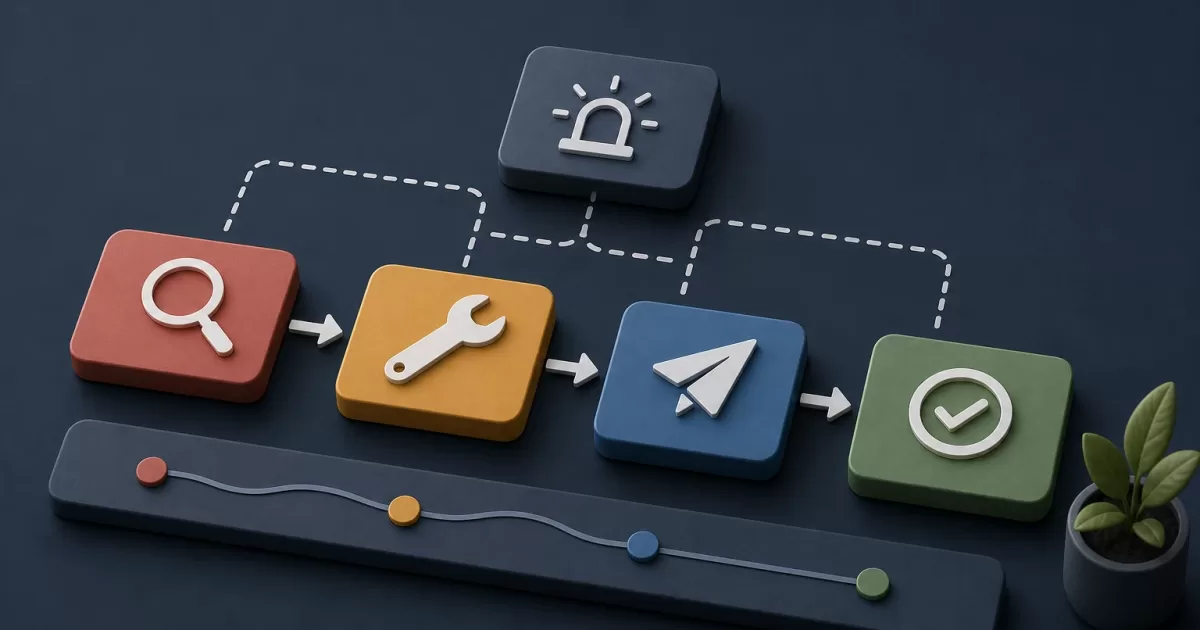
Une application peut avoir des dizaines de métriques techniques dans le rouge tout en continuant à fournir le service principal. L’inverse peut également se produire : le CPU, la mémoire et la connectivité semblent normaux, mais les utilisateurs ne peuvent pas terminer une opération critique. L’objectif des alertes exploitables pour les applications PHP n’est pas de détecter chaque anomalie, mais d’avertir lorsqu’une personne doit prendre une décision concrète afin de limiter une conséquence opérationnelle.
Avant même d’ouvrir un tableau de bord, une alerte utile répond à quatre questions : quelle capacité est affectée, qui est touché, depuis quand et quelle action initiale est sûre. Si elle ne permet pas de formuler une hypothèse ou de décider d’une intervention, il s’agit probablement de télémétrie de diagnostic, et non d’une alerte d’astreinte.
Distinguer signaux, symptômes et incidents
Un signal est une observation isolée : augmentation de l’utilisation des connexions, redémarrages des processus PHP-FPM, croissance d’une file ou réponse lente d’une API. Un symptôme exprime une dégradation observable du service : davantage d’erreurs lors de la confirmation de commandes, des tâches critiques qui ne se terminent pas dans le délai imparti ou une augmentation soutenue de la latence d’une route pertinente. Un incident est une situation qui exige coordination et réponse en raison de son impact réel ou prévisible.
Cette distinction évite de transformer chaque métrique d’infrastructure en interruption. Par exemple, une saturation transitoire du CPU peut être utile pour étudier la capacité. Elle doit devenir une alerte si elle coïncide avec des requêtes en échec ou une latence qui empêche d’utiliser une fonctionnalité prioritaire. De même, un nombre élevé d’exceptions PHP mérite de l’attention lorsqu’il se concentre sur une opération métier ou affecte une proportion significative de requêtes, et non simplement parce qu’il existe dans les journaux.
- Signaux de diagnostic : consommation de disque, nombre de processus, taux de requêtes servies par le cache, nouvelles tentatives individuelles ou traces d’exception.
- Symptômes alertables : indisponibilité, taux soutenu d’échecs dans un flux critique, retard de traitement ou épuisement imminent d’une ressource avec un effet vérifiable.
- Indicateurs d’incident : étendue des utilisateurs touchés, perte ou duplication possible de données, non-respect d’un délai opérationnel et absence d’alternative manuelle raisonnable.
Construire une cartographie minimale du service
Avant de fixer des seuils, dessinez le parcours des flux pertinents. Il n’est pas nécessaire d’inventorier toute la plateforme : il suffit de représenter les parcours qui apportent de la valeur ou génèrent un risque. Dans une application PHP courante figurent la requête web, l’authentification, la logique de domaine, la base de données, le cache, la publication dans une file, les consommateurs asynchrones et les API tierces.
Pour chaque segment, documentez quelle entrée il reçoit, quel résultat observable il doit produire, de quelle dépendance il a besoin et comment il se comporte en cas d’échec. Une requête peut répondre correctement après avoir mis une tâche en file, même si l’action finale n’est pas encore terminée. C’est pourquoi surveiller uniquement le code HTTP de la couche web laisse l’équipe aveugle aux retards ou aux erreurs du traitement asynchrone.
Prioriser selon les conséquences, et non les composants
Classez chaque flux selon sa conséquence s’il s’arrête : perte de revenus, non-respect opérationnel, exposition de données, blocage du support ou simple dégradation esthétique. Identifiez ensuite une mesure qui prouve cette conséquence. Pour une inscription d’utilisateur, cela peut être la création confirmée du compte ; pour une importation, l’ancienneté de l’élément en attente le plus ancien ; pour une intégration de facturation, le pourcentage d’opérations qui se termine dans un état récupérable ou définitif.
Il convient de maintenir des vérifications synthétiques depuis l’extérieur du processus PHP pour les parcours essentiels. Une vérification interne peut indiquer que le processus est actif, mais non que l’équilibrage de charge, les identifiants, le stockage de session et le parcours métier fonctionnent ensemble.
Les quatre familles d’alertes qui permettent généralement de décider
La disponibilité perçue mesure s’il est possible de terminer une opération représentative. Elle peut combiner une vérification synthétique avec le pourcentage de réponses correctes des routes critiques. Elle est plus précieuse qu’une alerte sur un processus isolé, même si les deux données peuvent coexister dans le diagnostic.
Les erreurs métier capturent des résultats incorrects qu’un code HTTP ne révèle pas : validations qui échouent de façon inattendue, paiements refusés à la suite d’un changement interne, documents non générés ou transitions d’état impossibles. Elles doivent utiliser des événements de domaine avec des identifiants qui permettent d’enquêter sans inclure d’informations personnelles inutiles.
La latence doit être mesurée par route et par percentiles, et non uniquement au moyen de moyennes. Une moyenne acceptable peut masquer une minorité de requêtes excessivement lentes. Alertez lorsque la latence se maintient et affecte une opération pertinente ; un pic bref peut exiger une observation, mais pas réveiller une personne.
Le retard de traitement mesure le temps écoulé entre l’acceptation d’une tâche et sa finalisation. Il est particulièrement important dans les files, car le nombre total de messages n’implique pas toujours une urgence : une accumulation importante peut être normale si les consommateurs la résorbent dans le délai requis.
Définir les seuils à partir de la ligne de référence
Ne copiez pas une valeur générique de CPU, de latence ou de taille de file. Établissez une ligne de référence par tranche horaire et par type de charge, y compris les pics prévisibles. Définissez ensuite le niveau en fonction de l’impact : combien de temps un flux peut prendre avant de ne plus respecter une attente utilisateur, une fenêtre opérationnelle ou une obligation interne.
Une règle solide combine quatre éléments : une fenêtre d’évaluation, une persistance minimale, une ampleur et une étendue. Par exemple, il ne suffit pas de détecter une hausse des erreurs ; établissez que cette hausse persiste pendant plusieurs fenêtres et représente une fraction significative des opérations du flux. Cela réduit les notifications dues à des déploiements transitoires, à des nouvelles tentatives réussies ou à un trafic anormal isolé.
Distinguez le déploiement, qui installe une version, de la release, qui active un changement de comportement pour les utilisateurs. Les deux constituent un contexte pertinent, mais ils ne sont pas équivalents. Une alerte après un déploiement peut orienter un retour arrière ou une investigation technique ; une alerte après une activation progressive peut exiger d’arrêter l’exposition du changement avant de revenir en arrière sur le code.
Files, base de données et intégrations externes
Files : surveiller l’âge et la capacité effective
Pour chaque file critique, mesurez l’ancienneté de la tâche en attente la plus ancienne, le taux d’entrée, le taux de finalisation, les échecs définitifs et les nouvelles tentatives. Ajoutez des signaux sur les consommateurs disponibles et la durée d’exécution. L’alerte la plus exploitable repose généralement sur l’ancienneté : elle relie directement le retard à l’engagement du flux.
La croissance de la file relève du diagnostic jusqu’à ce qu’elle dépasse la capacité de résorption ou menace un délai. Si l’ancienneté, les erreurs et le manque de consommateurs augmentent simultanément, la notification doit regrouper ces symptômes sous une possible dégradation du traitement, au lieu d’en envoyer une par métrique.
Dans la base de données, priorisez l’épuisement des connexions, les erreurs de connexion soutenues, les blocages prolongés et la latence des requêtes qui se traduit par des routes lentes ou en échec. Une requête coûteuse identifiée dans l’observabilité est un signal d’optimisation ; elle devient une alerte lorsqu’elle génère un symptôme du service. Pour les API externes, mesurez la disponibilité, la latence, les codes d’erreur, les limites de quota et les nouvelles tentatives. Distinguez les échecs récupérables des échecs définitifs et vérifiez s’il existe une file, un cache, un mode dégradé ou une procédure manuelle.
Joindre le contexte et classifier la réponse
Une notification devrait inclure le nom du service et du flux affectés, la sévérité, le début et l’évolution, l’étendue estimée, la région ou l’environnement, les métriques qui ont déclenché la règle, la version déployée ou le changement récemment activé, ainsi que l’accès aux tableaux de bord d’investigation. Incluez également des premières étapes sûres : vérifier l’état des consommateurs, valider les identifiants d’une dépendance, suspendre une activation progressive ou vérifier les erreurs par catégorie.
Évitez les instructions automatiques destructrices, comme vider une file ou redémarrer sans discernement. L’automatisation de la récupération doit avoir des limites, une journalisation, une réversibilité et une condition claire d’escalade vers une révision humaine.
- Informatif : anomalie sans impact actuel qui doit être observée pendant les heures ouvrées.
- Intervention planifiée : dégradation qui menace un délai, mais dispose d’une marge et d’une alternative opérationnelle.
- Escalade immédiate : opération critique indisponible, risque sur les données, accumulation irrécupérable ou impact croissant sans atténuation connue.
Éviter la fatigue et réviser chaque règle
Dédupliquez les événements identiques, regroupez les alertes selon leur cause probable et limitez les répétitions tant que l’incident reste ouvert. Une alerte secondaire doit enrichir l’alerte principale, et non la concurrencer. Si un fournisseur externe échoue et provoque des nouvelles tentatives, des erreurs applicatives et des retards dans la file, la notification centrale doit décrire la dépendance probable et joindre les symptômes corrélés.
Après chaque incident, vérifiez si une alerte précoce a manqué, laquelle est arrivée sans entraîner de décision et quelles preuves ont permis d’identifier la cause. Supprimez ou abaissez les règles qui ne génèrent que des confirmations routinières. Mesurez le résultat qualitativement : si la personne qui reçoit l’alerte comprend l’impact et exécute une première étape appropriée sans chercher un contexte dispersé, la règle remplit sa fonction.
Exemple de conception pour un flux asynchrone
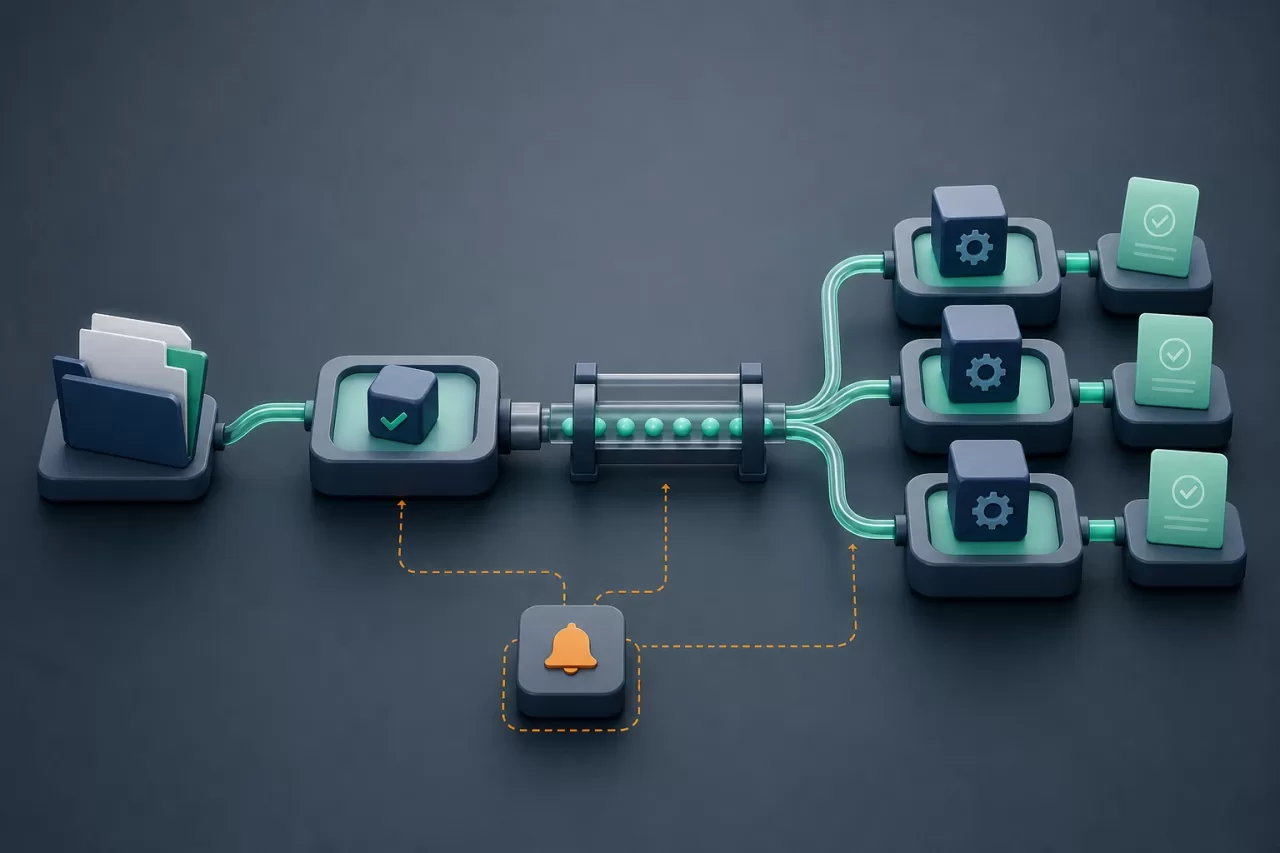
Imaginez un flux de réception, de validation et de traitement ultérieur de fichiers. La requête PHP confirme la réception après avoir enregistré les métadonnées et publié une tâche. Les consommateurs valident le contenu et génèrent un résultat. Les alertes ne devraient pas se limiter à détecter que la file contient des messages.
- Alerte de disponibilité si la réception échoue de manière soutenue pour une proportion significative de requêtes.
- Alerte de retard si l’ancienneté de la tâche en attente dépasse le délai acceptable pour livrer le résultat.
- Alerte de qualité si les échecs de validation augmentent pour une cause interne, en les distinguant des fichiers invalides envoyés par les utilisateurs.
- Alerte de dépendance si le stockage ou une API requise répond avec des échecs soutenus et qu’il n’existe pas de mécanisme de récupération automatique efficace.
Pour publier une nouvelle règle, vérifiez enfin : flux et responsable définis, impact exprimé en termes opérationnels, ligne de référence disponible, seuil avec fenêtre et persistance, sévérité justifiée, déduplication configurée, contexte joint, première étape sûre documentée et révision prévue. Ce filtre transforme les alertes exploitables pour les applications PHP en un système de décision, et non en une autre source d’interruptions.