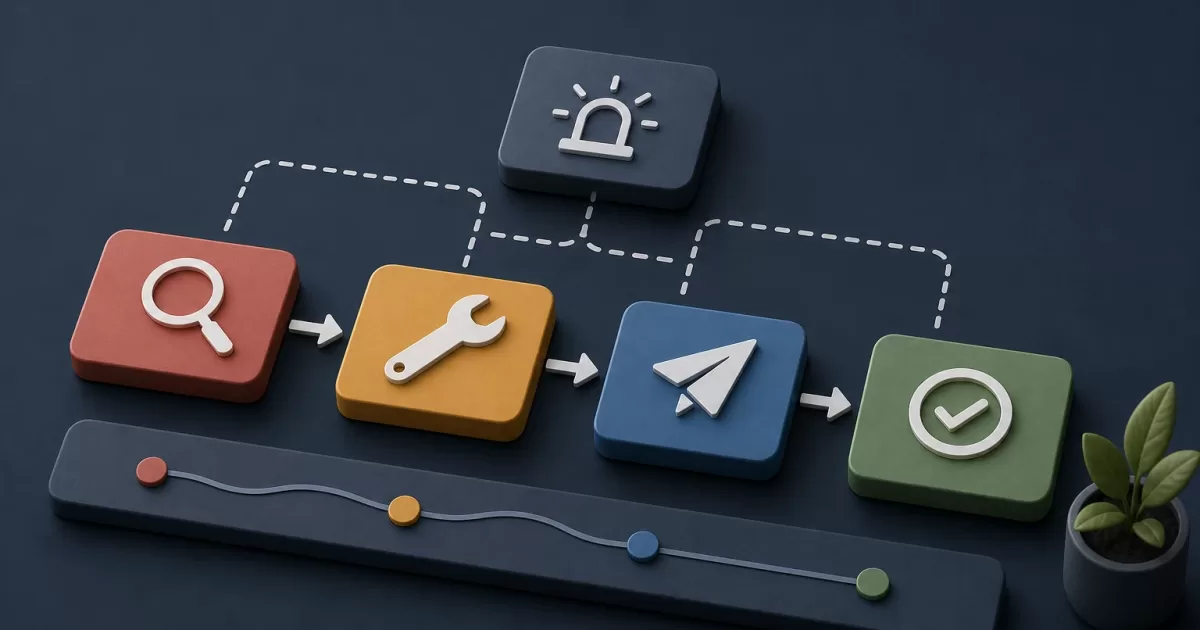
Una aplicación puede tener decenas de métricas técnicas en rojo y, aun así, seguir prestando el servicio principal. También puede ocurrir lo contrario: CPU, memoria y conectividad parecen normales, pero los usuarios no pueden completar una operación crítica. El objetivo de las alertas accionables para aplicaciones PHP no es detectar toda anomalía, sino avisar cuando una persona debe tomar una decisión concreta para limitar una consecuencia operativa.
Una alerta útil responde, antes de abrir un panel, a cuatro preguntas: qué capacidad está afectada, a quién afecta, desde cuándo y qué acción inicial es segura. Si no permite formular una hipótesis o decidir una intervención, probablemente es telemetría de diagnóstico, no una alerta de guardia.
Separar señales, síntomas e incidentes
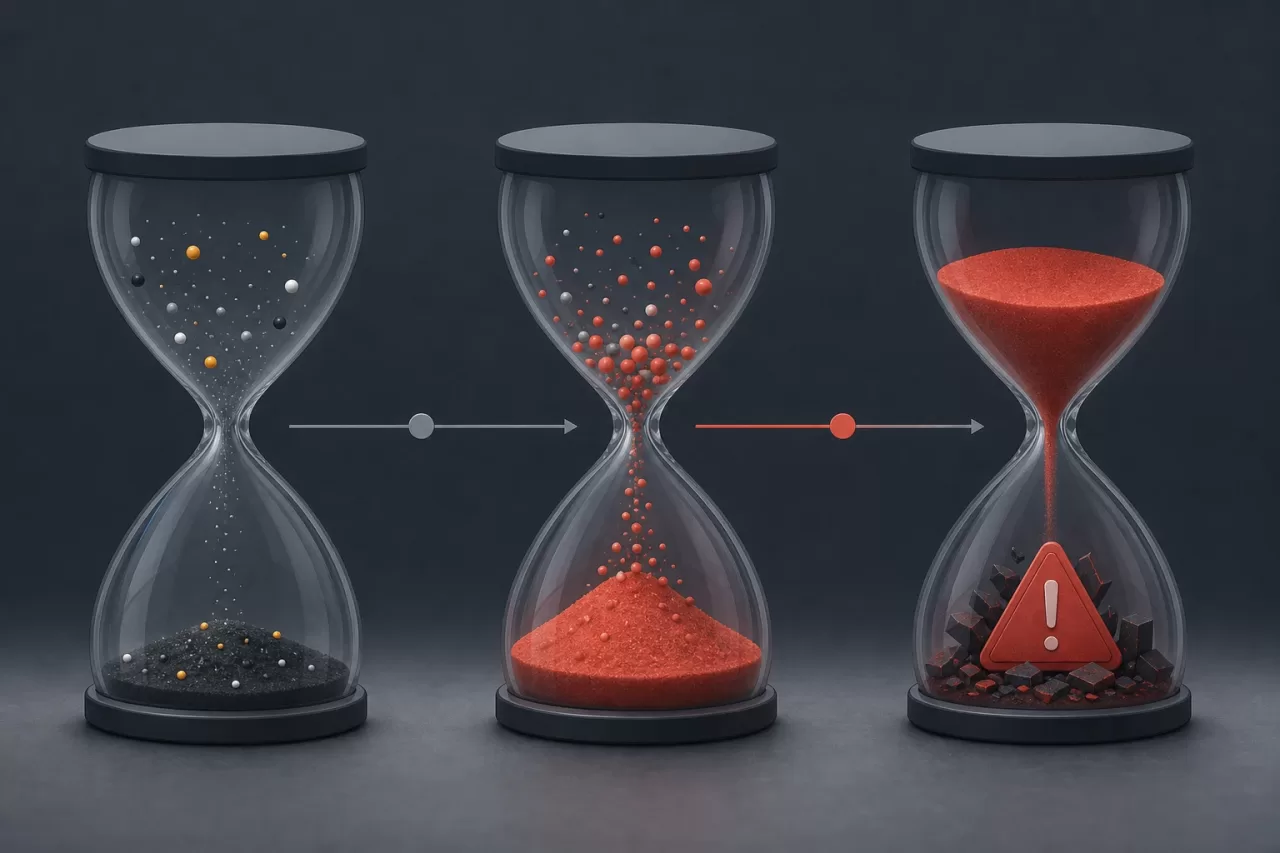
Una señal es una observación aislada: aumento de uso de conexiones, reinicios de procesos PHP-FPM, crecimiento de una cola o una respuesta lenta de una API. Un síntoma expresa degradación observable del servicio: más errores al confirmar pedidos, trabajos críticos que no terminan dentro del plazo o un incremento sostenido de la latencia de una ruta relevante. Un incidente es la situación que requiere coordinación y respuesta por su impacto real o previsible.
Esta distinción evita convertir cada métrica de infraestructura en una interrupción. Por ejemplo, una saturación transitoria de CPU puede ser útil para investigar capacidad. Debe escalar a alerta si coincide con peticiones fallidas o con una latencia que impide usar una función prioritaria. Del mismo modo, un número elevado de excepciones PHP merece atención cuando se concentra en una operación de negocio o afecta a una proporción relevante de solicitudes, no sólo porque exista en los registros.
- Señales de diagnóstico: consumo de disco, número de procesos, aciertos de caché, reintentos individuales o trazas de excepción.
- Síntomas alertables: indisponibilidad, tasa sostenida de fallos en un flujo crítico, retraso de procesamiento o agotamiento próximo de un recurso con efecto verificable.
- Indicadores de incidente: alcance de usuarios, pérdida o duplicación posible de datos, incumplimiento de un plazo operativo y ausencia de una alternativa manual razonable.
Construir un mapa mínimo del servicio
Antes de fijar umbrales, dibuja el recorrido de los flujos relevantes. No hace falta inventariar toda la plataforma: basta con representar las rutas que entregan valor o generan riesgo. En una aplicación PHP habitual aparecen la petición web, autenticación, lógica de dominio, base de datos, caché, publicación en cola, consumidores asíncronos y APIs de terceros.
Para cada tramo, documenta qué entrada recibe, qué resultado observable debe producir, qué dependencia necesita y cómo se comporta ante un fallo. Una petición puede responder correctamente tras encolar un trabajo, aunque la acción final aún no se haya completado. Por eso, vigilar sólo el código HTTP de la capa web deja ciego al equipo ante retrasos o errores del procesamiento asíncrono.
Priorizar por consecuencias, no por componentes
Clasifica cada flujo según su consecuencia si se detiene: pérdida de ingresos, incumplimiento operativo, exposición de datos, bloqueo de soporte o simple degradación estética. Después identifica una medición que pruebe la consecuencia. Para un alta de usuario puede ser la creación confirmada de la cuenta; para una importación, la antigüedad del elemento más antiguo pendiente; para una integración de facturación, el porcentaje de operaciones que termina en un estado recuperable o definitivo.
Conviene mantener comprobaciones sintéticas desde fuera del proceso PHP para los recorridos esenciales. Una comprobación interna puede indicar que el proceso está vivo, pero no que el balanceo, las credenciales, el almacenamiento de sesión y la ruta de negocio funcionen en conjunto.
Las cuatro familias de alertas que suelen aportar decisión
La disponibilidad percibida mide si se puede completar una operación representativa. Puede combinar una comprobación sintética con el porcentaje de respuestas correctas de rutas críticas. Es más valiosa que alertar por un proceso aislado, aunque ambos datos puedan convivir en el diagnóstico.
Los errores de negocio capturan resultados incorrectos que un código HTTP no revela: validaciones que fallan inesperadamente, pagos rechazados por un cambio interno, documentos no generados o transiciones de estado imposibles. Deben usar eventos de dominio con identificadores que permitan investigar sin incluir información personal innecesaria.
La latencia se debe medir por ruta y por percentiles, no sólo mediante promedios. Un promedio aceptable puede ocultar una minoría de solicitudes excesivamente lentas. Alerta cuando la latencia se sostenga y afecte una operación relevante; una punta breve puede requerir observación, no despertar a una persona.
El retraso de procesamiento mide el tiempo desde que se acepta un trabajo hasta que finaliza. Es especialmente importante en colas porque el número total de mensajes no siempre implica urgencia: una acumulación grande puede ser normal si los consumidores la drenan dentro del plazo requerido.
Definir umbrales desde la línea base
No copies un valor genérico de CPU, latencia o tamaño de cola. Reúne una línea base por franja horaria y por tipo de carga, incluidos picos previsibles. Define después el nivel a partir del impacto: cuánto puede tardar un flujo antes de incumplir una expectativa de usuario, una ventana operativa o una obligación interna.
Una regla sólida combina cuatro elementos: una ventana de evaluación, persistencia mínima, magnitud y alcance. Por ejemplo, no basta con detectar un aumento de errores; establece que el aumento persista durante varias ventanas y represente una fracción significativa de las operaciones del flujo. Así se reducen avisos por despliegues transitorios, reintentos correctos o tráfico anómalo aislado.
Distingue el despliegue, que instala una versión, de la release, que habilita un cambio de comportamiento para usuarios. Ambos son contexto relevante, pero no equivalen. Una alerta tras un despliegue puede orientar una reversión o investigación técnica; una alerta tras una activación gradual puede requerir detener la exposición del cambio antes de revertir código.
Colas, base de datos e integraciones externas
Colas: vigilar la edad y la capacidad efectiva
Para cada cola crítica, mide la antigüedad del trabajo pendiente más antiguo, la tasa de entrada, la tasa de completado, los fallos definitivos y los reintentos. Añade señales sobre consumidores disponibles y duración de ejecución. La alerta más accionable suele basarse en la antigüedad: relaciona directamente el retraso con el compromiso del flujo.
Un crecimiento de la cola es diagnóstico hasta que supera la capacidad de drenaje o amenaza un plazo. Si aumentan simultáneamente la antigüedad, los errores y la falta de consumidores, el aviso debe agrupar esos síntomas bajo una posible degradación del procesamiento, en lugar de enviar uno por métrica.
En base de datos, prioriza agotamiento de conexiones, errores de conexión sostenidos, bloqueos prolongados y latencia de consultas que se traduzca en rutas lentas o fallidas. Una consulta costosa identificada en observabilidad es una señal para optimización; se vuelve alerta cuando genera un síntoma del servicio. Para APIs externas, mide disponibilidad, latencia, códigos de error, límites de cuota y reintentos. Separa los fallos recuperables de los definitivos y comprueba si existe cola, caché, modo degradado o procedimiento manual.
Adjuntar contexto y clasificar la respuesta
Una notificación debería incluir el nombre del servicio y flujo afectados, severidad, inicio y evolución, alcance estimado, región o entorno, métricas que dispararon la regla, versión desplegada o cambio activado recientemente y acceso a los paneles de investigación. Incluye también primeros pasos seguros: comprobar el estado de consumidores, validar credenciales de una dependencia, pausar una activación gradual o verificar errores por categoría.
Evita instrucciones automáticas destructivas, como vaciar una cola o reiniciar indiscriminadamente. La automatización de recuperación debe tener límites, registro, reversibilidad y una condición clara para escalar a revisión humana.
- Informativo: anomalía sin impacto actual que debe observarse en horario laboral.
- Intervención planificada: degradación que amenaza un plazo, pero cuenta con margen y alternativa operativa.
- Escalado inmediato: operación crítica no disponible, riesgo de datos, acumulación irrecuperable o impacto creciente sin mitigación conocida.
Evitar fatiga y revisar cada regla
Deduplica eventos idénticos, agrupa alertas por causa probable y limita la repetición mientras el incidente siga abierto. Una alerta secundaria debe enriquecer la principal, no competir con ella. Si un proveedor externo falla y provoca reintentos, errores de aplicación y retrasos en cola, la notificación central debe describir la dependencia probable y adjuntar los síntomas correlacionados.
Tras cada incidente, revisa si faltó una alerta temprana, cuál llegó sin producir una decisión y qué evidencia permitió identificar la causa. Retira o rebaja reglas que sólo generan confirmaciones rutinarias. Mide el resultado cualitativamente: si la persona receptora entiende el impacto y ejecuta un primer paso apropiado sin buscar contexto disperso, la regla está cumpliendo su función.
Ejemplo de diseño para un flujo asíncrono
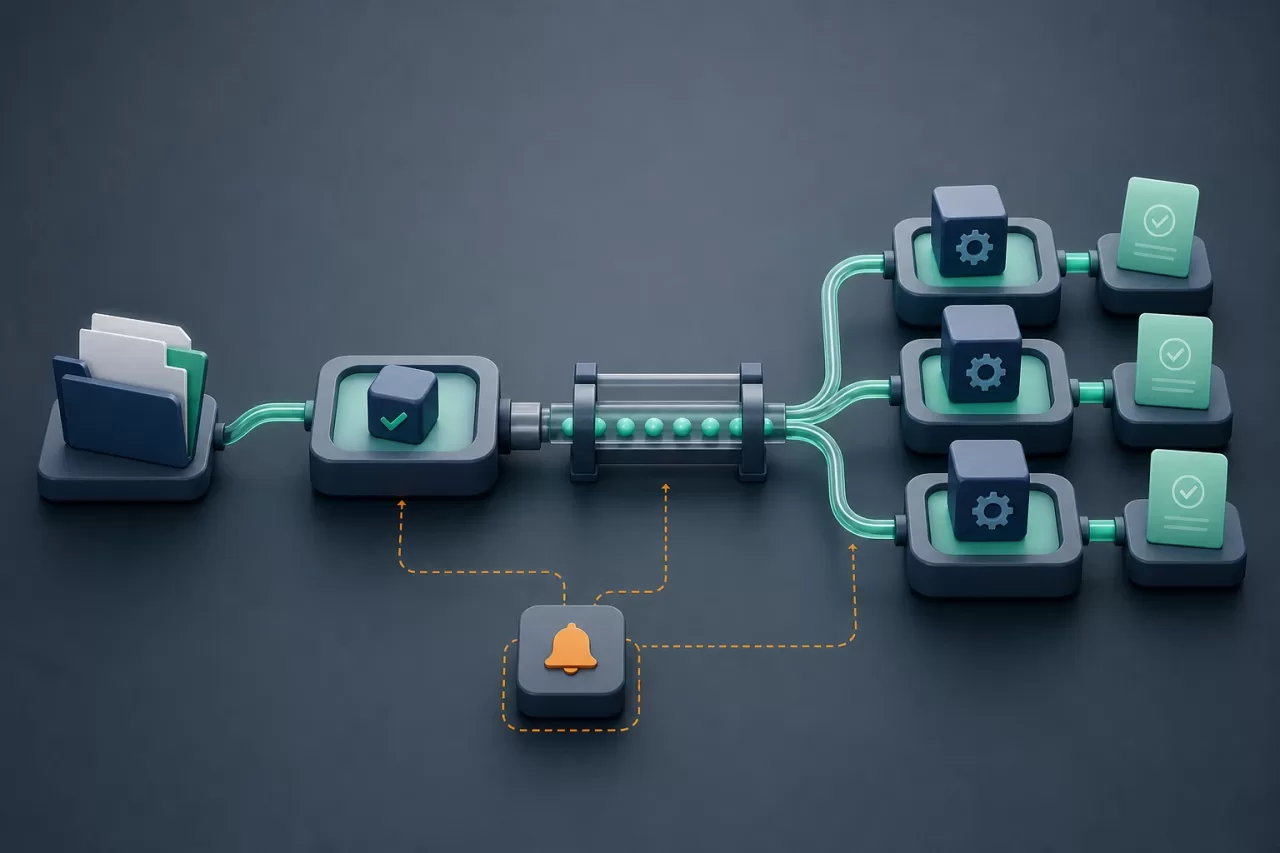
Imagina un flujo de recepción, validación y procesamiento posterior de archivos. La petición PHP confirma recepción después de guardar metadatos y publicar un trabajo. Los consumidores validan el contenido y generan un resultado. Las alertas no deberían limitarse a detectar que la cola contiene mensajes.
- Alerta de disponibilidad si la recepción falla de forma sostenida en una proporción relevante de solicitudes.
- Alerta de retraso si la antigüedad del trabajo pendiente rebasa el plazo aceptable para entregar el resultado.
- Alerta de calidad si aumentan los fallos de validación por una causa interna, diferenciándolos de archivos inválidos enviados por usuarios.
- Alerta de dependencia si el almacenamiento o una API requerida responde con fallos sostenidos y no existe una ruta de recuperación automática efectiva.
Para publicar una nueva regla, verifica finalmente: flujo y propietario definidos, impacto expresado en términos operativos, línea base disponible, umbral con ventana y persistencia, severidad justificada, deduplicación configurada, contexto adjunto, primer paso seguro documentado y revisión prevista. Este filtro convierte las alertas accionables para aplicaciones PHP en un sistema de decisión, no en otra fuente de interrupciones.