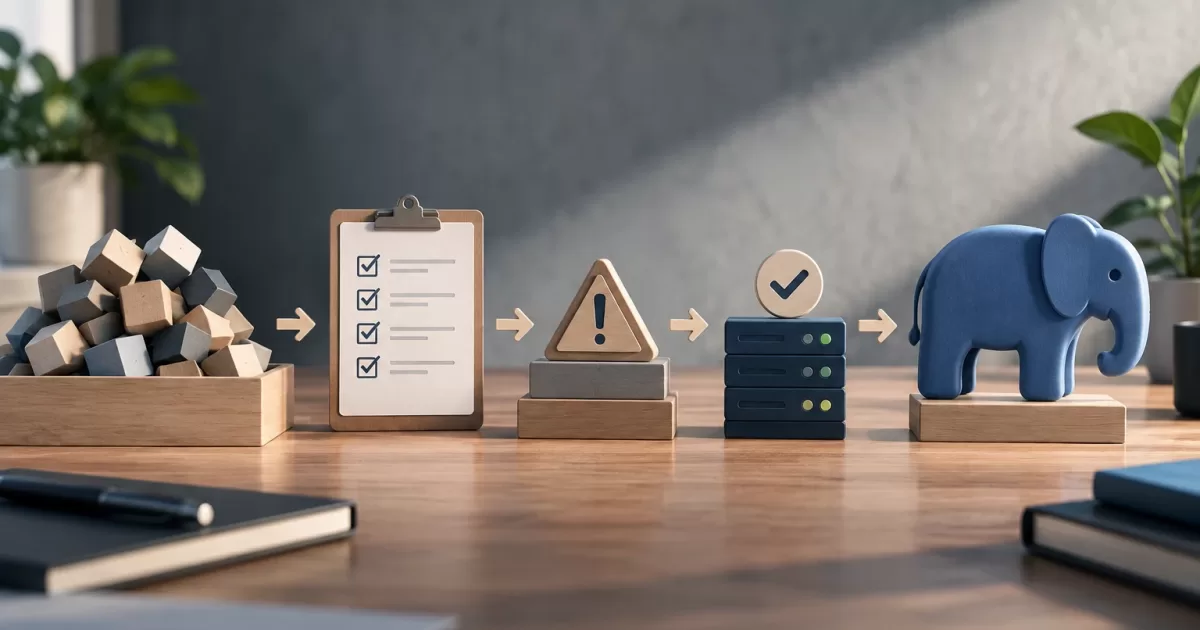
Duży import nie powinien zależeć od tego, czy użytkownik utrzymuje otwarte żądanie HTTP, ani pozostawiać go bez informacji, czy system nadal pracuje. Dobrze zaprojektowane API przekształca ten proces w identyfikowalną i obserwowalną operację: odbiera plik, weryfikuje jego strukturę, przetwarza dane i przekazuje wynik, w tym błędy wymagające poprawienia.
Śledzenie postępu importu w PHP jest częścią kontraktu API, a nie technologią kolejkowania zadań. Warto rozdzielić trzy powiązane kwestie: jaki status sprawdza użytkownik, jak zadanie jest wykonywane w tle oraz jak odzyskać zadanie, które zakończyło się niepowodzeniem.
Dlaczego nie przetwarzać całego importu w jednym żądaniu HTTP
Żądanie synchroniczne każe klientowi czekać. Przy rozbudowanym imporcie przetwarzanie może przekroczyć limity serwera WWW, proxy lub samego klienta. Jeśli połączenie zostanie przerwane, może też nie być wiadomo, czy niektóre rekordy zostały zmodyfikowane.
Alternatywą jest przyjęcie żądania, zapisanie pliku w miejscu dostępnym dla procesora, zarejestrowanie operacji i zwrócenie identyfikatora. Zadanie jest wykonywane później, poza początkowym żądaniem. Kolejka może koordynować jego wykonanie, ale nie zastępuje utrwalonego statusu, który API musi udostępniać.
Odpowiedź potwierdzająca przyjęcie żądania oznacza, że żądanie zostało odebrane, a nie że zaimportowano wszystkie dane. Dlatego powinna zawierać identyfikator, który można sprawdzić, oraz początkowy status. Weryfikacja rozmiaru i formatu może odrzucić nieodpowiednie pliki, ale nie gwarantuje poprawności każdego wiersza.
Definiowanie statusów, przejść i wyników
Ustal ograniczony zestaw statusów i możliwych do zweryfikowania przejść między nimi. Przykładowy cykl może obejmować received, validating i processing, a jego statusy końcowe to między innymi completed, completed_with_errors, failed i cancelled. Nazwy mogą się różnić; ich znaczenie musi być jednoznaczne.
completed_with_errors może oznaczać, że zastosowano poprawne wiersze, a pozostałe są dostępne do poprawienia. Status failed należy zarezerwować dla sytuacji, która uniemożliwia kontynuowanie pracy lub ustalenie wiarygodnego wyniku. Nie oznaczaj operacji jako zakończonej sukcesem tylko dlatego, że proces technicznie dobiegł końca, jeśli część danych nie została zastosowana.
- Określ, które statusy są przejściowe, a które końcowe.
- Udokumentuj, kto może zainicjować każde przejście i w jakich warunkach.
- Oddziel błędy ogólne od błędów przypisanych do konkretnego wiersza.
- Uwzględnij daty utworzenia, rozpoczęcia i zakończenia, jeśli pomagają zinterpretować wynik.
- Nie ujawniaj w publicznych odpowiedziach śladów stosu, komunikatów wewnętrznych ani danych wrażliwych.
Zabezpiecz przejścia przed zduplikowanymi wykonaniami i aktualizacjami przychodzącymi w niewłaściwej kolejności. Operacja o statusie końcowym nie powinna wracać do processing z powodu spóźnionego powiadomienia. Aktualizacje warunkowane statusem lub wersją to typowe sposoby zapobiegania równoczesnemu nadpisywaniu danych.
Oddzielenie odbioru pliku od walidacji wierszy
Podczas odbioru sprawdź uprawnienia, rozmiar i typ pliku oraz wymagane metadane. Wstępna walidacja może sprawdzić wymagane kolumny i strukturę. Jeśli pliku nie da się zinterpretować, odrzuć go lub zakończ operację, zanim zastosujesz częściowe zmiany bez określonej polityki.
Walidacja poszczególnych wierszy odbywa się podczas przetwarzania. Może wykryć nieistniejące odwołania, nieprawidłowe wartości lub konflikty z aktualnymi danymi. Zdecyduj, czy poprawne wiersze zostaną zastosowane mimo błędów w innych, czy operacja ma być atomowa i wycofana w całości. Decyzja zależy od domeny i skutków ubocznych; powinna być jasna dla użytkownika.
Identyfikuj każdy wiersz w stabilny sposób, za pomocą klucza źródłowego albo — jeśli go nie ma — odwołania powiązanego z daną partią. Zapisuj kod błędu i zrozumiały komunikat. W przypadku dużych plików zwracaj błędy stronicowane lub udostępniaj je w chronionym pliku do pobrania, zamiast powtarzać je przy każdym sprawdzeniu statusu.
Projektowanie procesu poprawiania i ponownego przesyłania błędnych danych
Produkt może umożliwiać poprawienie całego pliku i przesłanie go jako nowego importu albo ponowne przesłanie wyłącznie błędnych wierszy. Pierwsze rozwiązanie łatwiej wyjaśnić, ale podczas ponownego przetwarzania pliku wymaga rozpoznania rekordów, które zostały już zastosowane. Drugie ogranicza powtarzaną pracę, ale wymaga zachowania kluczy źródłowych i powiązania każdej kolejnej próby z początkowym importem.
W przypadku częściowego ponownego przesyłania udostępnij jawną operację, która przyjmuje wyłącznie błędne wiersze lub wiersze, których zastosowania nie potwierdzono, wraz z poprawionymi danymi. Nie opieraj jej wyłącznie na numerze wiersza: użytkownik może zmienić kolejność lub strukturę pliku. Zachowaj wynik poprzedniej próby na potrzeby audytu i ponownie zweryfikuj otrzymane dane.
Zapobieganie duplikatom wymaga stabilnej tożsamości każdego rekordu. Może nią być zewnętrzny identyfikator albo wygenerowany i utrwalony klucz wiersza. Zastosuj odpowiednie ograniczenie unikalności i określ, czy powtórzenie ma aktualizować istniejący rekord, zostać odrzucone czy zignorowane. W każdym przypadku potwierdzone już wiersze nie mogą ponownie wywoływać skutków ubocznych. Operacje idempotentne oraz transakcje dla wiersza lub partii pomagają utrzymać tę gwarancję.
Udostępnianie postępu i kontrola sprawdzania statusu
Informuj o liczbie przetworzonych jednostek i ich łącznej liczbie, gdy jest już znana. Dodaj bieżący etap — na przykład walidację lub stosowanie zmian — jeśli pomaga wyjaśnić oczekiwanie. Jeśli łączna liczba nie jest jeszcze znana, przekaż informację o etapie, nie wymyślając wartości procentowej. Procent może wprowadzać w błąd, jeśli poszczególne fazy trwają bardzo różnie długo.
Nie trzeba utrwalać aktualizacji po każdym wierszu. Grupuj je z uwzględnieniem kosztu i użyteczności informacji oraz nie pozwalaj klientowi sprawdzać statusu bez ograniczeń. Interfejs może wydłużać odstępy między zapytaniami i przestać je wysyłać po otrzymaniu statusu końcowego. Można też używać powiadomień, ale po ponownym wczytaniu strony lub utracie łączności nadal musi być możliwe pobranie aktualnego statusu.
Autoryzuj każde zapytanie i sprawdzaj, czy osoba, która je wysyła, ma dostęp do konkretnej operacji. Trudny do odgadnięcia identyfikator nie zastępuje uprawnień. Zastosuj te same kontrole do błędów i plików do pobrania oraz określ, jak długo są przechowywane.
Rozróżnienie ponawiania, wznawiania i anulowania
Ponowienie oznacza ponowne wykonanie czegoś, co zakończyło się niepowodzeniem; wznowienie oznacza kontynuację od zapisanego punktu. Ponowienie może powielić wiersze lub skutki uboczne, jeśli przetwarzanie nie jest idempotentne. Zanim je udostępnisz, ustal, co zostało zatwierdzone i jak wykrywane są duplikaty.
Wznowienie wymaga zapisania wystarczających informacji, aby ustalić ostatnie zatwierdzone zadanie i uniknąć ponownego zastosowania już przetworzonych danych. Jeśli dane źródłowe uległy zmianie albo nie można zagwarantować spójnej kontynuacji, bezpieczniej jest utworzyć nowy import, zamiast twierdzić, że operacja została wznowiona.
Anulowanie również nie wycofuje automatycznie zastosowanych zmian. Określ, czy można je zaakceptować tylko przed rozpoczęciem, czy jest sprawdzane między partiami, czy też stosowane są działania kompensacyjne. Poinformuj, czy operację zatrzymano przed przetwarzaniem, czy pozostały częściowe zmiany, czy też przerwanie nie było już możliwe.
Model danych i przepływ API w PHP
Początkowy model może obejmować tabelę imports z polami id, owner_id, status, stage, total_rows, processed_rows, success_rows, error_rows, file_key, created_at, started_at, finished_at i version. W tabeli import_rows zapisuj import_id, source_key, row_number, status i attempt_count. Ograniczenie unikalności obejmujące parę pól import_id i source_key identyfikuje wiersz w ramach partii. Tabela import_errors może przechowywać klucz, kod i bezpieczny dla użytkownika komunikat.
Przykładowy przepływ REST przyjmuje plik za pomocą POST /api/imports i zwraca 202 Accepted z odpowiedzią {"id":"imp_8f2a","status":"received","status_url":"/api/imports/imp_8f2a"}. Klient odpytuje GET /api/imports/imp_8f2a; odpowiedź w trakcie przetwarzania może wyglądać tak: {"status":"processing","stage":"applying","total_rows":1200,"processed_rows":450,"success_rows":438,"error_rows":12}. Aby pobrać błędy, użyj stronicowanego endpointu, na przykład GET /api/imports/imp_8f2a/errors?limit=50&cursor=....
Jeśli dozwolone jest ponowne przesłanie wyłącznie błędnych wierszy, POST /api/imports/imp_8f2a/retry-errors może przyjmować klucze źródłowe i poprawione dane. Powinien odrzucać klucze, które są już oznaczone jako zastosowane, albo obsługiwać je zgodnie z jawną polityką idempotencji, a także zwracać identyfikator nowej próby. Endpoint nie może ukrywać faktu, że tworzona jest powiązana próba, zamiast usuwać wcześniejszą historię.
W PHP kontroler rejestruje operację i odpowiada bez przetwarzania całego pliku w ramach żądania. Poniższy fragment to pseudokod w stylu PHP 7: nie używa argumentów nazwanych, a setJsonBody() oznacza własny adapter, nie standardową metodę PHP ani metodę przenośną między frameworkami. W rzeczywistej aplikacji należy zastąpić go odpowiedzią właściwą dla używanej implementacji lub frameworka:
$import = $imports->create(
    $user->id,
    $storedFile->key,
    'received'
);

$dispatcher->dispatch(new ProcessImport($import->id));

$response->setStatusCode(202);
$response->setJsonBody(array(
    'id' => $import->id,
    'status' => 'received',
    'status_url' => '/api/imports/' . $import->id
));

return $response;
Przykład pokazuje rozdzielenie przyjęcia żądania od wykonania zadania, ale sam w sobie nie gwarantuje trwałego zarejestrowania zadania. Skoordynuj utrwalenie operacji i wysłanie zadania, aby awaria między tymi krokami nie pozostawiła importu bez przetworzenia. W zależności od infrastruktury można użyć transakcji z wzorcem outbox lub innego niezawodnego mechanizmu.
Testy i lista kontrolna
Testuj prawidłowe i nieprawidłowe przejścia, zniekształcone pliki, częściowe błędy, zduplikowane żądania i przerwania. Sprawdź, czy operacja o statusie końcowym nie publikuje późniejszych aktualizacji postępu, liczniki są spójne, a stronicowanie błędów uwzględnia uprawnienia. Uwzględnij przypadek, w którym zastosowany już wiersz pojawia się w ponownym przesłaniu: musi nadal istnieć tylko jeden rekord i nie mogą powtórzyć się żadne skutki uboczne.
- Czy użytkownik potrafi odróżnić odbiór, przetwarzanie i wynik końcowy?
- Czy określono, czy użytkownik poprawia i ponownie przesyła plik, czy przesyła ponownie tylko błędne wiersze?
- Czy stabilne klucze zapobiegają duplikowaniu już zaimportowanych rekordów?
- Czy liczniki odzwierciedlają zatwierdzoną pracę i są aktualizowane z rozsądną częstotliwością?
- Czy sprawdzanie statusu i pobieranie błędów wymagają odpowiednich uprawnień?
- Czy skutki ponawiania, wznawiania i anulowania są zdefiniowane i możliwe do zweryfikowania?
- Czy przetestowano częściowe awarie, współbieżność i zachowanie danych?
Obserwowalny import to coś więcej niż pasek postępu. Wymaga zrozumiałych statusów, wyników, które można sprawdzić, oraz polityki poprawiania, która nie stosuje ponownie potwierdzonych rekordów. Oddzielenie tego kontraktu od mechanizmu wykonania pozwala rozwijać przetwarzanie bez pozbawiania użytkownika informacji.