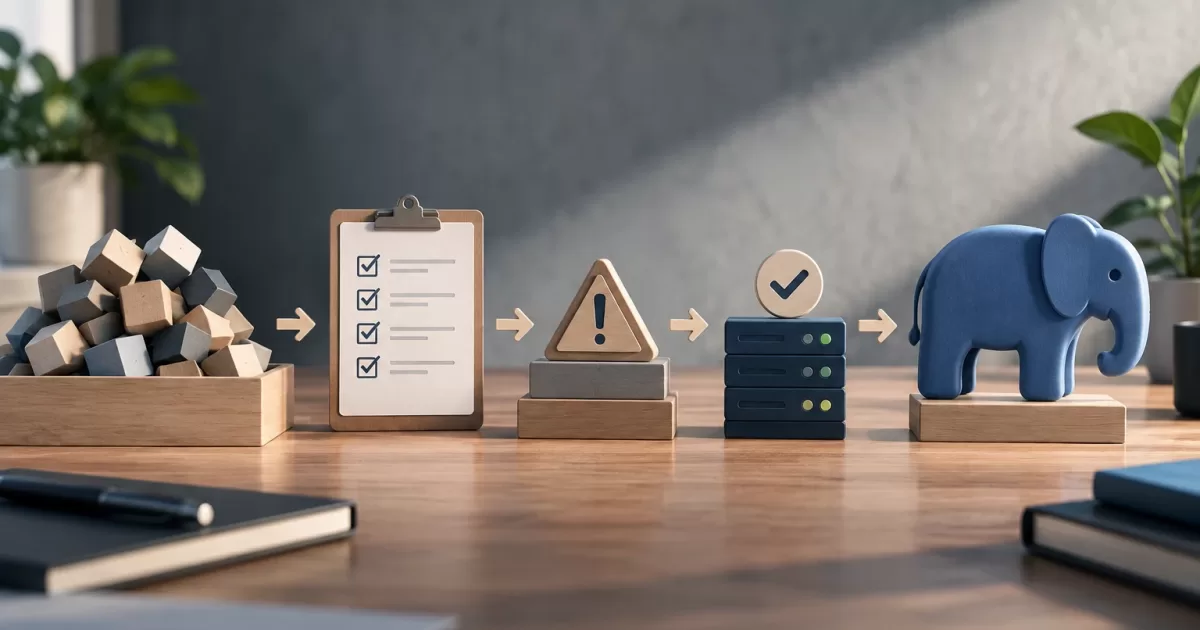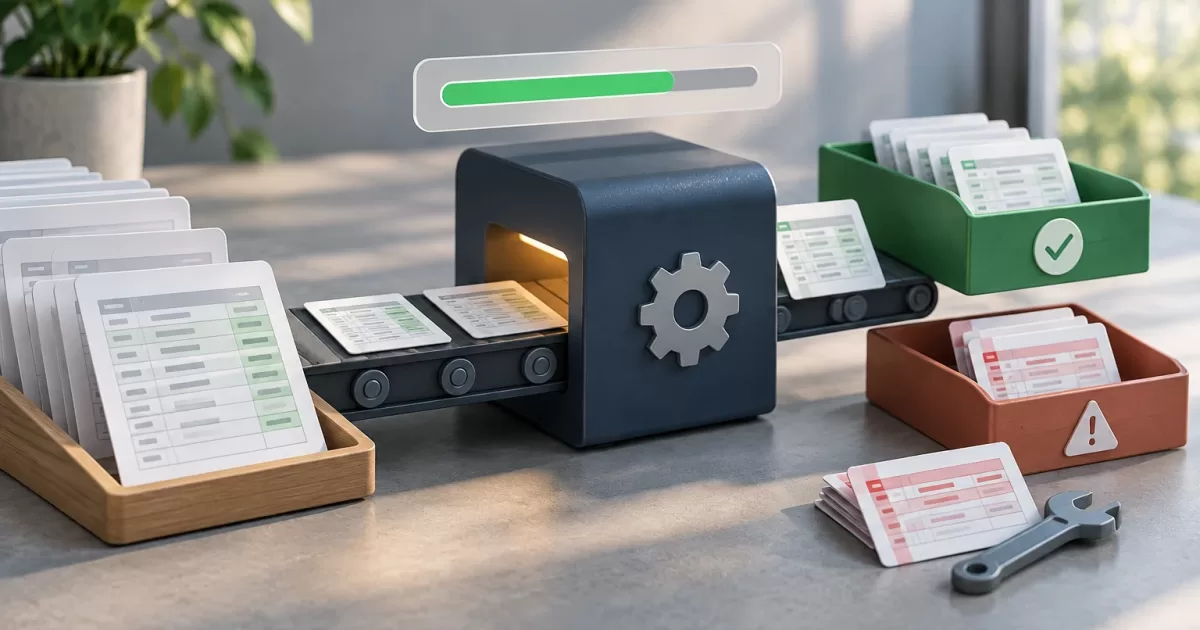
Una grossa importazione non dovrebbe dipendere dal fatto che l’utente mantenga aperta una richiesta HTTP, né lasciarlo senza sapere se il sistema sta ancora lavorando. Un’API progettata bene trasforma il processo in un’operazione identificabile e osservabile: riceve il file, ne convalida la struttura, elabora i dati e comunica il risultato, compresi gli errori che richiedono una correzione.
Il monitoraggio dell’avanzamento delle importazioni in PHP fa parte del contratto dell’API, non è una tecnologia di code. Conviene separare tre aspetti correlati: quale stato consulta l’utente, come viene eseguito il lavoro in background e come viene recuperato un task che non riesce.
Perché non elaborare l’intera importazione in una richiesta HTTP
Una richiesta sincrona lascia il client in attesa. Durante un’importazione estesa, l’elaborazione può superare i limiti del web server, di un proxy o del client stesso. Inoltre, se la connessione si interrompe, può restare il dubbio che alcuni record siano stati modificati.
Un’alternativa consiste nell’accettare la richiesta, salvare il file in una posizione accessibile al processore, registrare l’operazione e restituire un identificatore. Il lavoro viene eseguito in seguito, al di fuori della richiesta iniziale. Una coda può coordinarlo, ma non sostituisce lo stato persistente che l’API deve esporre.
La risposta di accettazione conferma che la richiesta è stata ricevuta, non che tutti i dati siano stati importati. Per questo deve includere un identificatore consultabile e uno stato iniziale. La convalida delle dimensioni e del formato può rifiutare i file non idonei, ma non garantisce che ogni riga sia valida.
Definire stati, transizioni e risultati
Concorda un insieme limitato di stati e transizioni verificabili. Un possibile ciclo include received, validating e processing, con risultati terminali come completed, completed_with_errors, failed e cancelled. I nomi possono variare; il significato deve essere inequivocabile.
completed_with_errors può indicare che le righe valide sono state applicate e che le altre sono disponibili per la correzione. Riserva failed a una situazione che impedisce di proseguire o di conoscere un risultato affidabile. Non dichiarare il successo solo perché il processo tecnico è terminato, se ci sono dati che non sono stati applicati.
- Definisci quali stati sono transitori e quali terminali.
- Documenta chi può avviare ogni transizione e a quali condizioni.
- Separa gli errori generali da quelli associati a una riga.
- Includi le date di creazione, inizio e fine quando aiutano a interpretare il risultato.
- Non esporre stack trace, messaggi interni o dati sensibili nelle risposte pubbliche.
Proteggi le transizioni da esecuzioni duplicate e aggiornamenti fuori ordine. Un’operazione terminale non deve tornare a processing a causa di una notifica tardiva. Gli aggiornamenti condizionati allo stato o alla versione sono metodi comuni per impedire sovrascritture concorrenti.
Separare la ricezione dalla convalida delle righe
Al momento della ricezione, verifica le autorizzazioni, le dimensioni, il tipo di file e i metadati richiesti. Una convalida iniziale può verificare le colonne obbligatorie e la struttura. Se il file non può essere interpretato, rifiutalo o termina l’operazione prima di applicare modifiche parziali senza una policy definita.
La convalida per riga avviene durante l’elaborazione. Può rilevare riferimenti inesistenti, valori non validi o conflitti con i dati attuali. Decidi se applicare le righe valide anche quando altre non superano la convalida, oppure se l’operazione debba essere atomica e annullata. La decisione dipende dal dominio e dagli effetti collaterali e deve essere chiara all’utente.
Identifica ogni riga in modo stabile, tramite una chiave di origine oppure, se non è disponibile, un riferimento associato al lotto. Salva un codice di errore e un messaggio comprensibile. Per i file di grandi dimensioni, restituisci gli errori in pagine o tramite un risultato scaricabile protetto, invece di ripeterli a ogni richiesta dello stato.
Progettare un flusso per correggere e reinviare gli errori
Il prodotto può consentire di correggere l’intero file e caricarlo come nuova importazione, oppure di reinviare solo le righe non riuscite. La prima opzione è più semplice da spiegare, ma quando il file viene elaborato di nuovo è necessario riconoscere i record già applicati. La seconda riduce il lavoro ripetuto, ma richiede di conservare le chiavi di origine e associare ogni nuovo tentativo all’importazione iniziale.
Per il reinvio parziale, offri un’azione esplicita che accetti solo le righe non riuscite o non confermate e i dati corretti. Non basarti solo sul numero di riga: l’utente potrebbe modificare l’ordine o la struttura del file. Conserva il risultato del tentativo precedente per l’audit e convalida di nuovo i dati ricevuti.
Per prevenire i duplicati serve un’identità stabile per ogni record. Può trattarsi di un identificatore esterno o di una chiave generata e persistita per la riga. Applica un vincolo univoco adeguato e definisci se una ripetizione deve aggiornare il record esistente, essere rifiutata o ignorata. In ogni caso, le righe già confermate non devono produrre di nuovo effetti collaterali. Le operazioni idempotenti e le transazioni per riga o per lotto aiutano a mantenere questa garanzia.
Pubblicare l’avanzamento e controllare le richieste dello stato
Indica le unità elaborate e il totale, quando è noto. Aggiungi la fase corrente, per esempio convalida o applicazione, se aiuta a spiegare l’attesa. Se il totale non è ancora noto, comunica la fase senza inventare una percentuale. Una percentuale può essere fuorviante se le varie fasi richiedono tempi molto diversi.
Non è necessario rendere persistente un aggiornamento per ogni riga. Raggruppa gli aggiornamenti in base al costo e all’utilità delle informazioni, ed evita che il client invii richieste senza limiti. L’interfaccia può distanziare le richieste e interromperle quando riceve uno stato terminale. Può anche usare notifiche, ma deve restare possibile recuperare lo stato attuale dopo aver ricaricato la pagina o perso la connettività.
Autorizza ogni richiesta e verifica che chi la invia possa accedere a quella specifica operazione. Un identificatore difficile da indovinare non sostituisce le autorizzazioni. Applica lo stesso controllo agli errori e ai file scaricabili e definisci per quanto tempo vengono conservati.
Distinguere tra nuovo tentativo, ripresa e annullamento
Riprovare significa eseguire di nuovo qualcosa che non è riuscito; riprendere significa continuare da un punto salvato. Un nuovo tentativo può elaborare di nuovo righe o effetti collaterali se l’elaborazione non è idempotente. Prima di offrirlo, determina che cosa è stato confermato e come vengono rilevati i duplicati.
Riprendere richiede di salvare informazioni sufficienti per identificare l’ultimo lavoro confermato ed evitare di applicare di nuovo ciò che è già stato elaborato. Se i dati di origine sono cambiati o non è possibile garantire una continuazione coerente, è più sicuro creare una nuova importazione anziché dichiarare che l’elaborazione riprende.
Anche l’annullamento non annulla automaticamente le modifiche applicate. Definisci se è accettato solo prima dell’avvio, se viene verificato tra un lotto e l’altro o se sono previste compensazioni. Comunica se il processo è stato fermato prima dell’elaborazione, se sono rimaste modifiche parziali o se era ormai troppo tardi per interromperlo.
Modello dei dati e flusso dell’API in PHP
Un modello iniziale può includere una tabella imports con id, owner_id, status, stage, total_rows, processed_rows, success_rows, error_rows, file_key, created_at, started_at, finished_at e version. In import_rows, salva import_id, source_key, row_number, status e attempt_count. Un vincolo univoco su import_id e source_key identifica una riga all’interno del lotto. Una tabella import_errors può salvare la chiave, il codice e un messaggio sicuro per l’utente.
Un flusso REST esemplificativo accetta il file tramite POST /api/imports e risponde con 202 Accepted e {"id":"imp_8f2a","status":"received","status_url":"/api/imports/imp_8f2a"}. Il client interroga GET /api/imports/imp_8f2a; una risposta durante l’elaborazione potrebbe essere {"status":"processing","stage":"applying","total_rows":1200,"processed_rows":450,"success_rows":438,"error_rows":12}. Per ottenere gli errori, usa un endpoint paginato come GET /api/imports/imp_8f2a/errors?limit=50&cursor=....
Se è consentito reinviare solo le righe non riuscite, POST /api/imports/imp_8f2a/retry-errors può ricevere le chiavi di origine e i dati corretti. Deve rifiutare le chiavi già registrate come applicate o gestirle con una policy idempotente esplicita e restituire l’identificatore del nuovo tentativo. L’endpoint non deve nascondere il fatto che viene creato un tentativo correlato, anziché cancellare la cronologia precedente.
In PHP, il controller registra l’operazione e risponde senza elaborare l’intero file nella richiesta. Questo frammento è pseudocodice in stile PHP 7: non usa argomenti con nome e setJsonBody() rappresenta un adapter personalizzato, non un metodo standard di PHP né portabile tra framework. In un’applicazione reale va sostituito con la risposta prevista dall’implementazione o dal framework utilizzato:
$import = $imports->create(
    $user->id,
    $storedFile->key,
    'received'
);

$dispatcher->dispatch(new ProcessImport($import->id));

$response->setStatusCode(202);
$response->setJsonBody(array(
    'id' => $import->id,
    'status' => 'received',
    'status_url' => '/api/imports/' . $import->id
));

return $response;
L’esempio mostra la separazione tra accettazione ed esecuzione, ma da solo non garantisce che il lavoro venga registrato in modo durevole. Coordina la persistenza dell’operazione e l’invio del lavoro, affinché un errore tra i due passaggi non lasci un’importazione senza elaborazione. A seconda dell’infrastruttura, si può usare una transazione con il pattern outbox o un altro meccanismo affidabile.
Test e lista di controllo
Verifica le transizioni valide e non valide, i file malformati, gli errori parziali, le richieste duplicate e le interruzioni. Controlla che un’operazione terminale non pubblichi avanzamenti successivi, che i contatori siano coerenti e che la paginazione degli errori rispetti le autorizzazioni. Includi il caso in cui una riga già applicata ricompare in un reinvio: deve continuare a esistere un solo record e non devono ripetersi effetti collaterali.
- L’utente distingue la ricezione, l’elaborazione e il risultato finale?
- È definito se corregge e ricarica il file oppure reinvia solo le righe non riuscite?
- Le chiavi stabili evitano di duplicare i record già importati?
- I contatori riflettono il lavoro confermato e vengono aggiornati con una frequenza ragionevole?
- Per consultare lo stato e scaricare gli errori sono richieste le autorizzazioni adeguate?
- Il nuovo tentativo, la ripresa e l’annullamento hanno effetti definiti e verificabili?
- Sono stati testati gli errori parziali, la concorrenza e la conservazione dei dati?
Un’importazione osservabile non è solo una barra di avanzamento. Richiede stati comprensibili, risultati consultabili e una policy di correzione che non applichi di nuovo i record confermati. Separare questo contratto dal meccanismo di esecuzione permette di far evolvere l’elaborazione senza lasciare l’utente senza informazioni.