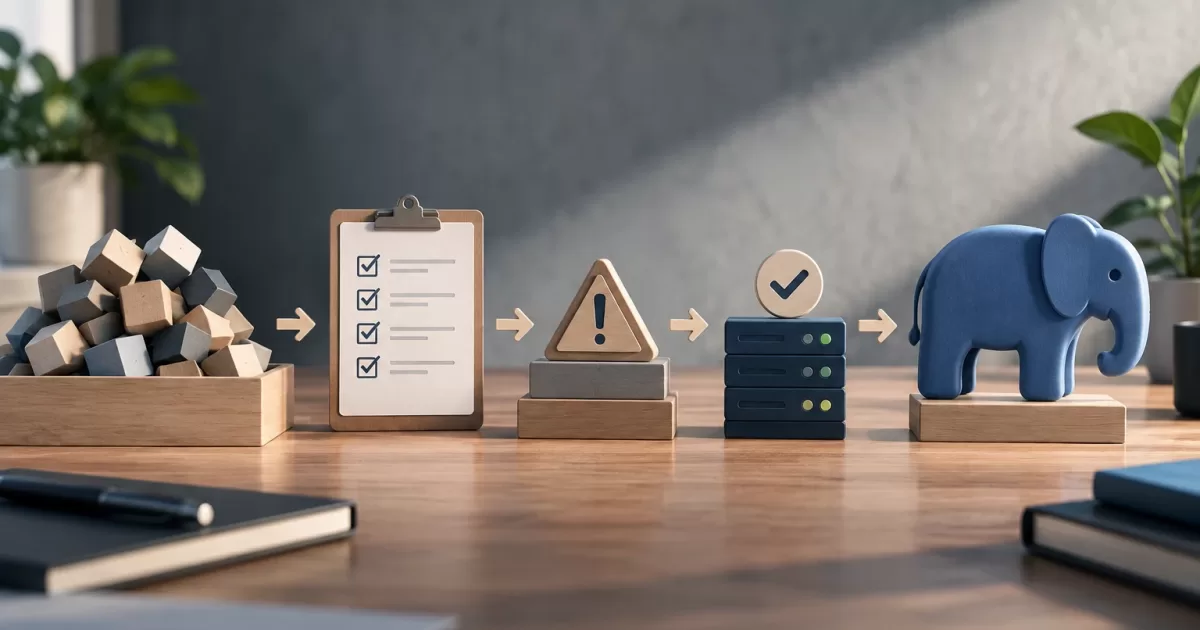
Ein umfangreicher Import sollte nicht davon abhängen, dass der Benutzer eine HTTP-Anfrage offen hält, und ihn auch nicht im Unklaren darüber lassen, ob das System noch arbeitet. Eine gut entworfene API macht den Vorgang zu einer identifizierbaren und nachvollziehbaren Operation: Sie nimmt die Datei entgegen, prüft ihre Struktur, verarbeitet die Daten und teilt das Ergebnis mit – einschließlich der Fehler, die korrigiert werden müssen.
Die Fortschrittsverfolgung von Importen in PHP ist Teil des API-Vertrags und keine Queue-Technologie. Es empfiehlt sich, drei zusammenhängende Fragen getrennt zu betrachten: Welchen Status fragt der Benutzer ab, wie wird die Arbeit im Hintergrund ausgeführt und wie wird eine fehlgeschlagene Aufgabe wiederhergestellt?
Warum nicht den gesamten Import in einer HTTP-Anfrage verarbeiten?
Bei einer synchronen Anfrage muss der Client warten. Bei einem umfangreichen Import kann die Verarbeitung die Limits des Webservers, eines Proxys oder des Clients selbst überschreiten. Wird die Verbindung unterbrochen, kann außerdem unklar bleiben, ob einige Datensätze bereits geändert wurden.
Eine Alternative besteht darin, die Anfrage anzunehmen, die Datei an einem für den Prozessor zugänglichen Ort zu speichern, den Vorgang zu registrieren und eine Kennung zurückzugeben. Die Arbeit wird anschließend außerhalb der ursprünglichen Anfrage ausgeführt. Eine Queue kann die Ausführung koordinieren, ersetzt aber nicht den persistierten Status, den die API bereitstellen muss.
Die Annahmebestätigung bestätigt, dass die Anfrage eingegangen ist, nicht, dass alle Daten importiert wurden. Sie sollte deshalb eine abfragbare Kennung und einen initialen Status enthalten. Die Prüfung von Größe und Format kann ungeeignete Dateien zurückweisen, garantiert aber nicht, dass jede Zeile gültig ist.
Status, Übergänge und Ergebnisse definieren
Lege eine begrenzte Menge an Statuswerten und überprüfbaren Übergängen fest. Ein möglicher Ablauf umfasst received, validating und processing, mit abschließenden Ergebnissen wie completed, completed_with_errors, failed und cancelled. Die Namen können variieren; ihre Bedeutung muss eindeutig sein.
completed_with_errors kann anzeigen, dass gültige Zeilen übernommen wurden und die übrigen zur Korrektur bereitstehen. Verwende failed für einen Zustand, der eine Fortsetzung oder die Ermittlung eines verlässlichen Ergebnisses verhindert. Melde nicht allein deshalb Erfolg, weil die technische Verarbeitung beendet ist, wenn Daten nicht übernommen wurden.
- Lege fest, welche Statuswerte vorübergehend und welche abschließend sind.
- Dokumentiere, wer unter welchen Bedingungen jeden Übergang auslösen darf.
- Trenne allgemeine Fehler von Fehlern, die einer Zeile zugeordnet sind.
- Gib Erstellungs-, Start- und Endzeitpunkte an, wenn sie bei der Einordnung des Ergebnisses helfen.
- Gib in öffentlichen Antworten keine Stacktraces, internen Meldungen oder vertraulichen Daten preis.
Sichere Statusübergänge gegen doppelte Ausführungen und Aktualisierungen in falscher Reihenfolge ab. Ein abgeschlossener Vorgang darf aufgrund einer verspäteten Benachrichtigung nicht wieder auf processing wechseln. Status- oder versionsbasierte Bedingungen bei Aktualisierungen sind gängige Methoden, um konkurrierende Überschreibungen zu verhindern.
Entgegennahme und zeilenweise Validierung trennen
Prüfe bei der Entgegennahme Berechtigungen, Dateigröße, Dateityp und erforderliche Metadaten. Eine anfängliche Validierung kann Pflichtspalten und Struktur überprüfen. Lässt sich die Datei nicht interpretieren, lehne sie ab oder beende den Vorgang, bevor Teiländerungen ohne festgelegte Richtlinie angewendet werden.
Die zeilenweise Validierung findet während der Verarbeitung statt. Dabei können nicht vorhandene Referenzen, ungültige Werte oder Konflikte mit den aktuellen Daten entdeckt werden. Entscheide, ob gültige Zeilen auch dann übernommen werden, wenn andere fehlschlagen, oder ob der Vorgang atomar sein und zurückgerollt werden muss. Diese Entscheidung hängt von der Domäne und den Seiteneffekten ab und muss für den Benutzer klar sein.
Identifiziere jede Zeile stabil über einen Quellschlüssel oder, falls keiner vorhanden ist, über eine Referenz, die an den Importlauf gebunden ist. Speichere einen Fehlercode und eine verständliche Meldung. Gib bei großen Dateien die Fehler paginiert oder über ein geschütztes herunterladbares Ergebnis zurück, statt sie bei jeder Statusabfrage erneut zu übertragen.
Einen Ablauf zur Korrektur und erneuten Übermittlung von Fehlern entwerfen
Das Produkt kann ermöglichen, die gesamte Datei zu korrigieren und als neuen Import hochzuladen, oder nur die fehlgeschlagenen Zeilen erneut zu übermitteln. Die erste Option ist leichter zu erklären, setzt aber voraus, dass bereits übernommene Datensätze bei einer erneuten Verarbeitung der Datei erkannt werden. Die zweite reduziert wiederholte Arbeit, erfordert jedoch, dass Quellschlüssel erhalten bleiben und jeder neue Versuch dem ursprünglichen Import zugeordnet wird.
Für die teilweise erneute Übermittlung biete eine explizite Aktion an, die nur fehlgeschlagene oder nicht bestätigte Zeilen sowie die korrigierten Daten akzeptiert. Verlasse dich nicht allein auf die Zeilennummer: Der Benutzer könnte die Reihenfolge oder Struktur der Datei ändern. Bewahre das Ergebnis des vorherigen Versuchs zu Prüfzwecken auf und validiere die empfangenen Daten erneut.
Zur Vermeidung von Duplikaten ist eine stabile Identität pro Datensatz erforderlich. Das kann eine externe Kennung oder ein für die Zeile generierter und persistierter Schlüssel sein. Lege eine geeignete eindeutige Einschränkung fest und entscheide, ob eine Wiederholung den vorhandenen Datensatz aktualisieren, abgelehnt oder ignoriert werden soll. In jedem Fall dürfen bereits bestätigte Zeilen keine Seiteneffekte erneut auslösen. Idempotente Operationen und Transaktionen pro Zeile oder Importlauf helfen, diese Garantie einzuhalten.
Fortschritt veröffentlichen und Statusabfragen steuern
Gib die Zahl der verarbeiteten Einheiten und die Gesamtzahl an, sofern diese bekannt ist. Nenne die aktuelle Phase – zum Beispiel Validierung oder Übernahme –, wenn das Warten dadurch besser verständlich wird. Ist die Gesamtzahl noch nicht bekannt, kommuniziere die Phase, ohne einen Prozentsatz zu erfinden. Ein Prozentwert kann irreführend sein, wenn die einzelnen Phasen sehr unterschiedlich lange dauern.
Es ist nicht erforderlich, nach jeder Zeile eine Aktualisierung zu persistieren. Fasse Aktualisierungen entsprechend den Kosten und dem Nutzen der Informationen zusammen und vermeide unbegrenzte Abfragen durch den Client. Die Benutzeroberfläche kann die Abfragen zeitlich staffeln und nach Erhalt eines abschließenden Status einstellen. Benachrichtigungen sind ebenfalls möglich; nach einem Neuladen der Seite oder einem Verbindungsverlust muss der aktuelle Status jedoch weiterhin abrufbar sein.
Autorisiere jede Abfrage und prüfe, ob die anfragende Person auf genau diesen Vorgang zugreifen darf. Eine schwer zu erratende Kennung ersetzt keine Berechtigungen. Wende dieselbe Prüfung auf Fehler und herunterladbare Dateien an und lege fest, wie lange diese aufbewahrt werden.
Wiederholen, fortsetzen und abbrechen unterscheiden
Wiederholen bedeutet, etwas Fehlgeschlagenes erneut auszuführen; fortsetzen bedeutet, an einem gespeicherten Punkt weiterzuarbeiten. Bei einem erneuten Versuch können Zeilen oder Seiteneffekte doppelt ausgeführt werden, wenn die Verarbeitung nicht idempotent ist. Kläre vor dem Angebot dieser Möglichkeit, was bestätigt wurde und wie Duplikate erkannt werden.
Zum Fortsetzen müssen genügend Informationen gespeichert werden, um die zuletzt bestätigte Arbeit zu identifizieren und eine erneute Übernahme bereits verarbeiteter Daten zu verhindern. Wenn sich die Quelldaten geändert haben oder keine konsistente Fortsetzung gewährleistet werden kann, ist ein neuer Import sicherer, als zu behaupten, der Vorgang werde fortgesetzt.
Auch ein Abbruch macht bereits angewendete Änderungen nicht automatisch rückgängig. Lege fest, ob der Abbruch nur vor Beginn möglich ist, zwischen Importchargen geprüft wird oder Kompensationsmaßnahmen erfordert. Teile mit, ob der Vorgang vor der Verarbeitung angehalten wurde, ob Teiländerungen bestehen blieben oder ob es bereits zu spät für einen Abbruch war.
Datenmodell und API-Ablauf in PHP
Ein erstes Modell kann eine Tabelle imports mit den Feldern id, owner_id, status, stage, total_rows, processed_rows, success_rows, error_rows, file_key, created_at, started_at, finished_at und version umfassen. Speichere in import_rows die Felder import_id, source_key, row_number, status und attempt_count. Eine eindeutige Einschränkung auf import_id und source_key identifiziert eine Zeile innerhalb des Importlaufs. Eine Tabelle import_errors kann den Schlüssel, den Code und eine sichere, für den Benutzer bestimmte Meldung speichern.
Ein beispielhafter REST-Ablauf nimmt die Datei über POST /api/imports entgegen und antwortet mit 202 Accepted und {"id":"imp_8f2a","status":"received","status_url":"/api/imports/imp_8f2a"}. Der Client fragt GET /api/imports/imp_8f2a ab; eine Antwort während der Verarbeitung könnte {"status":"processing","stage":"applying","total_rows":1200,"processed_rows":450,"success_rows":438,"error_rows":12} lauten. Um Fehler abzurufen, verwende einen paginierten Endpunkt wie GET /api/imports/imp_8f2a/errors?limit=50&cursor=....
Wenn nur fehlgeschlagene Zeilen erneut übermittelt werden dürfen, kann POST /api/imports/imp_8f2a/retry-errors Quellschlüssel und korrigierte Daten entgegennehmen. Der Endpunkt muss Schlüssel ablehnen, die bereits als übernommen verzeichnet sind, oder sie nach einer ausdrücklich festgelegten idempotenten Richtlinie behandeln und die Kennung des neuen Versuchs zurückgeben. Er darf nicht verschleiern, dass ein zugehöriger neuer Versuch erstellt wird, statt den bisherigen Verlauf zu löschen.
In PHP registriert der Controller den Vorgang und antwortet, ohne die gesamte Datei innerhalb der Anfrage zu verarbeiten. Dieses Snippet ist Pseudocode im Stil von PHP 7: Es verwendet keine benannten Argumente, und setJsonBody() steht für einen eigenen Adapter, nicht für eine Standardmethode von PHP oder eine frameworkübergreifend portable Methode. In einer echten Anwendung muss die Methode durch die Antwort des verwendeten Frameworks oder der jeweiligen Implementierung ersetzt werden:
$import = $imports->create(
    $user->id,
    $storedFile->key,
    'received'
);

$dispatcher->dispatch(new ProcessImport($import->id));

$response->setStatusCode(202);
$response->setJsonBody(array(
    'id' => $import->id,
    'status' => 'received',
    'status_url' => '/api/imports/' . $import->id
));

return $response;
Das Beispiel zeigt die Trennung zwischen Annahme und Ausführung, garantiert aber für sich allein nicht, dass die Arbeit dauerhaft registriert wird. Koordiniere die Persistierung des Vorgangs und das Einreihen der Arbeit so, dass ein Fehler zwischen den beiden Schritten keinen unverarbeiteten Import zurücklässt. Je nach Infrastruktur kann eine Transaktion mit dem Outbox-Muster oder ein anderer zuverlässiger Mechanismus verwendet werden.
Tests und Checkliste
Teste gültige und ungültige Übergänge, fehlerhafte Dateien, Teilfehler, doppelte Anfragen und Unterbrechungen. Prüfe, dass ein abgeschlossener Vorgang keine späteren Fortschrittsmeldungen veröffentlicht, die Zähler konsistent sind und die Fehlerpagination Berechtigungen berücksichtigt. Beziehe auch den Fall ein, in dem eine bereits übernommene Zeile erneut übermittelt wird: Es darf weiterhin nur einen Datensatz geben, und kein Seiteneffekt darf wiederholt werden.
- Kann der Benutzer zwischen Entgegennahme, Verarbeitung und Endergebnis unterscheiden?
- Ist festgelegt, ob die Datei korrigiert und erneut hochgeladen oder nur fehlgeschlagene Zeilen erneut übermittelt werden?
- Verhindern stabile Schlüssel, dass bereits importierte Datensätze dupliziert werden?
- Spiegeln die Zähler bestätigte Arbeit wider und werden sie in angemessener Häufigkeit aktualisiert?
- Erfordern Statusabfragen und das Herunterladen von Fehlern die passenden Berechtigungen?
- Sind Wiederholen, Fortsetzen und Abbrechen mit klar definierten und überprüfbaren Auswirkungen verbunden?
- Wurden Teilfehler, Nebenläufigkeit und Datenaufbewahrung getestet?
Ein nachvollziehbarer Import ist mehr als ein Fortschrittsbalken. Er benötigt verständliche Statusangaben, abrufbare Ergebnisse und eine Korrekturrichtlinie, die bestätigte Datensätze nicht erneut übernimmt. Wenn dieser Vertrag vom Ausführungsmechanismus getrennt ist, lässt sich die Verarbeitung weiterentwickeln, ohne den Benutzer im Unklaren zu lassen.