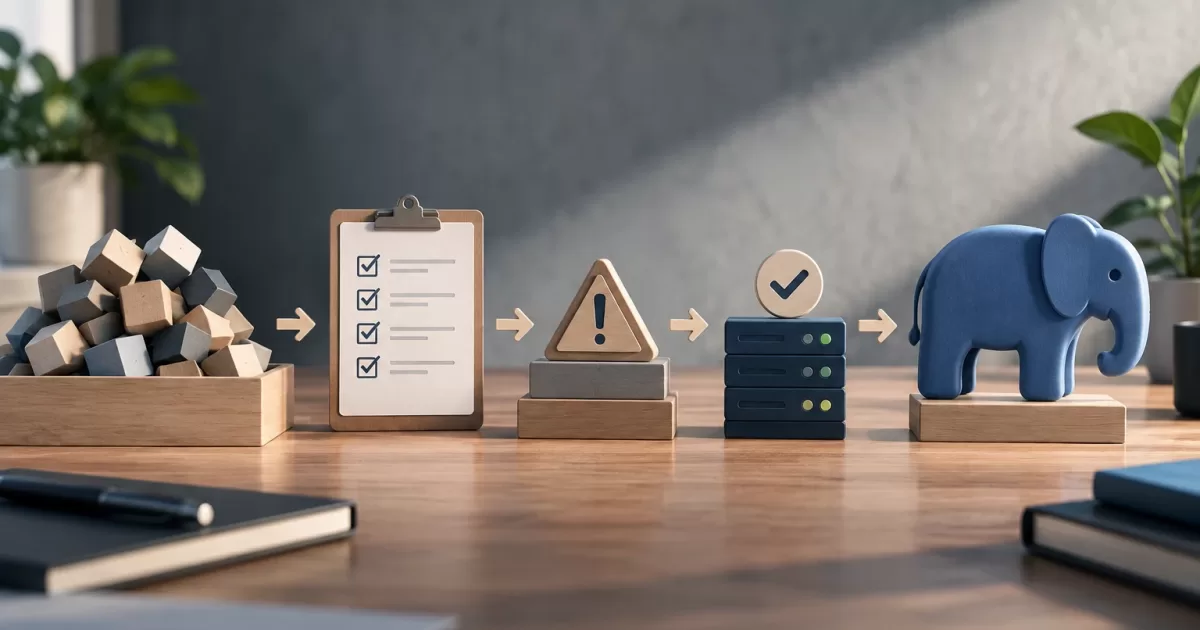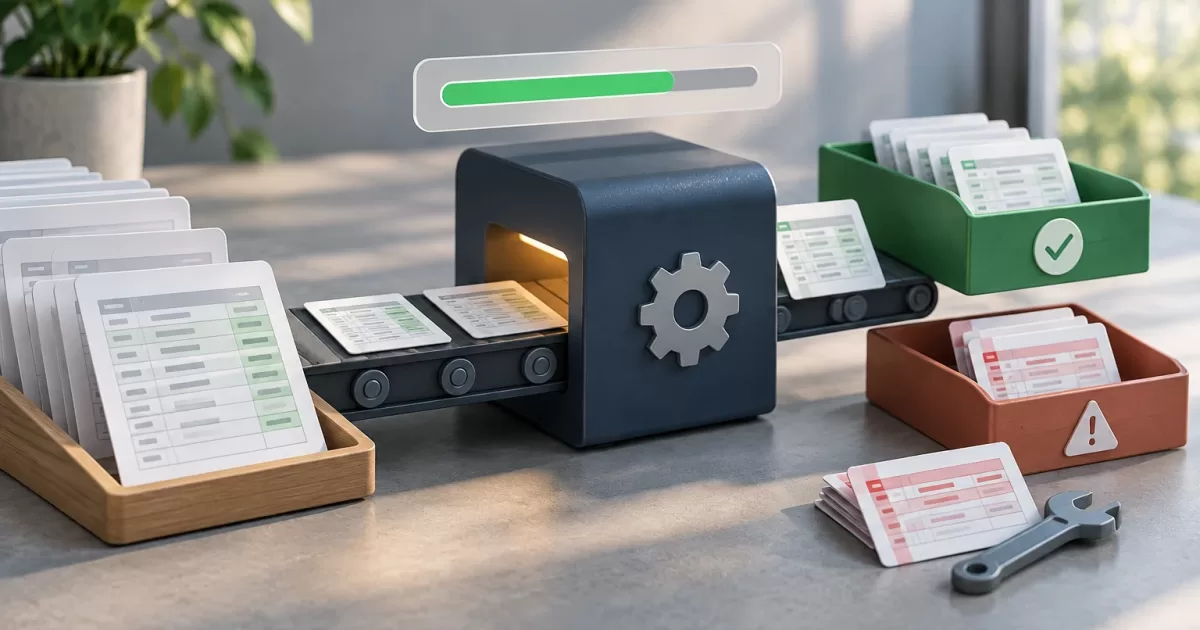
Uma importação grande não deve depender de o usuário manter uma requisição HTTP aberta nem deixá-lo sem saber se o sistema continua trabalhando. Uma API bem projetada transforma o processo em uma operação identificável e observável: recebe o arquivo, valida sua estrutura, processa os dados e comunica o resultado, incluindo os erros que exigem correção.
O acompanhamento do progresso de importações em PHP faz parte do contrato da API, não é uma tecnologia de filas. Convém separar três questões relacionadas: qual estado o usuário consulta, como o trabalho é executado em segundo plano e como recuperar uma tarefa que falha.
Por que não processar toda a importação em uma requisição HTTP
Uma requisição síncrona mantém o cliente esperando. Em uma importação extensa, o processamento pode ultrapassar os limites do servidor web, de um proxy ou do próprio cliente. Além disso, se a conexão for interrompida, pode ficar a dúvida sobre se alguns registros chegaram a ser modificados.
Uma alternativa é aceitar a solicitação, salvar o arquivo em um local acessível ao processador, registrar a operação e devolver um identificador. O trabalho é executado depois, fora da requisição inicial. Uma fila pode coordená-lo, mas não substitui o estado persistido que a API precisa expor.
A resposta de aceitação confirma que a solicitação foi recebida, não que todos os dados foram importados. Por isso, deve incluir um identificador que possa ser consultado e um estado inicial. A validação do tamanho e do formato pode rejeitar arquivos inadequados, mas não garante que cada linha seja válida.
Definir estados, transições e resultados
Defina um conjunto limitado de estados e transições verificáveis. Um ciclo possível inclui received, validating e processing, com resultados terminais como completed, completed_with_errors, failed e cancelled. Os nomes podem variar; o significado deve ser inequívoco.
completed_with_errors pode indicar que as linhas válidas foram aplicadas e que as restantes estão disponíveis para correção. Reserve failed para uma situação que impeça a continuidade ou a obtenção de um resultado confiável. Não declare sucesso apenas porque o processo técnico terminou se ainda houver dados não aplicados.
- Defina quais estados são transitórios e quais são terminais.
- Documente quem pode iniciar cada transição e em quais condições.
- Separe erros gerais de erros associados a uma linha.
- Inclua datas de criação, início e término quando ajudarem a interpretar o resultado.
- Não exponha rastreamentos, mensagens internas nem dados sensíveis em respostas públicas.
Proteja as transições contra execuções duplicadas e atualizações fora de ordem. Uma operação terminal não deve voltar a processing devido a uma notificação atrasada. Atualizações condicionadas por estado ou versão são formas comuns de impedir sobrescritas concorrentes.
Separar o recebimento da validação das linhas
No recebimento, verifique permissões, tamanho, tipo de arquivo e metadados obrigatórios. Uma validação inicial pode verificar as colunas obrigatórias e a estrutura. Se não for possível interpretar o arquivo, rejeite-o ou encerre a operação antes de aplicar alterações parciais sem uma política definida.
A validação por linha ocorre durante o processamento. Ela pode detectar referências inexistentes, valores inválidos ou conflitos com os dados atuais. Decida se as linhas válidas serão aplicadas mesmo que outras falhem ou se a operação deverá ser atômica e revertida. A decisão depende do domínio e dos efeitos colaterais e deve ficar clara para o usuário.
Identifique cada linha de forma estável, por meio de uma chave de origem ou, se ela não existir, de uma referência vinculada ao lote. Armazene um código de erro e uma mensagem compreensível. Em arquivos grandes, retorne os erros paginados ou por meio de um resultado para download protegido, em vez de repeti-los em cada consulta de status.
Projetar um fluxo para corrigir e reenviar erros
O produto pode permitir corrigir o arquivo inteiro e carregá-lo como uma nova importação, ou reenviar apenas as linhas com falha. A primeira opção é mais simples de explicar, mas exige reconhecer os registros já aplicados ao processar o arquivo novamente. A segunda reduz o trabalho repetido, embora exija conservar as chaves de origem e associar cada nova tentativa à importação inicial.
Para o reenvio parcial, ofereça uma ação explícita que aceite apenas linhas com falha ou não confirmadas e os dados corrigidos. Não se baseie apenas no número da linha: o usuário pode alterar a ordem ou a estrutura do arquivo. Conserve o resultado da tentativa anterior para auditoria e valide novamente os dados recebidos.
A prevenção de duplicatas exige uma identidade estável por registro. Pode ser um identificador externo ou uma chave gerada e persistida para a linha. Aplique uma restrição única adequada e defina se uma repetição deve atualizar o registro existente, ser rejeitada ou ignorada. Em qualquer caso, as linhas já confirmadas não devem voltar a produzir efeitos colaterais. Operações idempotentes e transações por linha ou lote ajudam a manter essa garantia.
Publicar o progresso e controlar a consulta de status
Informe as unidades processadas e o total quando este for conhecido. Acrescente a etapa atual — por exemplo, validação ou aplicação — se isso ajudar a explicar a espera. Se o total ainda não for conhecido, informe a etapa sem inventar uma porcentagem. Uma porcentagem pode ser enganosa se as fases tiverem durações muito diferentes.
Não é necessário persistir uma atualização para cada linha. Agrupe-as de acordo com o custo e a utilidade da informação e evite que o cliente consulte sem limite. A interface pode espaçar as consultas e interrompê-las ao receber um estado terminal. Também é possível usar notificações, mas deve continuar sendo possível recuperar o estado atual após recarregar a página ou perder a conectividade.
Autorize cada consulta e verifique se quem a solicita pode acessar aquela operação específica. Um identificador difícil de adivinhar não substitui as permissões. Aplique o mesmo controle aos erros e aos arquivos para download e defina por quanto tempo serão mantidos.
Distinguir tentar novamente, retomar e cancelar
Tentar novamente é executar outra vez algo que falhou; retomar é continuar de um ponto salvo. Uma nova tentativa pode repetir linhas ou efeitos colaterais se o processamento não for idempotente. Antes de oferecê-la, determine o que foi confirmado e como as duplicatas serão detectadas.
Retomar exige salvar informações suficientes para identificar o último trabalho confirmado e evitar reaplicar o que já foi processado. Se os dados de origem tiverem mudado ou não for possível garantir uma continuação coerente, é mais seguro criar uma nova importação do que afirmar que ela está sendo retomada.
Cancelar também não desfaz automaticamente as alterações aplicadas. Defina se o cancelamento só é aceito antes do início, se é verificado entre lotes ou se há compensações. Informe se a operação foi interrompida antes do processamento, se restaram alterações parciais ou se já era tarde demais para interrompê-la.
Modelo de dados e fluxo de API em PHP
Um modelo inicial pode incluir uma tabela imports com id, owner_id, status, stage, total_rows, processed_rows, success_rows, error_rows, file_key, created_at, started_at, finished_at e version. Em import_rows, armazene import_id, source_key, row_number, status e attempt_count. Uma restrição única sobre import_id e source_key identifica uma linha dentro do lote. Uma tabela import_errors pode armazenar a chave, o código e uma mensagem segura para o usuário.
Um fluxo REST ilustrativo aceita o arquivo por meio de POST /api/imports e responde com 202 Accepted e {"id":"imp_8f2a","status":"received","status_url":"/api/imports/imp_8f2a"}. O cliente consulta GET /api/imports/imp_8f2a; uma resposta durante o processamento poderia ser {"status":"processing","stage":"applying","total_rows":1200,"processed_rows":450,"success_rows":438,"error_rows":12}. Para obter erros, use uma rota paginada, como GET /api/imports/imp_8f2a/errors?limit=50&cursor=....
Se for permitido reenviar apenas as linhas com falha, POST /api/imports/imp_8f2a/retry-errors pode receber chaves de origem e dados corrigidos. A rota deve rejeitar as chaves que já constem como aplicadas ou tratá-las com uma política idempotente explícita e retornar o identificador da nova tentativa. A rota não deve ocultar que está sendo criada uma tentativa relacionada, em vez de apagar o histórico anterior.
Em PHP, o controlador registra a operação e responde sem processar o arquivo inteiro na requisição. Este trecho é pseudocódigo no estilo do PHP 7: não usa argumentos nomeados, e setJsonBody() representa um adaptador próprio, não um método padrão do PHP nem algo portátil entre frameworks. Em uma aplicação real, ele deve ser substituído pela resposta da implementação ou do framework utilizado:
$import = $imports->create(
    $user->id,
    $storedFile->key,
    'received'
);

$dispatcher->dispatch(new ProcessImport($import->id));

$response->setStatusCode(202);
$response->setJsonBody(array(
    'id' => $import->id,
    'status' => 'received',
    'status_url' => '/api/imports/' . $import->id
));

return $response;
O exemplo mostra a separação entre aceitação e execução, mas, por si só, não garante que o trabalho seja registrado de forma durável. Coordene a persistência da operação e o envio do trabalho para que uma falha entre essas duas etapas não deixe uma importação sem processamento. Dependendo da infraestrutura, pode-se usar uma transação com o padrão outbox ou outro mecanismo confiável.
Testes e lista de verificação
Teste transições válidas e inválidas, arquivos malformados, erros parciais, solicitações duplicadas e interrupções. Verifique se uma operação terminal não publica atualizações posteriores, se os contadores são coerentes e se a paginação dos erros respeita as permissões. Inclua o caso em que uma linha já aplicada aparece em um reenvio: deve continuar havendo um único registro, sem repetir nenhum efeito colateral.
- O usuário consegue distinguir recebimento, processamento e resultado final?
- Está definido se ele corrige e carrega o arquivo novamente ou reenvia apenas as linhas com falha?
- As chaves estáveis evitam duplicar registros já importados?
- Os contadores refletem o trabalho confirmado e são atualizados com uma frequência razoável?
- A consulta de status e o download dos erros exigem as permissões adequadas?
- Tentar novamente, retomar e cancelar têm efeitos definidos e verificáveis?
- Foram testadas falhas parciais, concorrência e preservação dos dados?
Uma importação observável não é apenas uma barra de progresso. Ela precisa de estados compreensíveis, resultados consultáveis e uma política de correção que não volte a aplicar registros confirmados. Separar esse contrato do mecanismo de execução permite evoluir o processamento sem deixar o usuário sem informações.