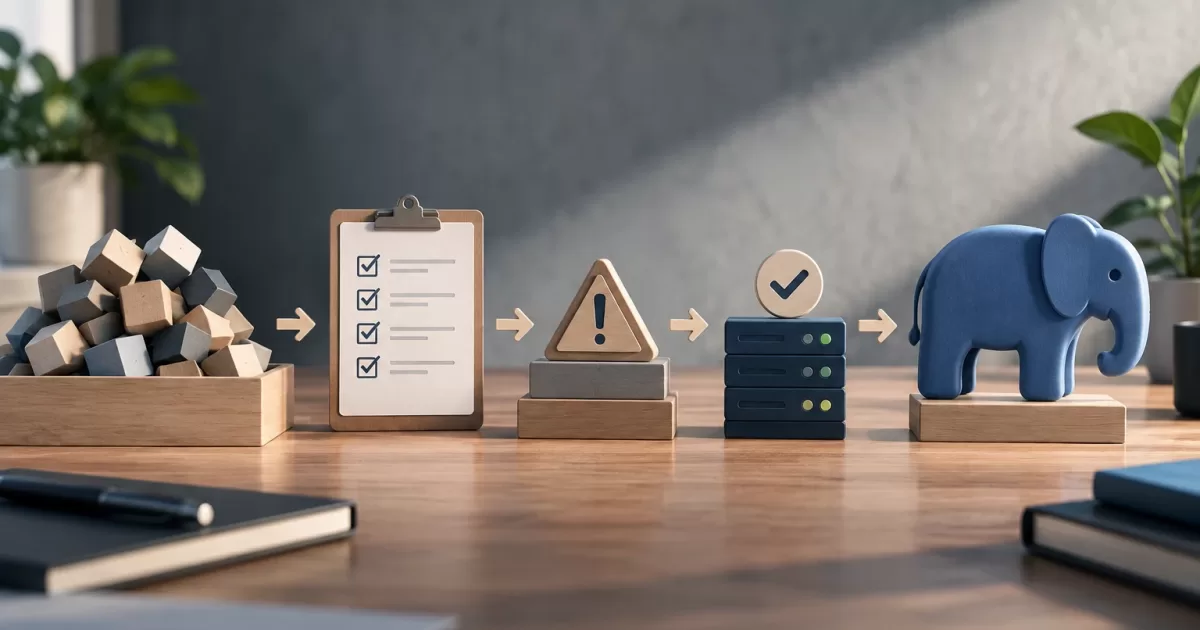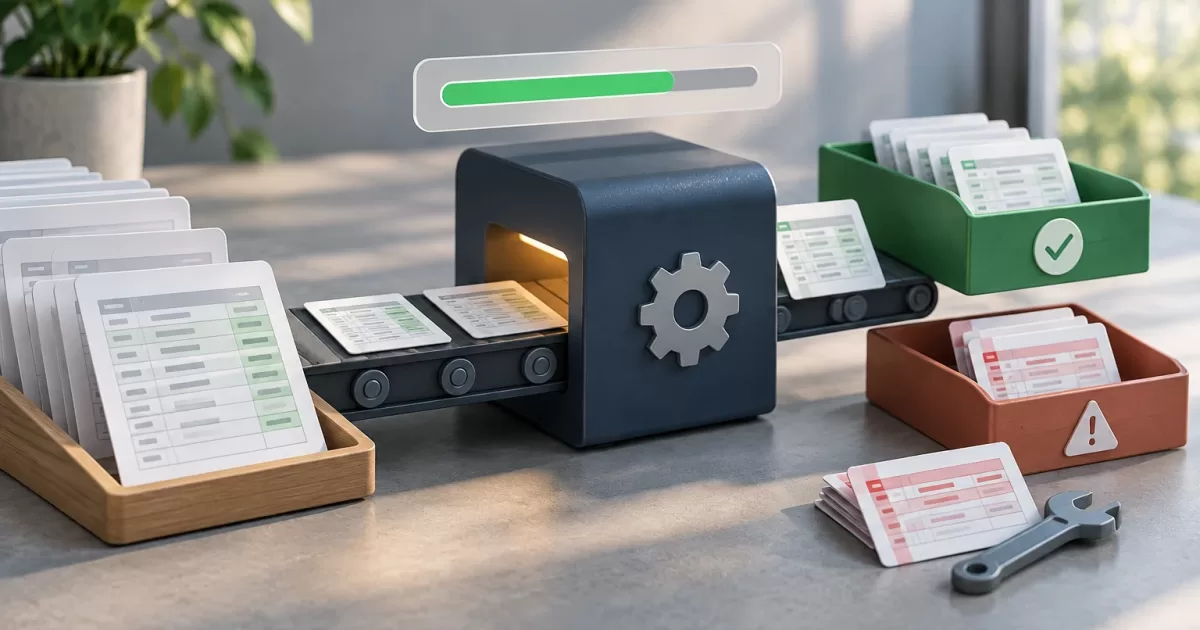
Une importation volumineuse ne devrait pas dépendre du fait que l’utilisateur garde une requête HTTP ouverte, ni le laisser sans savoir si le système est toujours en train de travailler. Une API bien conçue transforme le processus en une opération identifiable et observable : elle reçoit le fichier, en valide la structure, traite les données et communique le résultat, y compris les erreurs qui nécessitent une correction.
Le suivi de la progression des importations en PHP fait partie du contrat de l’API, et non d’une technologie de file d’attente. Il convient de distinguer trois sujets liés : l’état consulté par l’utilisateur, l’exécution du travail en arrière-plan et la récupération d’une tâche qui échoue.
Pourquoi ne pas traiter toute l’importation dans une requête HTTP
Une requête synchrone fait attendre le client. Lors d’une importation longue, le traitement peut dépasser les limites du serveur web, d’un proxy ou du client lui-même. De plus, si la connexion est interrompue, il peut être difficile de savoir si certains enregistrements ont été modifiés.
Une solution consiste à accepter la demande, à enregistrer le fichier dans un emplacement accessible au processeur, à consigner l’opération et à renvoyer un identifiant. Le travail est ensuite exécuté en dehors de la requête initiale. Une file d’attente peut le coordonner, mais elle ne remplace pas l’état persistant que l’API doit exposer.
La réponse d’acceptation confirme que la demande a été reçue, et non que toutes les données ont été importées. Elle doit donc inclure un identifiant consultable et un état initial. La validation de la taille et du format peut rejeter les fichiers inadaptés, mais elle ne garantit pas la validité de chaque ligne.
Définir les états, les transitions et les résultats
Convenez d’un ensemble limité d’états et de transitions vérifiables. Un cycle possible comprend received, validating et processing, avec des résultats terminaux tels que completed, completed_with_errors, failed et cancelled. Les noms peuvent varier ; leur signification doit être sans ambiguïté.
completed_with_errors peut indiquer que les lignes valides ont été appliquées et que les autres peuvent être corrigées. Réservez failed aux situations qui empêchent de poursuivre ou d’obtenir un résultat fiable. Ne déclarez pas l’opération réussie simplement parce que le traitement technique est terminé si certaines données n’ont pas été appliquées.
- Définissez quels états sont transitoires et lesquels sont terminaux.
- Documentez qui peut déclencher chaque transition et sous quelles conditions.
- Distinguez les erreurs générales des erreurs associées à une ligne.
- Incluez les dates de création, de démarrage et de fin lorsqu’elles aident à interpréter le résultat.
- N’exposez pas de traces, de messages internes ni de données sensibles dans les réponses publiques.
Protégez les transitions contre les exécutions en double et les mises à jour dans le désordre. Une opération terminale ne doit pas repasser à processing à la suite d’une notification tardive. Les mises à jour conditionnées par l’état ou la version sont des moyens courants d’empêcher les écrasements concurrents.
Séparer la réception de la validation des lignes
À la réception, vérifiez les autorisations, la taille, le type de fichier et les métadonnées requises. Une validation initiale peut vérifier les colonnes obligatoires et la structure. Si le fichier ne peut pas être interprété, rejetez-le ou terminez l’opération avant d’appliquer des modifications partielles sans politique définie.
La validation ligne par ligne a lieu pendant le traitement. Elle peut révéler des références inexistantes, des valeurs invalides ou des conflits avec les données actuelles. Décidez si les lignes valides sont appliquées malgré l’échec des autres, ou si l’opération doit être atomique et annulée. Cette décision dépend du domaine et des effets secondaires ; elle doit être claire pour l’utilisateur.
Identifiez chaque ligne de manière stable, au moyen d’une clé source ou, à défaut, d’une référence liée au lot. Enregistrez un code d’erreur et un message compréhensible. Pour les fichiers volumineux, renvoyez les erreurs avec pagination ou dans un résultat téléchargeable protégé, au lieu de les répéter à chaque consultation de l’état.
Concevoir un flux de correction et de renvoi des erreurs
Le produit peut permettre de corriger le fichier complet et de le charger comme une nouvelle importation, ou de renvoyer uniquement les lignes en échec. La première option est plus simple à expliquer, mais impose de reconnaître les enregistrements déjà appliqués lors du nouveau traitement du fichier. La seconde réduit le travail répété, mais nécessite de conserver les clés source et d’associer chaque nouvelle tentative à l’importation initiale.
Pour le renvoi partiel, proposez une action explicite qui n’accepte que les lignes en échec ou non confirmées, ainsi que les données corrigées. Ne vous fondez pas uniquement sur le numéro de ligne : l’utilisateur peut modifier l’ordre ou la structure du fichier. Conservez le résultat de la tentative précédente à des fins d’audit et validez à nouveau les données reçues.
La prévention des doublons nécessite une identité stable pour chaque enregistrement. Il peut s’agir d’un identifiant externe ou d’une clé générée et persistée pour la ligne. Appliquez une contrainte d’unicité adaptée et définissez si une répétition doit mettre à jour l’enregistrement existant, être rejetée ou être ignorée. Dans tous les cas, les lignes déjà confirmées ne doivent pas produire à nouveau d’effets secondaires. Les opérations idempotentes et les transactions par ligne ou par lot contribuent au respect de cette garantie.
Publier la progression et contrôler la consultation de l’état
Indiquez le nombre d’unités traitées et le total lorsqu’il est connu. Ajoutez l’étape en cours — par exemple, validation ou application — si cela aide à expliquer l’attente. Si le total n’est pas encore connu, communiquez l’étape sans inventer de pourcentage. Un pourcentage peut être trompeur si les différentes phases prennent des durées très différentes.
Il n’est pas nécessaire de persister une mise à jour pour chaque ligne. Regroupez-les en fonction du coût et de l’utilité de l’information, et évitez que le client interroge l’API sans limite. L’interface peut espacer les consultations et les arrêter lorsqu’elle reçoit un état terminal. Elle peut aussi utiliser des notifications, mais il doit rester possible de récupérer l’état actuel après le rechargement de la page ou une perte de connectivité.
Autorisez chaque consultation et vérifiez que son auteur peut accéder à cette opération précise. Un identifiant difficile à deviner ne remplace pas les autorisations. Appliquez le même contrôle aux erreurs et aux fichiers téléchargeables, et définissez leur durée de conservation.
Distinguer relancer, reprendre et annuler
Relancer consiste à réexécuter ce qui a échoué ; reprendre consiste à continuer à partir d’un point enregistré. Une relance peut répéter des lignes ou des effets secondaires si le traitement n’est pas idempotent. Avant de la proposer, déterminez ce qui a été confirmé et comment les doublons sont détectés.
Reprendre exige d’enregistrer suffisamment d’informations pour identifier le dernier travail confirmé et éviter de réappliquer ce qui a déjà été traité. Si les données source ont changé ou si la cohérence de la reprise ne peut pas être garantie, il est plus sûr de créer une nouvelle importation que de prétendre reprendre l’ancienne.
Annuler n’annule pas automatiquement les modifications déjà appliquées. Définissez si l’annulation n’est acceptée qu’avant le démarrage, si elle est vérifiée entre les lots ou si elle implique des compensations. Indiquez si l’opération a été arrêtée avant tout traitement, si des modifications partielles subsistent ou s’il était déjà trop tard pour l’interrompre.
Modèle de données et flux d’API en PHP
Un modèle de données initial peut inclure une table imports contenant id, owner_id, status, stage, total_rows, processed_rows, success_rows, error_rows, file_key, created_at, started_at, finished_at et version. Dans import_rows, enregistrez import_id, source_key, row_number, status et attempt_count. Une contrainte d’unicité sur import_id et source_key identifie une ligne au sein du lot. Une table import_errors peut enregistrer la clé, le code et un message sûr pour l’utilisateur.
Un flux REST illustratif accepte le fichier via POST /api/imports et renvoie 202 Accepted avec {"id":"imp_8f2a","status":"received","status_url":"/api/imports/imp_8f2a"}. Le client interroge GET /api/imports/imp_8f2a ; une réponse pendant le traitement pourrait être {"status":"processing","stage":"applying","total_rows":1200,"processed_rows":450,"success_rows":438,"error_rows":12}. Pour obtenir les erreurs, utilisez une route paginée comme GET /api/imports/imp_8f2a/errors?limit=50&cursor=....
Si le renvoi des seules lignes en échec est autorisé, POST /api/imports/imp_8f2a/retry-errors peut recevoir des clés source et les données corrigées. La route doit rejeter les clés déjà enregistrées comme appliquées ou les traiter selon une politique idempotente explicite, et renvoyer l’identifiant de la nouvelle tentative. Elle ne doit pas masquer le fait qu’une tentative liée est créée, au lieu d’effacer l’historique précédent.
En PHP, le contrôleur enregistre l’opération et répond sans traiter le fichier complet dans la requête. Cet extrait est du pseudocode de style PHP 7 : il n’utilise pas d’arguments nommés et setJsonBody() représente un adaptateur propre au projet, et non une méthode standard de PHP ni une méthode portable entre frameworks. Dans une application réelle, il faut le remplacer par la réponse de l’implémentation ou du framework utilisé :
$import = $imports->create(
    $user->id,
    $storedFile->key,
    'received'
);

$dispatcher->dispatch(new ProcessImport($import->id));

$response->setStatusCode(202);
$response->setJsonBody(array(
    'id' => $import->id,
    'status' => 'received',
    'status_url' => '/api/imports/' . $import->id
));

return $response;
L’exemple illustre la séparation entre acceptation et exécution, mais ne garantit pas à lui seul que le travail sera enregistré de façon durable. Coordonnez la persistance de l’opération et l’envoi du travail afin qu’une défaillance entre ces deux étapes ne laisse pas une importation sans traitement. Selon l’infrastructure, une transaction avec le pattern outbox ou un autre mécanisme fiable peut être utilisé.
Tests et liste de contrôle
Testez les transitions valides et invalides, les fichiers mal formés, les erreurs partielles, les demandes en double et les interruptions. Vérifiez qu’une opération terminale ne publie plus de progression, que les compteurs sont cohérents et que la pagination des erreurs respecte les autorisations. Incluez le cas où une ligne déjà appliquée apparaît dans un renvoi : il ne doit toujours y avoir qu’un seul enregistrement et aucun effet secondaire ne doit se répéter.
- L’utilisateur distingue-t-il la réception, le traitement et le résultat final ?
- Est-il défini s’il doit corriger et recharger le fichier ou renvoyer uniquement les lignes en échec ?
- Les clés stables évitent-elles de dupliquer les enregistrements déjà importés ?
- Les compteurs reflètent-ils le travail confirmé et sont-ils actualisés à une fréquence raisonnable ?
- La consultation de l’état et le téléchargement des erreurs nécessitent-ils les autorisations appropriées ?
- Les effets de la relance, de la reprise et de l’annulation sont-ils définis et vérifiables ?
- Les échecs partiels, la concurrence et la conservation des données ont-ils été testés ?
Une importation observable ne se résume pas à une barre de progression. Elle nécessite des états compréhensibles, des résultats consultables et une politique de correction qui n’applique pas à nouveau les enregistrements confirmés. En séparant ce contrat du mécanisme d’exécution, il est possible de faire évoluer le traitement sans laisser l’utilisateur sans information.