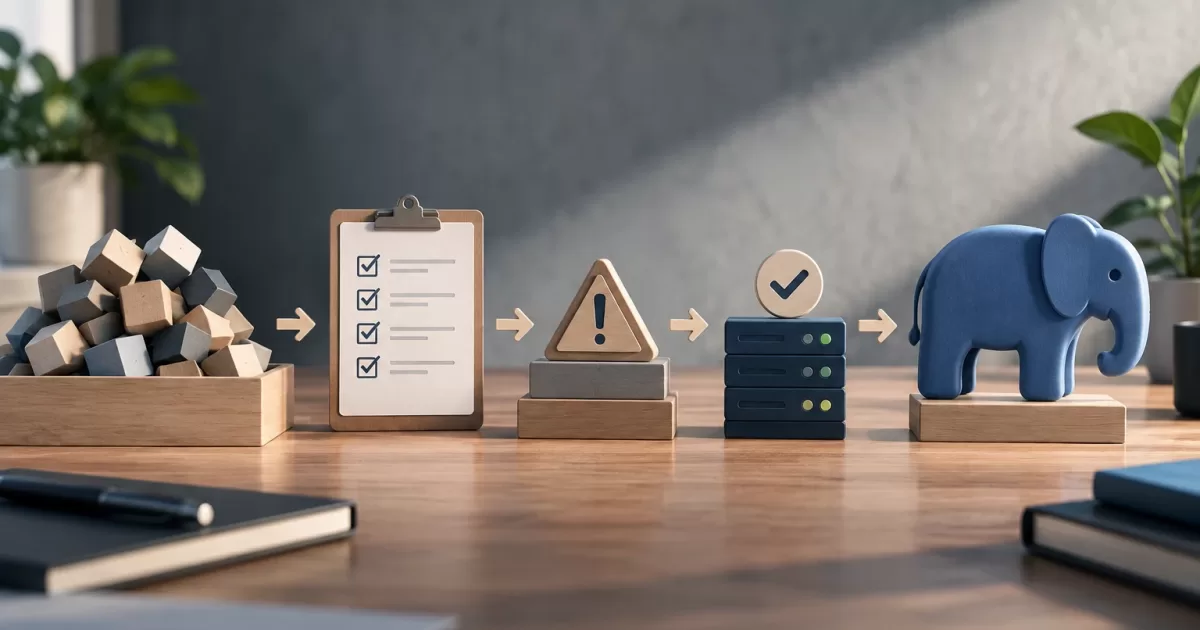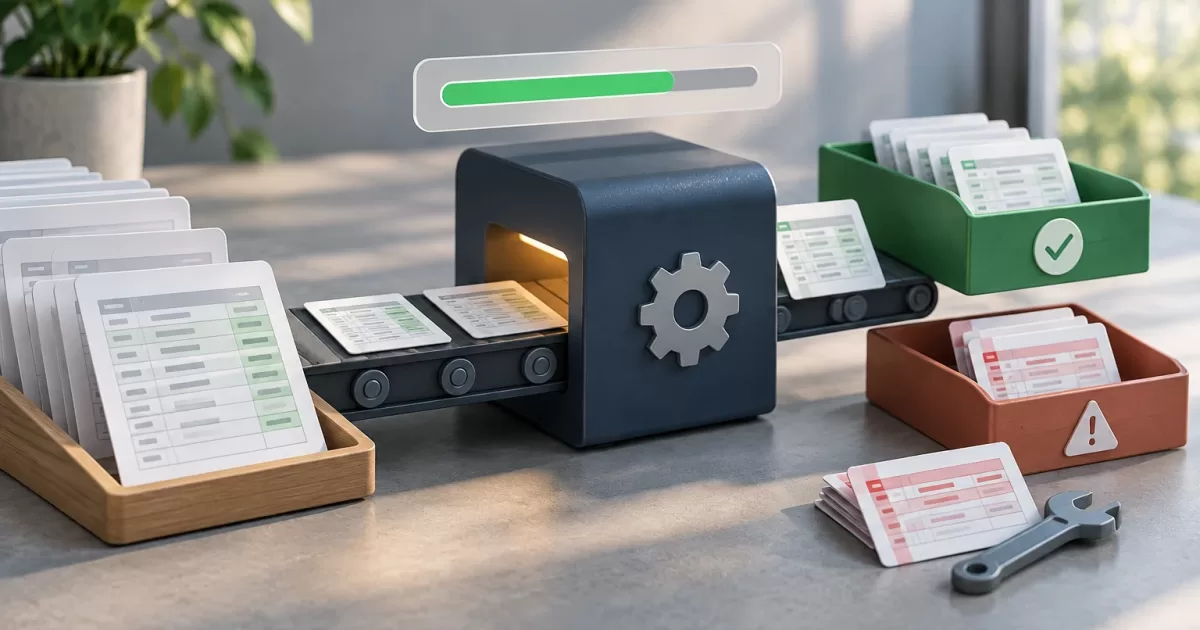
大規模なインポートを、ユーザーがHTTPリクエストを開いたままにしておくことに依存させたり、システムが処理を続けているかどうか分からない状態にしたりすべきではありません。適切に設計されたAPIは、ファイルを受け取り、構造を検証し、データを処理して、修正が必要なエラーも含めた結果を通知する、識別・監視可能な操作として処理を実現します。
PHPにおけるインポートの進捗追跡は、キュー技術ではなくAPI契約の一部です。関連する次の3点を分けて考えるとよいでしょう。ユーザーが確認する状態、バックグラウンドでのジョブ実行方法、失敗したタスクの復旧方法です。
インポート全体を1回のHTTPリクエストで処理しない理由
同期リクエストでは、クライアントは処理が終わるまで待つことになります。大規模なインポートでは、処理時間がWebサーバー、プロキシ、またはクライアント自体の制限を超える場合があります。さらに、接続が切断されると、一部のレコードが変更されたかどうか分からなくなることがあります。
代替策として、リクエストを受け付け、処理担当がアクセスできる場所にファイルを保存し、操作を記録して識別子を返す方法があります。ジョブは最初のリクエストの終了後に実行されます。キューで処理を調整することはできますが、APIが公開する必要のある永続化された状態の代わりにはなりません。
受付応答が確認するのはリクエストを受け取ったことだけで、すべてのデータがインポートされたことではありません。そのため、照会可能な識別子と初期状態を含める必要があります。サイズや形式の検証で不適切なファイルを拒否できますが、すべての行が有効であることまでは保証できません。
状態、遷移、結果を定義する
検証可能な、限定された状態と遷移の集合を決めます。たとえば、received、validating、processingを経て、completed、completed_with_errors、failed、cancelledなどの終端状態に至るサイクルが考えられます。名称は変えてもかまいませんが、意味は明確でなければなりません。
completed_with_errorsは、有効な行は適用済みで、残りの行は修正可能であることを示せます。処理を続行できない場合や、信頼できる結果を把握できない場合にfailedを使用します。未適用のデータが残っているなら、技術的な処理が終わったというだけで成功を宣言してはいけません。
- 一時状態と終端状態を定義する。
- 各遷移を誰が、どの条件で開始できるかを文書化する。
- 全般的なエラーと行に関連するエラーを分ける。
- 結果の解釈に役立つ場合は、作成日時、開始日時、終了日時を含める。
- 公開応答にスタックトレース、内部メッセージ、機密データを含めない。
重複実行や順序が逆転した更新から、状態遷移を保護します。終端状態の操作が、遅れて届いた通知によって再びprocessingに戻ってはいけません。状態またはバージョンを条件とした更新は、同時実行による上書きを防ぐ一般的な方法です。
受付と行ごとの検証を分ける
受付時に、権限、サイズ、ファイル形式、必須メタデータを確認します。初期検証では、必須列や構造を確認できます。ファイルを解釈できない場合は、明確な方針なしに一部の変更を適用する前に、リクエストを拒否するか操作を終了します。
行ごとの検証は処理中に行います。存在しない参照、無効な値、現在のデータとの競合が見つかる場合があります。ほかの行にエラーがあっても有効な行を適用するのか、それとも操作をアトミックにしてロールバックするのかを決めます。この判断はドメインと副作用によって異なり、ユーザーに明確に伝える必要があります。
各行を、ソースキー、または存在しない場合はバッチに紐づく参照によって安定的に識別します。エラーコードと分かりやすいメッセージを保存します。大きなファイルでは、状態を照会するたびにエラーを繰り返すのではなく、ページ分割して返すか、保護されたダウンロード可能な結果として提供します。
エラーを修正して再送するフローを設計する
ファイル全体を修正して新しいインポートとしてアップロードする方法と、失敗した行だけを再送する方法があります。前者は説明しやすい一方、ファイルを再処理したときに適用済みレコードを識別する必要があります。後者は重複作業を減らせますが、ソースキーを保持し、新しい試行を最初のインポートに関連付ける必要があります。
部分再送では、失敗または未確認の行と修正済みデータだけを受け付ける、明示的なアクションを提供します。行番号だけに依存してはいけません。ユーザーがファイルの順序や構造を変更する可能性があるためです。監査用に前回の試行結果を保持し、受け取ったデータを再検証します。
重複を防ぐには、レコードごとに安定した識別子が必要です。外部ID、または行ごとに生成して永続化したキーを使用できます。適切な一意制約を適用し、再送時に既存レコードを更新するのか、拒否するのか、無視するのかを定義します。いずれの場合も、確認済みの行によって副作用を再度発生させてはいけません。冪等な操作や行単位・バッチ単位のトランザクションは、この保証の維持に役立ちます。
進捗を公開し、状態照会を制御する
処理済み件数と、判明している場合は総件数を通知します。待ち時間の説明に役立つなら、現在の段階(検証や適用など)も追加します。総件数がまだ不明なら、割合を捏造せず段階だけを伝えます。各段階の所要時間が大きく異なる場合、パーセンテージは誤解を招くことがあります。
行ごとに更新を永続化する必要はありません。コストと情報の有用性に応じてまとめ、クライアントが無制限に照会しないようにします。インターフェース側で照会間隔を空け、終端状態を受け取ったら停止できます。通知を使うこともできますが、ページの再読み込みや接続断の後でも現在の状態を取得できなければなりません。
すべての照会を認可し、リクエストしたユーザーがその特定の操作にアクセスできることを確認します。推測しにくい識別子は、アクセス権限の代わりにはなりません。エラーやダウンロード可能なファイルにも同じ制御を適用し、保存期間を定義します。
再試行、再開、キャンセルを区別する
再試行は失敗した処理をもう一度実行すること、再開は保存済みの地点から続行することです。処理が冪等でなければ、再試行によって行や副作用が重複する可能性があります。再試行を提供する前に、何が確認済みか、重複をどう検出するかを判断します。
再開には、最後に確認されたジョブを特定し、処理済みの内容を再適用しないための十分な情報を保存する必要があります。ソースデータが変更された場合や、一貫した続行を保証できない場合は、再開できると称するより、新しいインポートを作成するほうが安全です。
キャンセルしても、適用済みの変更が自動的に取り消されるわけではありません。開始前のみ受け付けるのか、バッチ間で確認するのか、補償処理を行うのかを定義します。処理開始前に停止したのか、一部変更が残ったのか、中断するにはすでに遅すぎたのかを伝えます。
PHPにおけるデータモデルとAPIフロー
初期モデルには、id、owner_id、status、stage、total_rows、processed_rows、success_rows、error_rows、file_key、created_at、started_at、finished_at、versionを持つimportsテーブルを含められます。import_rowsには、import_id、source_key、row_number、status、attempt_countを保存します。import_idとsource_keyに対する一意制約により、バッチ内の行を識別できます。import_errorsテーブルには、キー、コード、ユーザー向けの安全なメッセージを保存できます。
RESTフローの例では、POST /api/importsでファイルを受け付け、{"id":"imp_8f2a","status":"received","status_url":"/api/imports/imp_8f2a"}を含む202 Acceptedを返します。クライアントはGET /api/imports/imp_8f2aで照会します。処理中の応答例は{"status":"processing","stage":"applying","total_rows":1200,"processed_rows":450,"success_rows":438,"error_rows":12}です。エラーの取得には、GET /api/imports/imp_8f2a/errors?limit=50&cursor=...のようなページ分割されたエンドポイントを使用します。
失敗した行だけの再送を許可する場合、POST /api/imports/imp_8f2a/retry-errorsでソースキーと修正済みデータを受け取れます。適用済みとして記録されているキーは拒否するか、明示的な冪等性ポリシーに従って処理し、新しい試行の識別子を返す必要があります。前の履歴を削除するのではなく、関連する試行を作成することを、このエンドポイントで隠してはいけません。
PHPでは、コントローラーが操作を記録し、リクエスト内でファイル全体を処理せずに応答します。このコード片はPHP 7風の擬似コードです。名前付き引数は使用しておらず、setJsonBody()は独自アダプターを表すもので、PHP標準のメソッドでもフレームワーク間で共通のメソッドでもありません。実際のアプリケーションでは、使用する実装またはフレームワークの応答処理に置き換える必要があります。
$import = $imports->create(
    $user->id,
    $storedFile->key,
    'received'
);

$dispatcher->dispatch(new ProcessImport($import->id));

$response->setStatusCode(202);
$response->setJsonBody(array(
    'id' => $import->id,
    'status' => 'received',
    'status_url' => '/api/imports/' . $import->id
));

return $response;
この例は受付と実行の分離を示していますが、それだけでジョブが永続的に記録されることを保証するものではありません。両方の手順の間で障害が起きても、未処理のままインポートが残らないよう、操作の永続化とジョブの投入を連携させます。インフラに応じて、outboxパターンを用いたトランザクションなど、信頼性の高い仕組みを利用できます。
テストとチェックリスト
有効・無効な遷移、不正な形式のファイル、一部の行でのエラー、重複リクエスト、中断をテストします。終端状態になった操作が後続の進捗を公開しないこと、カウンターに整合性があること、エラーのページ分割で権限が守られることを検証します。適用済みの行が再送に含まれるケースもテストします。この場合、レコードが1件だけ維持され、副作用が繰り返されないことが必要です。
- ユーザーは受付、処理、最終結果を区別できるか?
- ファイルを修正して再アップロードするのか、失敗した行だけを再送するのかが定義されているか?
- 安定したキーによって、インポート済みレコードの重複を防げるか?
- カウンターは確認済みの処理を反映し、妥当な頻度で更新されるか?
- 状態照会とエラーのダウンロードに適切な権限が必要か?
- 再試行、再開、キャンセルの効果は定義され、検証可能か?
- 部分的な失敗、同時実行、データ保持をテストしたか?
監視可能なインポートは、単なる進捗バーではありません。分かりやすい状態、照会可能な結果、確認済みレコードを再適用しない修正方針が必要です。この契約を実行の仕組みから分離すれば、ユーザーに情報を提供し続けながら、処理方法を進化させられます。