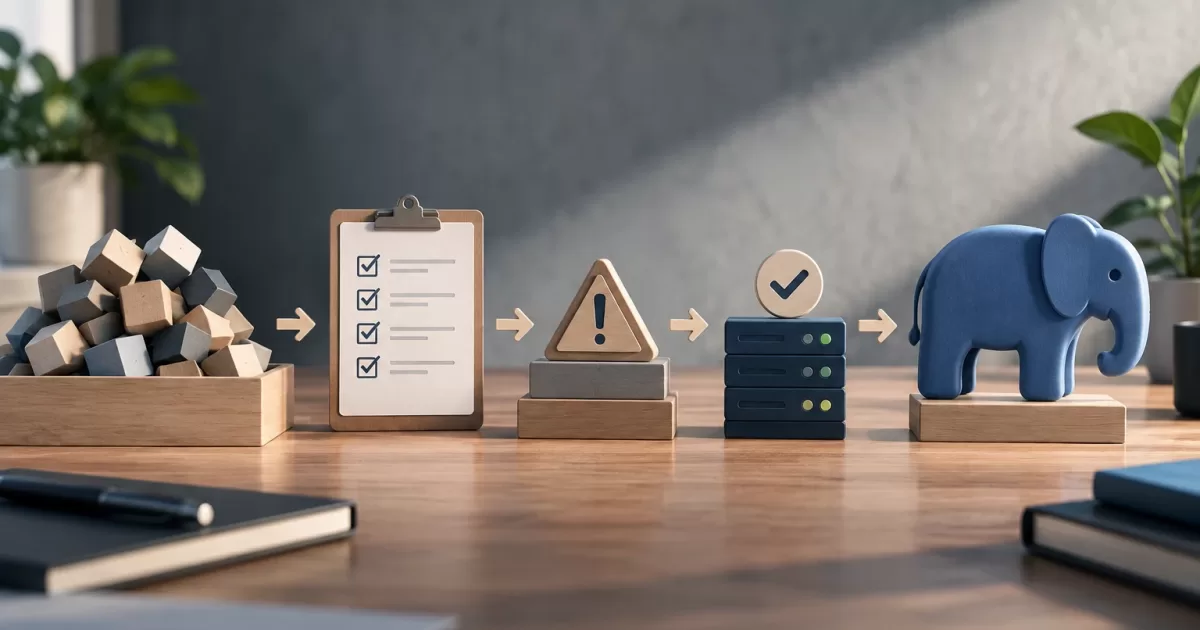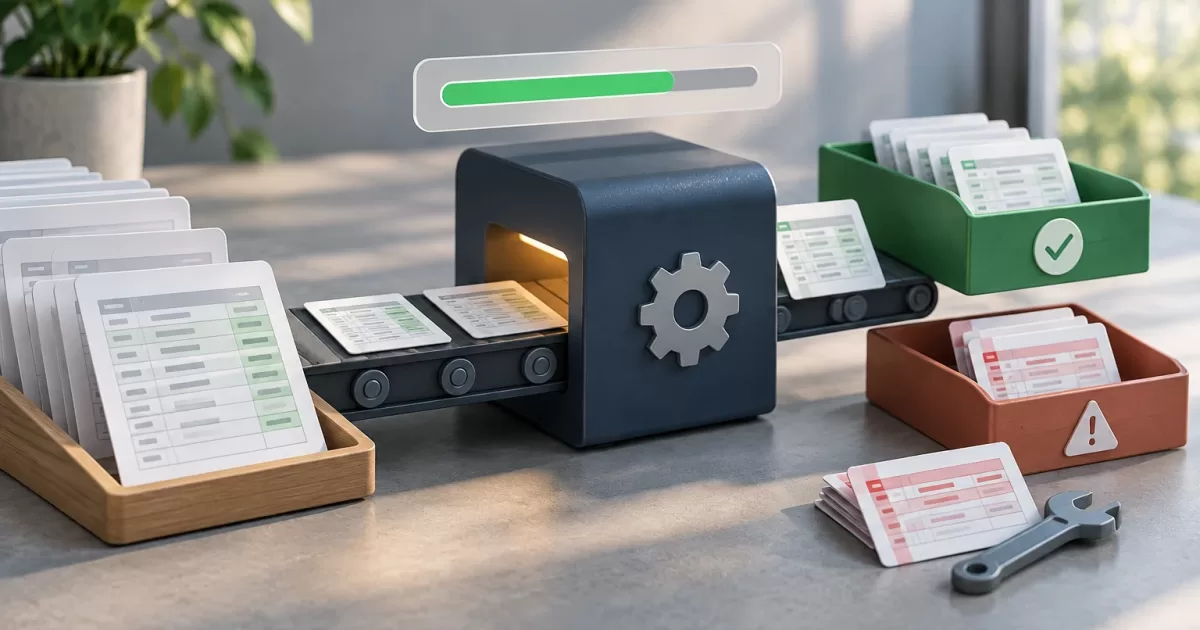
Una importación grande no debería depender de que el usuario mantenga abierta una petición HTTP ni dejarlo sin saber si el sistema sigue trabajando. Una API bien diseñada convierte el proceso en una operación identificable y observable: recibe el archivo, valida su estructura, procesa los datos y comunica el resultado, incluidos los errores que requieren corrección.
El seguimiento del progreso de importaciones en PHP es parte del contrato de la API, no una tecnología de colas. Conviene separar tres asuntos relacionados: qué estado consulta el usuario, cómo se ejecuta el trabajo en segundo plano y cómo se recupera una tarea que falla.
Por qué no procesar toda la importación en una petición HTTP
Una petición síncrona mantiene al cliente esperando. En una importación extensa, el procesamiento puede superar los límites del servidor web, un proxy o el propio cliente. Si la conexión se interrumpe, además, puede quedar la duda de si algunos registros llegaron a modificarse.
Una alternativa es aceptar la solicitud, guardar el archivo en un lugar accesible al procesador, registrar la operación y devolver un identificador. El trabajo se ejecuta después, fuera de la petición inicial. Una cola puede coordinarlo, pero no sustituye el estado persistido que la API necesita exponer.
La respuesta de aceptación confirma que se recibió la solicitud, no que todos los datos se importaron. Por eso debe incluir un identificador consultable y un estado inicial. La validación del tamaño y del formato puede rechazar archivos inadecuados, pero no garantiza que cada fila sea válida.
Definir estados, transiciones y resultados
Acuerda un conjunto acotado de estados y transiciones verificables. Un ciclo posible incluye received, validating y processing, con resultados terminales como completed, completed_with_errors, failed y cancelled. Los nombres pueden variar; el significado debe ser inequívoco.
completed_with_errors puede indicar que se aplicaron las filas válidas y que las restantes están disponibles para corregir. Reserva failed para una situación que impida continuar o conocer un resultado fiable. No declares éxito solo porque terminó el proceso técnico si quedaron datos sin aplicar.
- Define qué estados son transitorios y cuáles terminales.
- Documenta quién puede iniciar cada transición y en qué condiciones.
- Separa errores generales de errores asociados a una fila.
- Incluye fechas de creación, inicio y fin cuando ayuden a interpretar el resultado.
- No expongas trazas, mensajes internos ni datos sensibles en respuestas públicas.
Protege las transiciones ante ejecuciones duplicadas y actualizaciones fuera de orden. Una operación terminal no debe volver a processing por una notificación tardía. Las actualizaciones condicionadas por estado o versión son formas habituales de impedir sobrescrituras concurrentes.
Separar la recepción de la validación de filas
En la recepción, comprueba permisos, tamaño, tipo de archivo y metadatos requeridos. Una validación inicial puede verificar columnas obligatorias y estructura. Si el archivo no se puede interpretar, recházalo o termina la operación antes de aplicar cambios parciales sin una política definida.
La validación por fila se produce durante el procesamiento. Puede descubrir referencias inexistentes, valores inválidos o conflictos con los datos actuales. Decide si las filas válidas se aplican aunque otras fallen o si la operación debe ser atómica y revertirse. La decisión depende del dominio y de los efectos secundarios, y debe quedar clara para el usuario.
Identifica cada fila de forma estable, mediante una clave de origen o, si no existe, una referencia ligada al lote. Guarda un código de error y un mensaje comprensible. En archivos grandes, devuelve los errores paginados o mediante un resultado descargable protegido, en lugar de repetirlos en cada consulta de estado.
Diseñar un flujo para corregir y reenviar errores
El producto puede permitir corregir el archivo completo y cargarlo como una importación nueva, o reenviar únicamente las filas fallidas. La primera opción es más sencilla de explicar, pero exige reconocer los registros ya aplicados al volver a procesar el archivo. La segunda reduce el trabajo repetido, aunque requiere conservar las claves de origen y asociar cada nuevo intento con la importación inicial.
Para el reenvío parcial, ofrece una acción explícita que acepte solo filas fallidas o no confirmadas y los datos corregidos. No te bases únicamente en el número de línea: el usuario podría cambiar el orden o la estructura del archivo. Conserva el resultado del intento anterior para auditoría y vuelve a validar los datos recibidos.
La prevención de duplicados requiere una identidad estable por registro. Puede ser un identificador externo o una clave generada y persistida para la fila. Aplica una restricción única adecuada y define si una repetición debe actualizar el registro existente, rechazarse o ignorarse. En todo caso, las filas ya confirmadas no deben volver a producir efectos secundarios. Las operaciones idempotentes y las transacciones por fila o lote ayudan a mantener esa garantía.
Publicar progreso y controlar la consulta de estado
Informa de unidades procesadas y del total cuando este se conozca. Añade la etapa actual —por ejemplo, validación o aplicación— si ayuda a explicar una espera. Si aún no se conoce el total, comunica la etapa sin inventar un porcentaje. Un porcentaje puede resultar engañoso si las fases consumen tiempos muy distintos.
No es necesario persistir una actualización por cada fila. Agrúpalas según el coste y la utilidad de la información, y evita que el cliente consulte sin límite. La interfaz puede espaciar las consultas y detenerlas al recibir un estado terminal. También puede usar notificaciones, pero debe seguir siendo posible recuperar el estado actual tras recargar la página o perder conectividad.
Autoriza cada consulta y comprueba que quien la solicita puede acceder a esa operación concreta. Un identificador difícil de adivinar no reemplaza los permisos. Aplica el mismo control a los errores y archivos descargables, y define cuánto tiempo se conservan.
Distinguir reintentar, reanudar y cancelar
Reintentar es volver a ejecutar algo que falló; reanudar es continuar desde un punto guardado. Un reintento puede repetir filas o efectos secundarios si el procesamiento no es idempotente. Antes de ofrecerlo, determina qué se confirmó y cómo se detectan duplicados.
Reanudar exige guardar suficiente información para identificar el último trabajo confirmado y evitar aplicar de nuevo lo ya procesado. Si los datos de origen cambiaron o no se puede garantizar una continuación coherente, es más seguro crear una importación nueva que afirmar que se reanuda.
Cancelar tampoco deshace automáticamente los cambios aplicados. Define si solo se acepta antes de empezar, si se comprueba entre lotes o si hay compensaciones. Comunica si se detuvo antes de procesar, si quedaron cambios parciales o si ya era demasiado tarde para interrumpir.
Modelo de datos y flujo de API en PHP
Un modelo inicial puede incluir una tabla imports con id, owner_id, status, stage, total_rows, processed_rows, success_rows, error_rows, file_key, created_at, started_at, finished_at y version. En import_rows, guarda import_id, source_key, row_number, status y attempt_count. Una restricción única sobre import_id y source_key identifica una fila dentro del lote. Una tabla import_errors puede guardar la clave, el código y un mensaje seguro para el usuario.
Un flujo REST ilustrativo acepta el archivo mediante POST /api/imports y responde 202 Accepted con {"id":"imp_8f2a","status":"received","status_url":"/api/imports/imp_8f2a"}. El cliente consulta GET /api/imports/imp_8f2a; una respuesta durante el procesamiento podría ser {"status":"processing","stage":"applying","total_rows":1200,"processed_rows":450,"success_rows":438,"error_rows":12}. Para obtener errores, usa una ruta paginada como GET /api/imports/imp_8f2a/errors?limit=50&cursor=....
Si se permite reenviar únicamente las filas fallidas, POST /api/imports/imp_8f2a/retry-errors puede recibir claves de origen y datos corregidos. Debe rechazar las claves que ya consten como aplicadas o tratarlas con una política idempotente explícita, y devolver el identificador del nuevo intento. La ruta no debe ocultar que se crea un intento relacionado, en vez de borrar el historial anterior.
En PHP, el controlador registra la operación y responde sin procesar el archivo completo en la petición. Este fragmento es pseudocódigo de estilo PHP 7: no usa argumentos con nombre y setJsonBody() representa un adaptador propio, no un método estándar de PHP ni portable entre frameworks. En una aplicación real se debe sustituir por la respuesta de la implementación o framework utilizado:
$import = $imports->create(
    $user->id,
    $storedFile->key,
    'received'
);

$dispatcher->dispatch(new ProcessImport($import->id));

$response->setStatusCode(202);
$response->setJsonBody(array(
    'id' => $import->id,
    'status' => 'received',
    'status_url' => '/api/imports/' . $import->id
));

return $response;
El ejemplo muestra la separación entre aceptación y ejecución, pero no garantiza por sí solo que el trabajo quede registrado de forma durable. Coordina la persistencia de la operación y el envío del trabajo para que un fallo entre ambos pasos no deje una importación sin procesar. Según la infraestructura, puede utilizarse una transacción con patrón outbox u otro mecanismo fiable.
Pruebas y lista de comprobación
Prueba transiciones válidas e inválidas, archivos malformados, errores parciales, solicitudes duplicadas e interrupciones. Verifica que una operación terminal no publique avances posteriores, que los contadores sean coherentes y que la paginación de errores respete permisos. Incluye el caso en que una fila ya aplicada aparece en un reenvío: debe seguir habiendo un único registro y no repetirse ningún efecto secundario.
- ¿El usuario distingue recepción, procesamiento y resultado final?
- ¿Está definido si corrige y vuelve a cargar el archivo o reenvía solo filas fallidas?
- ¿Las claves estables evitan duplicar registros ya importados?
- ¿Los contadores reflejan trabajo confirmado y se actualizan con una frecuencia razonable?
- ¿La consulta de estado y la descarga de errores exigen permisos adecuados?
- ¿Reintentar, reanudar y cancelar tienen efectos definidos y comprobables?
- ¿Se han probado fallos parciales, concurrencia y conservación de datos?
Una importación observable no es solo una barra de progreso. Necesita estados comprensibles, resultados consultables y una política de corrección que no vuelva a aplicar registros confirmados. Separar ese contrato del mecanismo de ejecución permite evolucionar el procesamiento sin dejar al usuario sin información.