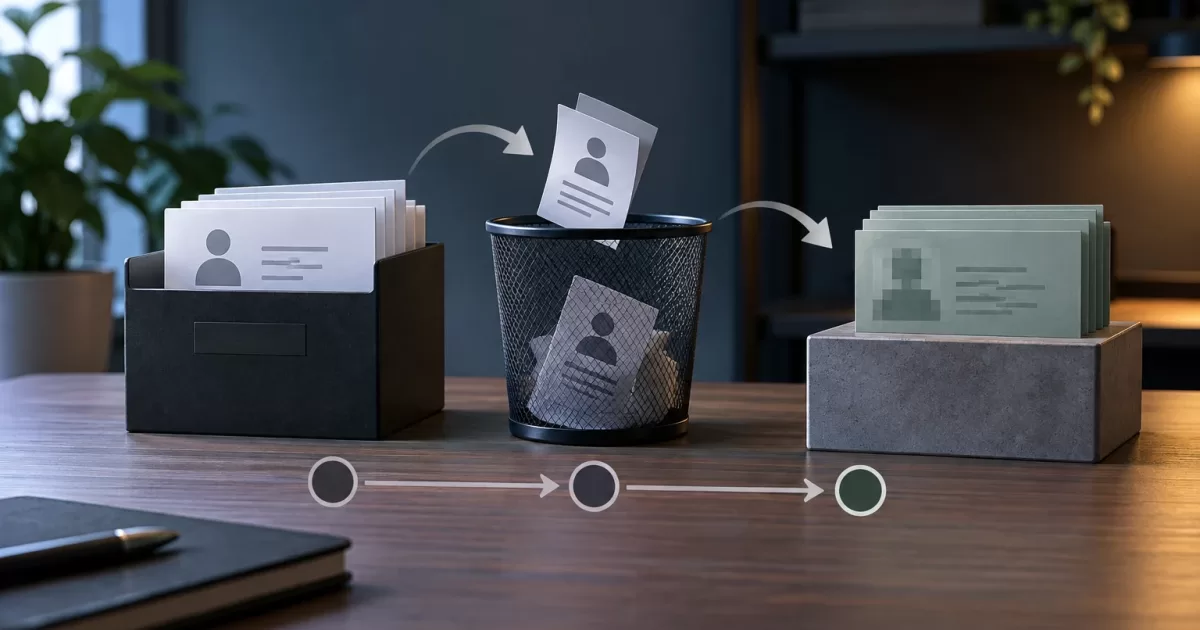
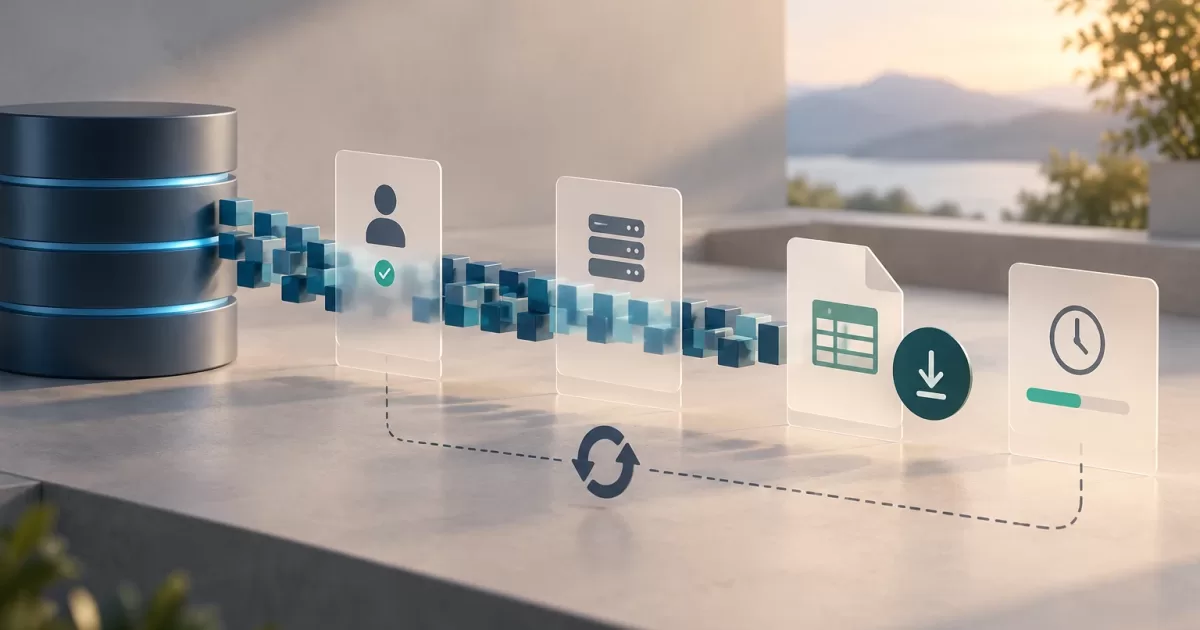
Żądania usunięcia danych nie da się zrealizować samym poleceniem DELETE na tabeli użytkowników. W aplikacji składającej się z wielu modułów informacje mogą znajdować się w powiązanych rekordach, plikach, indeksach wyszukiwania, kolejkach, eksportach lub usługach zewnętrznych. Usunięcie tylko widocznego konta może pozostawić dostępne kopie, a bezrefleksyjne kasowanie może objąć dane, które muszą zostać zachowane, aby inne procesy nadal działały.
Weryfikowalne usuwanie danych w PHP należy zaprojektować jako proces z jasno określonym zakresem, osobami odpowiedzialnymi, stanami, ponowieniami i kontrolami. Celem operacyjnym nie jest obietnica, że każda kopia zniknie natychmiast, lecz możliwość ustalenia, które miejsca docelowe zostały obsłużone, jaki był wynik dla każdego z nich i jakie ograniczenia nadal pozostają nierozwiązane.
Określ zakres przed rozpoczęciem
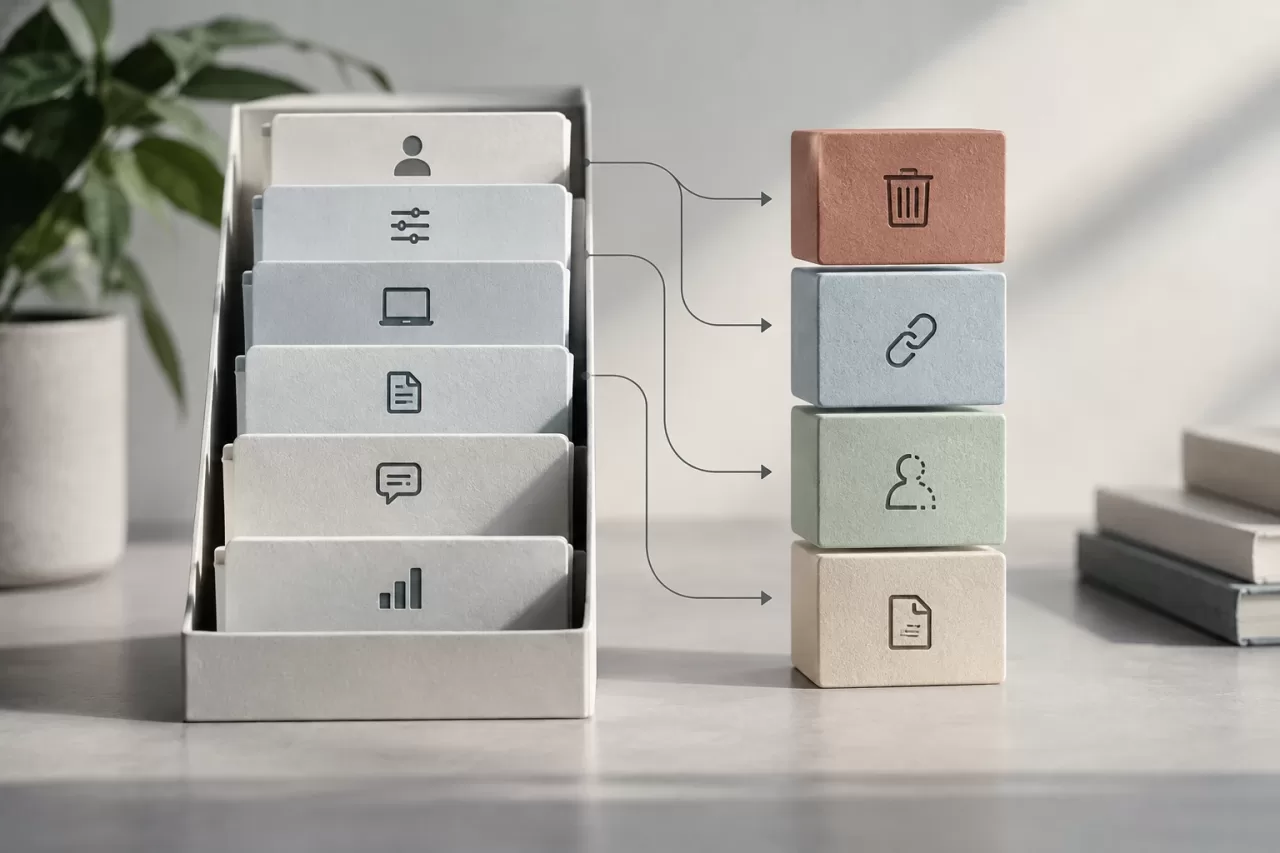
Przełóż żądanie na wykaz kategorii danych i systemów. Konto może na przykład obejmować profil, preferencje, sesje, dokumenty, komentarze i zdarzenia aktywności. Odwołania do konta mogą też występować na fakturach lub w innych współdzielonych rekordach. Dla każdej kategorii zdecyduj, czy należy ją usunąć, odłączyć, zanonimizować, czy zachować zgodnie z obowiązującą polityką wewnętrzną. Nie traktuj tych opcji jako równoważnych: anonimizacja wymaga, by w przewidzianym kontekście nie dało się zidentyfikować osoby, a odłączenie niekoniecznie usuwa oryginalne dane.
Określ także, co oznacza „ukończenie” dla każdego miejsca docelowego. Usunięcie wiersza z głównej bazy danych nie dowodzi, że zaktualizowano indeks wyszukiwania ani usunięto plik. Oddziel miejsca pod bezpośrednią kontrolą — bazę danych, magazyn obiektowy, cache — od tych zależnych od dostawcy lub okresu retencji, takich jak niektóre kopie zapasowe. Stan końcowy powinien odzwierciedlać te różnice, a nie ukrywać je pod jedną etykietą sukcesu.
Spisz kopie i przypisz osoby odpowiedzialne
Wykaz powinien odzwierciedlać rzeczywiste przepływy danych, a nie tylko schemat bazy danych. Sprawdź, gdzie dane są tworzone, eksportowane lub przekształcane: w kolejkach zadań, indeksach wyszukiwania, systemach analitycznych, plikach tymczasowych, logach aplikacji i połączonych narzędziach. Zapytaj każdy zespół, za pomocą jakiego identyfikatora można znaleźć rekordy i jaką operację obsługuje jego system.
Przypisz osobę odpowiedzialną technicznie za każde miejsce docelowe i udokumentuj mechanizm, oczekiwaną odpowiedź, ponowienia oraz ograniczenia. Jeśli system nie umożliwia wyszukiwania po stabilnym identyfikatorze, utrudnia to weryfikację i należy potraktować to jako dług projektowy. Unikaj przechowywania dodatkowej kopii danych osobowych w samym rejestrze żądania: zwykle wystarczą wewnętrzny identyfikator sprawy, niezbędny do wykonania operacji odnośnik oraz zminimalizowane wyniki.
Modeluj stany i wyniki dla każdego systemu
Solidny proces ma jawnie określone stany, na przykład: received, validated, in_progress, partially_completed, verification_pending, completed i failed. Uzgodnij przejścia między nimi oraz określ, kto może je inicjować. Nie oznaczaj żądania jako ukończonego, dopóki wszystkie obowiązkowe miejsca docelowe nie mają weryfikowalnego wyniku.
Rejestruj wynik osobno dla każdego systemu: oczekuje, usunięto, nie znaleziono, można ponowić, wymaga przeglądu lub podlega udokumentowanemu ograniczeniu. „Nie znaleziono” może być prawidłowym wynikiem, ale tylko wtedy, gdy zapytanie użyło właściwego klucza i objęło przewidziany zakres. Odróżniaj błąd przejściowy — na przykład niedostępność usługi — od trwałego odrzucenia wymagającego interwencji.
W PHP oddziel koordynację od pracy wykonywanej dla poszczególnych miejsc docelowych. Serwis aplikacyjny może wczytać sprawę, sprawdzić uprawnienia i zlecić zadania; niezależne adaptery implementują operacje dla bazy danych, magazynu lub API. Dzięki temu zmiana dostawcy nie wymaga mieszania logiki biznesowej ze szczegółami transportu. Zabezpiecz również tworzenie sprawy i dostęp do niej, a także rejestruj, kto zainicjował działania administracyjne.
Ustal kolejność usuwania z uwzględnieniem zależności
Przed usunięciem ustal, które relacje zależą od konta, a które są współdzielone. Klucze obce i reguły kaskadowego usuwania pomagają zachować spójność, ale kaskada może usunąć więcej, niż przewidziano, jeśli model łączy dane własne ze współdzielonymi. Sprawdź wpływ każdej relacji i wybieraj jawne operacje, gdy zakres nie jest oczywisty.
Typowa sekwencja obejmuje zablokowanie nowych zapisów powiązanych z daną osobą, unieważnienie sesji lub poświadczeń, usunięcie zależności wewnętrznych, skasowanie lub przekształcenie własnych rekordów, a następnie propagację operacji do indeksów i usług zewnętrznych. Konkretna kolejność zależy od architektury. Jeśli najpierw usuniesz klucz pozwalający znaleźć dane w innych systemach, zadanie może utracić informacje potrzebne do dalszego działania. Przechowuj ten identyfikator roboczy w sposób bezpieczny i tylko przez niezbędny czas, nie zamieniając rejestru operacyjnego w równoległy magazyn danych.
Zapewnij idempotentność i możliwość wznowienia procesu
Zadania rozproszone mogą zakończyć się błędem po wykonaniu operacji, ale przed przekazaniem informacji o tym. Dlatego każdy krok musi dać się powtórzyć bez wywoływania niepożądanych skutków. Idempotentna operacja usunięcia może zaakceptować sytuację, w której rekord już nie istnieje, i zwrócić kontrolowany wynik zamiast zawsze traktować ją jako błąd.
Zapisuj postęp osobno dla każdego miejsca docelowego i używaj klucza idempotencji lub stabilnego identyfikatora sprawy, jeśli system zdalny to obsługuje. Przetwarzaj każde miejsce docelowe w odpowiedniej transakcji lub jednostce pracy, nie utrzymując otwartej transakcji bazy danych podczas oczekiwania na odpowiedź API. W razie błędu ponawiaj próby z limitami i strategią opóźnień; błędy, których nie udało się rozwiązać po wyczerpaniu ponowień, powinny trafiać do kolejki do przeglądu, a nie znikać w logu.
Wznawianie powinno kontynuować proces od nieukończonych kroków. Nie uruchamiaj całego procesu od początku, jeśli mogłoby to powtórzyć niebezpieczne działania lub nadpisać wcześniejsze wyniki. Rozróżniaj zwłaszcza „żądanie wysłano” i „usunięcie potwierdzono”: pomyślna odpowiedź HTTP może potwierdzać odbiór, ale niekoniecznie ukończenie zadania po stronie zdalnej. Uzgodnij z dostawcą znaczenie każdego potwierdzenia.
Weryfikuj, nie zachowując usuwanych danych
Weryfikacja powinna odpowiadać miejscu docelowemu i rodzajowi operacji. W bazie danych zapytanie o przewidziane klucze może potwierdzić, że w zakresie nie pozostały żadne wiersze. W magazynie można sprawdzić, czy obiekt jest nieobecny, lub zweryfikować odpowiedź mechanizmu usuwania. W indeksie należy wyszukać dokument za pomocą odpowiedniego klucza i uwzględnić czas propagacji zmian. Komunikat o sukcesie od pracownika nie zastępuje tych kontroli.
Rejestruj tylko minimalny zestaw dowodów: identyfikator sprawy, miejsce docelowe, operację, znacznik czasu, stan, liczbę zmienionych elementów — jeśli można ją bezpiecznie zapisać — oraz techniczne odniesienie do wyniku. Nie kopiuj usuniętej zawartości, poświadczeń, tokenów ani zbędnych identyfikatorów osobowych do logów i metryk. Zabezpiecz rejestr audytowy, ogranicz dostęp do niego i określ jego wewnętrzny okres retencji. Dowody powinny umożliwiać wyjaśnienie przebiegu procesu bez odtwarzania informacji, które próbowano usunąć.
Uwzględnij ograniczenia i przetestuj proces
Kopie zapasowe wymagają jawnego podejścia. Mogą nie obsługiwać natychmiastowego selektywnego usuwania; udokumentuj przewidziany cykl retencji i sposób zapobiegania ponownemu wprowadzeniu usuniętych danych po odtworzeniu kopii. Na przykład procedura odzyskiwania może ponownie zastosować oczekujące lub ukończone żądania przed udostępnieniem odtworzonego systemu. Nie twierdź, że kopia została usunięta, jeśli dostępny mechanizm pozwala jedynie na jej wygaśnięcie zgodnie z okresem retencji.
W przypadku systemów zewnętrznych wskaż, kto może zainicjować operację, jakie potwierdzenie oferuje dostawca i kiedy należy eskalować niepewny wynik. Ograniczenie operacyjne nie jest równoznaczne z pomyślną weryfikacją: zależnie od dostępnych dowodów należy oznaczyć je jako oczekujące, ograniczone lub rozwiązane.
Przed rozpoczęciem korzystania z procesu przetestuj go w środowiskach nieprodukcyjnych na danych syntetycznych: dla zduplikowanych żądań, współdzielonych relacji, brakujących plików, przekroczeń limitu czasu, niejednoznacznych odpowiedzi i awarii po wykonaniu kroku. Sprawdź, czy ponowienia nie powielają skutków, uprawnienia blokują niedozwolony dostęp, a raporty nie ujawniają danych. W środowisku produkcyjnym monitoruj liczbę błędów, wiek nierozwiązanych spraw i miejsca docelowe bez potwierdzenia, nie umieszczając danych osobowych w alertach.
Lista kontrolna: określono zakres i wyjątki; zinwentaryzowano miejsca docelowe i osoby odpowiedzialne; udokumentowano stany i przejścia; sprawdzono zależności; kroki są idempotentne i można je wznowić; weryfikacja jest dostosowana do każdego systemu; dowody są zminimalizowane i chronione; poinformowano o ograniczeniach dotyczących kopii i dostawców; przetestowano awarie; dostępna jest procedura przeglądu i eskalacji. Dzięki tym kontrolom zespół może działać w sposób możliwy do prześledzenia i dokładnie ustalić, na którym etapie zatrzymało się usuwanie, zamiast mylić rozpoczętą operację z potwierdzonym wynikiem.