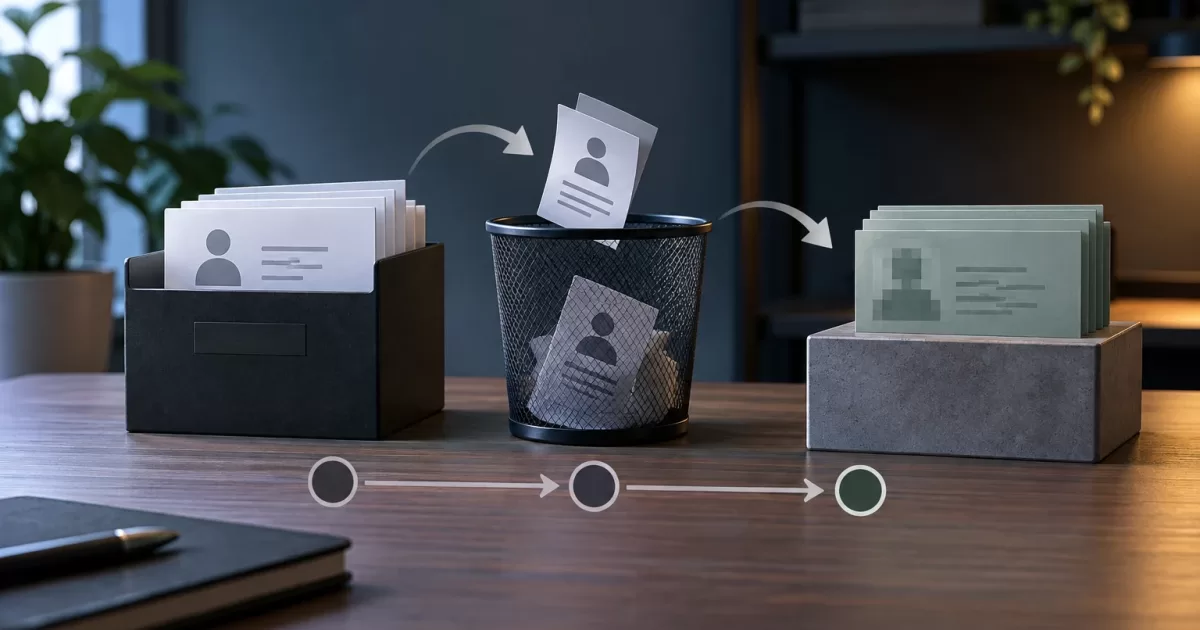
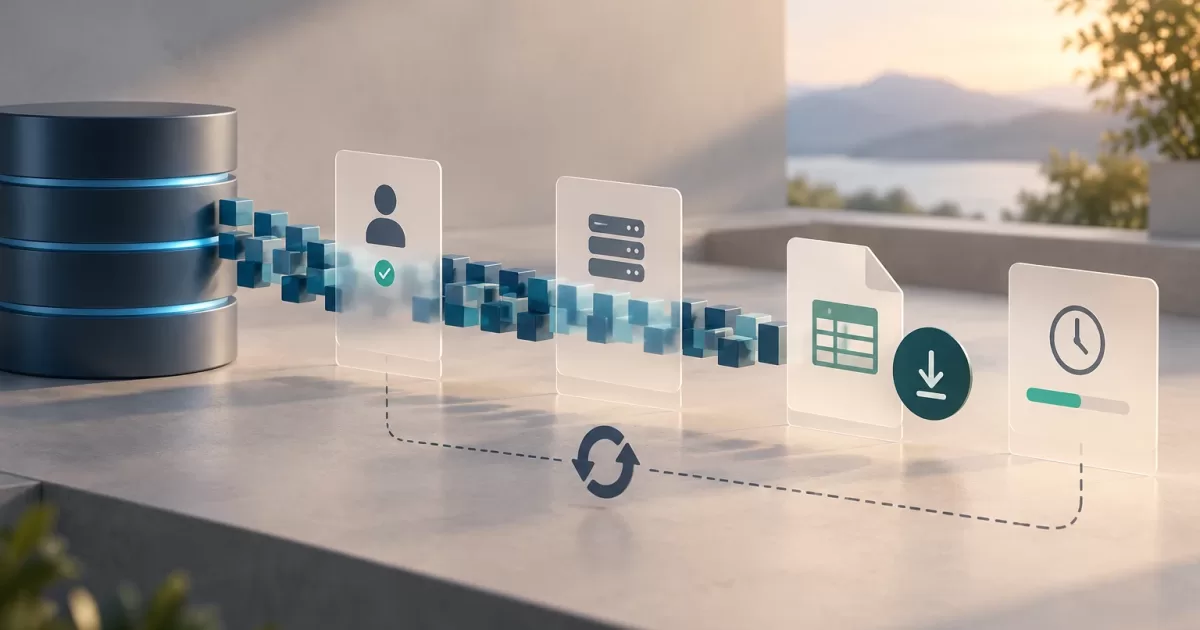
Une demande de suppression ne se résout pas par un DELETE sur la table des utilisateurs. Dans une application composée de plusieurs modules, les informations peuvent apparaître dans des enregistrements associés, des fichiers, des index de recherche, des files d’attente, des exports ou des services externes. Supprimer uniquement le compte visible peut laisser des copies accessibles ; supprimer à l’aveugle peut affecter des données qui doivent être conservées pour que d’autres processus continuent de fonctionner.
La suppression vérifiable des données en PHP se conçoit comme un processus doté d’un périmètre explicite, de responsables, d’états, de nouvelles tentatives et de vérifications. L’objectif opérationnel n’est pas de promettre que toute copie disparaîtra immédiatement : il s’agit de pouvoir identifier les destinations traitées, le résultat obtenu pour chacune et les limites qui restent en suspens.
Définir le périmètre avant l’exécution
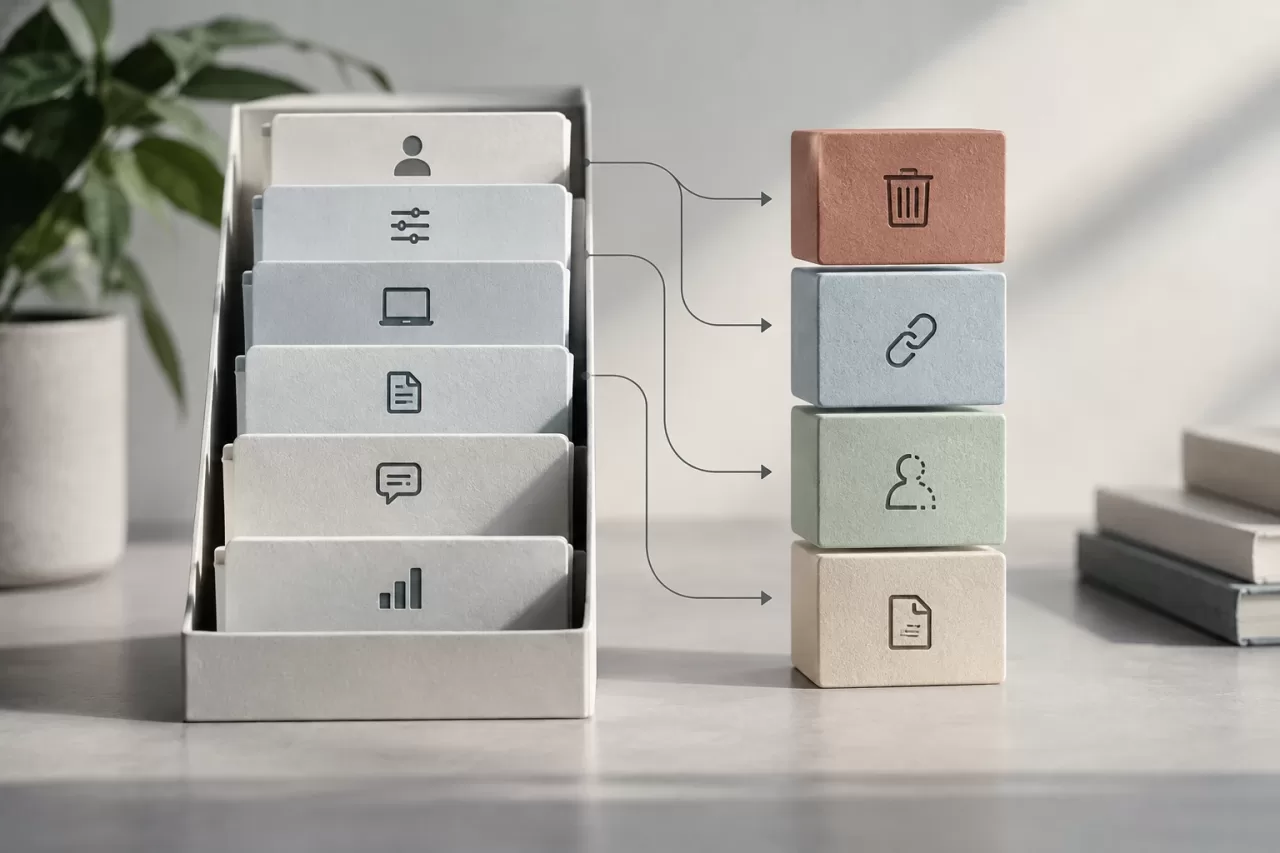
Traduisez la demande en un inventaire des catégories de données et des systèmes concernés. Par exemple, un compte peut avoir un profil, des préférences, des sessions, des documents, des commentaires et des événements d’activité. Il peut également exister des références dans des factures ou d’autres enregistrements partagés. Pour chaque catégorie, décidez s’il convient de la supprimer, de la dissocier, de l’anonymiser ou de la conserver dans le cadre d’une politique interne applicable. Ne traitez pas ces options comme équivalentes : l’anonymisation exige que la personne ne soit plus identifiable dans le contexte prévu, et la dissociation ne supprime pas nécessairement les données d’origine.
Définissez également ce que signifie « terminé » pour chaque destination. Le retrait d’une ligne de la base de données principale ne prouve pas que l’index de recherche a été mis à jour ni qu’un fichier a été supprimé. Distinguez les destinations sous contrôle direct — base de données, stockage d’objets, cache — de celles qui dépendent d’un fournisseur ou d’une période de rétention, comme certaines sauvegardes. L’état final doit refléter ces différences, et non les masquer sous une étiquette de réussite unique.
Inventorier les copies et désigner les responsables
L’inventaire doit suivre les flux réels de données, et pas seulement le schéma de la base de données. Examinez où les données sont créées, exportées ou transformées : files d’attente de tâches, index de recherche, systèmes d’analyse, fichiers temporaires, journaux d’application et outils connectés. Demandez à chaque équipe quel identifiant permet de localiser les enregistrements et quelle opération son système prend en charge.
Désignez un responsable technique pour chaque destination et documentez le mécanisme, la réponse attendue, les nouvelles tentatives et les limites. Si un système ne permet pas d’effectuer une recherche à l’aide d’un identifiant stable, cette lacune complique la vérification et doit être traitée comme une dette de conception. Évitez de conserver une copie supplémentaire des données personnelles dans le registre de la demande lui-même : un identifiant interne du dossier, la référence nécessaire à l’opération et des résultats minimisés suffisent généralement.
Modéliser les états et les résultats par système
Un processus robuste comporte des états explicites, par exemple : received, validated, in_progress, partially_completed, verification_pending, completed et failed. Convenez des transitions et des personnes autorisées à les déclencher. Une demande ne devrait pas être marquée comme terminée tant que des destinations obligatoires n’ont pas de résultat vérifiable.
Consignez séparément le résultat de chaque système : en attente, supprimé, introuvable, pouvant faire l’objet d’une nouvelle tentative, nécessitant une révision ou soumis à une limite documentée. « Introuvable » peut être un résultat valide, mais uniquement si la requête a utilisé la bonne clé et couvert le périmètre prévu. Distinguez une défaillance temporaire — par exemple, un service indisponible — d’un refus définitif nécessitant une intervention.
En PHP, séparez la coordination du travail propre à chaque destination. Un service applicatif peut charger le dossier, vérifier les autorisations et distribuer les tâches ; des adaptateurs indépendants mettent en œuvre les opérations pour la base de données, le stockage ou les API. Ainsi, une modification chez un fournisseur n’oblige pas à mêler la logique métier aux détails de transport. Protégez également la création et la consultation du dossier par des contrôles d’accès, et consignez l’identité des personnes ayant lancé des actions administratives.
Ordonner la suppression en respectant les dépendances
Avant la suppression, déterminez quelles relations dépendent du compte et lesquelles sont partagées. Les clés étrangères et les règles de suppression en cascade contribuent au maintien de l’intégrité, mais une cascade peut supprimer plus de données que prévu si le modèle mélange données propres et données partagées. Examinez l’impact de chaque relation et privilégiez les opérations explicites lorsque le périmètre n’est pas évident.
Une séquence courante consiste à arrêter les nouvelles écritures associées au sujet, à invalider les sessions ou les identifiants d’accès, à supprimer les dépendances internes, à effacer ou transformer les enregistrements propres au sujet, puis à propager l’opération aux index et aux services externes. L’ordre précis dépend de l’architecture. Si vous supprimez d’abord la clé permettant de localiser les données dans d’autres systèmes, la tâche risque de perdre les informations nécessaires à sa poursuite. Conservez cette référence de travail de manière sécurisée et pendant la durée nécessaire uniquement, sans transformer le registre opérationnel en entrepôt parallèle.
Rendre le processus idempotent et reprenable
Les tâches distribuées peuvent échouer après avoir terminé une opération, mais avant de l’avoir signalé. Chaque étape doit donc pouvoir être répétée sans entraîner d’effets indésirables. Une suppression idempotente peut accepter qu’un enregistrement n’existe déjà plus et renvoyer un résultat contrôlé, plutôt que de toujours traiter ce cas comme une erreur.
Enregistrez l’avancement pour chaque destination et utilisez une clé d’idempotence ou un identifiant stable du dossier lorsque le système distant le permet. Traitez chaque destination dans une transaction ou une unité de travail adaptée, sans garder une transaction de base de données ouverte pendant l’attente d’une API. En cas d’échec, effectuez de nouvelles tentatives avec des limites et une stratégie d’attente ; les erreurs persistantes doivent être transmises à une file de révision, et non disparaître dans un journal.
La reprise doit continuer à partir des étapes incomplètes. Ne redémarrez pas tout le processus si cela risque de répéter des actions non sécurisées ou d’écraser des résultats précédents. Distinguez notamment « demande envoyée » et « suppression confirmée » : une réponse HTTP réussie peut confirmer la réception, mais pas nécessairement l’achèvement du travail distant. Définissez avec le fournisseur la signification de chaque accusé de réception.
Vérifier sans conserver ce qui est supprimé
La vérification doit correspondre à la destination et au type d’opération. Dans la base de données, une requête portant sur les clés prévues peut confirmer qu’il ne reste plus de lignes dans le périmètre. Pour le stockage, il est possible de vérifier l’absence de l’objet ou la réponse du mécanisme de suppression. Dans un index, il faut rechercher le document à l’aide d’une clé adaptée et tenir compte du délai de propagation. Un message de réussite du processus de traitement ne remplace pas ces vérifications.
Consignez des preuves minimales : identifiant du dossier, destination, opération, horodatage, état, nombre d’éléments concernés lorsque cela ne présente pas de risque, et référence technique du résultat. Évitez de copier le contenu supprimé, des identifiants d’accès, des jetons ou des identifiants personnels inutiles dans les journaux et les métriques. Protégez le journal d’audit, limitez son accès et définissez sa durée de conservation interne. Les preuves doivent permettre d’expliquer le processus sans reconstituer les informations que l’on a tenté de supprimer.
Gérer les limites et tester le processus
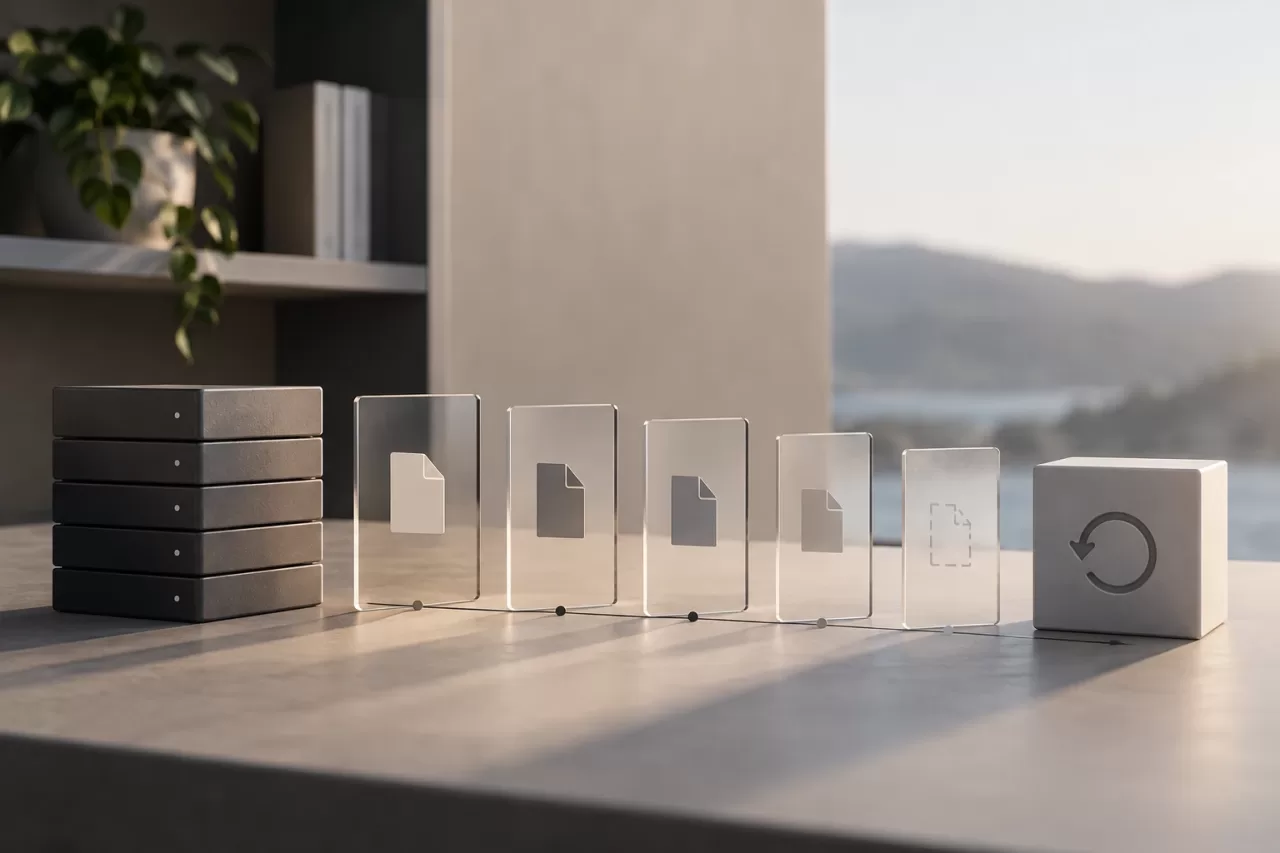
Les sauvegardes nécessitent un traitement explicite. Elles ne permettent pas toujours une suppression sélective immédiate ; documentez le cycle de rétention prévu et la manière d’éviter qu’une restauration réintroduise des données déjà supprimées. Par exemple, la procédure de récupération peut réappliquer les demandes en attente ou terminées avant la remise en service du système restauré. N’affirmez pas qu’une sauvegarde a été supprimée si le mécanisme disponible permet uniquement son expiration conformément à la durée de rétention.
Pour les systèmes externes, indiquez qui peut lancer l’opération, quelle confirmation le fournisseur fournit et à quel moment un résultat incertain doit être remonté. Une limite opérationnelle ne vaut pas vérification concluante : elle doit être présentée comme en attente, soumise à restriction ou résolue selon les éléments disponibles.
Avant l’exploitation du processus, testez-le dans des environnements hors production avec des données synthétiques : demandes en double, relations partagées, fichiers absents, délais d’attente dépassés, réponses ambiguës et défaillances après l’achèvement d’une étape. Vérifiez que les nouvelles tentatives ne dupliquent pas les effets, que les autorisations bloquent les accès indus et que les rapports n’exposent pas de données. En production, surveillez le volume de défaillances, l’ancienneté des dossiers en attente et les destinations sans confirmation, sans inclure d’informations personnelles dans les alertes.
Liste de vérification : périmètre et exceptions définis ; destinations et responsables répertoriés ; états et transitions documentés ; dépendances examinées ; étapes idempotentes et reprenables ; vérification propre à chaque système ; preuves minimisées et protégées ; limites des sauvegardes et des fournisseurs communiquées ; tests de défaillance effectués ; procédure de révision et d’escalade disponible. Grâce à ces contrôles, l’équipe peut répondre avec traçabilité et déterminer précisément où une suppression s’est arrêtée, au lieu de confondre une action lancée avec un résultat confirmé.