Une exportation de données semble simple tant que le résultat tient en mémoire et peut être généré en quelques secondes. Lorsque le volume, la sensibilité des données ou le nombre de requêtes simultanées augmente, envoyer directement la réponse peut épuiser les ressources, dépasser les limites d’exécution et laisser l’utilisateur sans savoir ce qui s’est passé. Concevoir une exportation de données en PHP implique de décider comment la produire, la protéger et communiquer son état, et pas seulement comment écrire un CSV.
Quand ne plus générer l’exportation dans la requête
L’exportation synchrone peut convenir à des ensembles de petite taille, délimités et rapidement traités. L’application valide la requête, interroge les données et renvoie le fichier dans la même réponse. Cette approche est facile à comprendre et évite de gérer des tâches et des fichiers après coup, mais elle lie le temps de réponse au coût de l’interrogation et de la sérialisation de tous les enregistrements.
Il est conseillé de passer à un processus asynchrone lorsque la durée est variable ou longue, que le volume peut augmenter, que les limites de temps ou de mémoire sont importantes, ou que les exportations simultanées entrent en concurrence avec les requêtes interactives. C’est également préférable lorsque l’utilisateur doit pouvoir lancer le travail et revenir plus tard. Il n’existe pas de seuil universel : mesurez la durée, la mémoire maximale, le volume produit et l’impact en cas de concurrence dans l’environnement réel.
Le mode synchrone reste raisonnable s’il est possible d’imposer une limite claire et si le temps de réponse est acceptable. Une autre option consiste à proposer les deux modes : téléchargement immédiat pour les petits ensembles et création en arrière-plan pour les requêtes volumineuses. Les limites doivent être explicites et communiquées avant le lancement du travail, et non apparaître à la fin sous la forme d’une erreur inattendue.
Choisir le format et le mode de livraison selon l’usage
Le format dépend du consommateur. Le CSV est souvent pratique pour les tableurs et les intégrations simples ; le JSON peut convenir aux consommateurs qui ont besoin de structures imbriquées. S’il faut plusieurs fichiers, types de données ou métadonnées, il peut être approprié de les regrouper dans une archive. Tenez compte de la taille, de la compatibilité, de l’encodage et des règles de représentation, notamment les séparateurs, les dates, les fuseaux horaires et les valeurs nulles.
Définissez le contrat de l’exportation : les colonnes et leur ordre, les filtres appliqués, le format des dates, le traitement des caractères et la signification des valeurs vides. Si le fichier est destiné à être ouvert dans un tableur, évaluez également le risque que des valeurs contrôlées par les utilisateurs soient interprétées comme des formules. La mesure d’atténuation dépend du format et du consommateur ; ne modifiez pas silencieusement les données sans documenter le comportement.
Pour un téléchargement direct, PHP peut transmettre le contenu progressivement si la requête et le format le permettent. Pour les travaux volumineux, il est généralement plus facile à contrôler de générer un fichier temporaire et de le proposer une fois qu’il est complet. Séparer la génération du téléchargement permet d’afficher la progression et évite de fournir une réponse interrompue en cours de route, mais nécessite du stockage, une expiration et une gestion des autorisations.
Concevoir un flux asynchrone observable
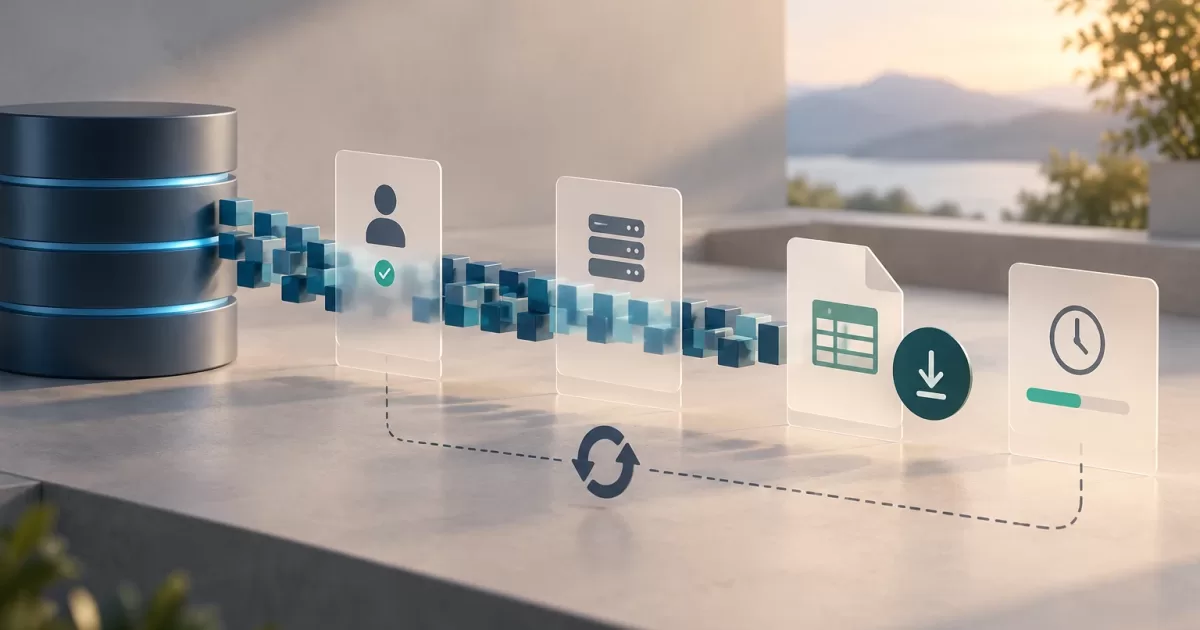
Un flux courant comprend les étapes suivantes :
- Requête : valider les filtres, le format et le périmètre ; créer un identifiant de tâche et enregistrer l’identité de la personne qui l’a demandée.
- Autorisation : vérifier que cette personne peut exporter l’ensemble demandé, y compris avec ses filtres et ses champs sensibles.
- Génération : exécuter le travail en arrière-plan, consigner les erreurs et écrire dans un emplacement non public.
- Disponibilité : marquer le fichier comme prêt uniquement après avoir terminé et vérifié l’écriture.
- Téléchargement et expiration : vérifier à nouveau les droits d’accès, fournir le fichier et le supprimer conformément à la politique définie.
Les états doivent être compréhensibles et consultables : en attente, en cours, prêt, en échec et expiré, par exemple. Incluez des messages permettant d’agir sans révéler de détails internes. Si cela est utile, consignez la progression au moyen du nombre de lots traités, plutôt qu’avec des pourcentages faussement précis. L’interface doit distinguer un travail encore en cours d’un travail qui a échoué et permettre de demander une nouvelle génération conformément à la politique du produit.
L’identité et le périmètre autorisés doivent être associés au travail. Ne considérez pas un identifiant difficile à deviner comme une autorisation. Lors de la consultation de l’état ou du téléchargement, vérifiez que la personne a bien accès au travail et que ses autorisations sont toujours valides. Définissez également ce qui se passe si les autorisations changent pendant la génération du fichier : pour des données sensibles, il peut être nécessaire de les vérifier à nouveau avant le téléchargement ou d’annuler les travaux dont l’autorisation a été révoquée.
Traiter les données par lots sans épuiser la mémoire
Évitez de charger tout le résultat dans un tableau avant de le sérialiser. Interrogez les enregistrements par lots ordonnés et écrivez chaque lot dans un flux, en libérant les références avant de poursuivre. En PHP, la pagination ou les itérateurs peuvent être utiles, mais leur comportement dépend du moteur et du pilote : une requête apparemment itérative peut tout de même stocker les résultats côté client. Vérifiez la consommation mémoire avec le volume attendu.
La pagination par décalage peut devenir coûteuse sur de grands ensembles. Lorsque c’est approprié, utilisez une pagination par clé, avec un ordre stable et une colonne de continuation non ambiguë. Définissez ce qui se passe si les données changent pendant l’exportation : une vue cohérente peut nécessiter une transaction ou une stratégie spécifique, dont les coûts en matière de verrouillage et de durée doivent être évalués. Si une vue susceptible de changer est acceptable, documentez cette sémantique.
Écrivez dans un fichier temporaire portant un nom imprévisible et doté d’autorisations restrictives, en dehors de la racine publique. Vérifiez les erreurs d’ouverture, d’écriture et de fermeture, ainsi que l’espace disponible. Une erreur d’écriture ne doit pas rendre un fichier partiel téléchargeable. Vous pouvez commencer par générer le fichier sous un nom temporaire et le marquer comme définitif au moyen d’une opération sûre une fois l’écriture terminée, dans les limites des garanties offertes par le stockage choisi.
Protéger le téléchargement, l’expiration et la reprise
Le téléchargement doit passer par une route authentifiée qui vérifie l’état, l’autorisation et l’expiration. Évitez de construire des chemins de fichiers à partir de paramètres fournis par l’utilisateur ; résolvez l’identifiant du travail au moyen de métadonnées contrôlées par le serveur. Si vous utilisez un stockage d’objets, gérez les accès temporaires de manière restrictive et veillez à ce que l’URL ne se substitue pas aux vérifications d’autorisation du flux.
Définissez une politique de conservation adaptée à la sensibilité, à la taille et aux besoins de l’utilisateur. Un processus de nettoyage doit supprimer les fichiers expirés ainsi que les fichiers temporaires orphelins, et mettre à jour l’état associé. Consignez l’identité des personnes ayant demandé et téléchargé une exportation lorsque la traçabilité est pertinente, sans enregistrer dans les journaux les données exportées ni les secrets.
En cas d’échec, consignez la cause opérationnelle et laissez le travail dans un état cohérent. Les nouvelles tentatives peuvent entraîner des coûts supplémentaires ou produire des fichiers en double ; utilisez des identifiants de travail et des règles d’idempotence pour décider s’il est possible de reprendre une génération de manière sûre ou s’il faut en lancer une autre. N’ajoutez pas aveuglément des données à un fichier partiel : supprimez-le ou isolez-le, et ne publiez qu’un résultat complet. Limitez le nombre de tentatives et définissez comment récupérer les travaux abandonnés.
Reprendre à partir d’un point de contrôle nécessite davantage que de relancer le travail. Enregistrez de manière durable le dernier lot confirmé et une clé de continuation stable — par exemple, la dernière clé traitée dans un ordre déterministe — avec les filtres et l’identité du travail. Au redémarrage, validez que ces paramètres n’ont pas changé et poursuivez à partir de la clé suivante. Pour éviter de publier un résultat incohérent, écrivez les lots confirmés dans des parties temporaires identifiées par le travail et assemblez le fichier final uniquement lorsqu’elles sont toutes complètes. Si le format ou le stockage ne permet pas de confirmer et de vérifier ces parties de manière sûre, ou si vous ne pouvez pas garantir une vue cohérente des données, supprimez le fichier partiel et régénérez-le depuis le début. Une régénération contrôlée est généralement plus simple et plus sûre qu’une reprise incorrecte.
Tests et liste de contrôle pour la production
Testez à la fois le contenu et le cycle de vie. Vérifiez que les filtres, les autorisations et les champs exportés sont corrects ; qu’un utilisateur ne peut ni consulter ni télécharger les travaux d’une autre personne ; et que l’expiration empêche l’accès. Incluez des ensembles vides, des caractères spéciaux, des valeurs volumineuses et des enregistrements contenant des données sensibles. Vérifiez le format avec le consommateur réel lorsque c’est possible.
Simulez des erreurs de base de données, un disque plein, une interruption pendant l’écriture, la perte du processus et des requêtes répétées. Confirmez qu’aucun fichier incomplet n’est publié, que les nouvelles tentatives ne dupliquent pas inutilement le travail et que le nettoyage supprime les fichiers résiduels. Si des points de contrôle sont mis en œuvre, testez le redémarrage à chaque limite de lot, la détection de paramètres incompatibles et l’assemblage final. Mesurez la mémoire, la durée et la charge avec une concurrence représentative ; surveillez également la file des travaux, le stockage en attente et l’ancienneté des exportations actives.
- Définissez des limites de taille, de durée et de concurrence.
- Autorisez les filtres, les champs, la consultation de l’état et le téléchargement.
- Traitez et écrivez les données par lots ; mesurez la mémoire réellement utilisée.
- Ne publiez que des fichiers complets et protégez leur emplacement.
- Communiquez les états, les erreurs récupérables et l’expiration.
- Prévoyez des nouvelles tentatives idempotentes et un nettoyage automatique.
- N’utilisez des points de contrôle que si vous pouvez confirmer les lots et poursuivre avec des paramètres et des données cohérents.
- Testez les autorisations, les échecs partiels, la cohérence et la charge.
La décision principale ne consiste pas simplement à choisir entre le mode synchrone et le mode asynchrone : il s’agit de déterminer quelles garanties le produit peut offrir en matière d’attente, de cohérence, de confidentialité et de reprise. En explicitant ces garanties, vous pouvez choisir une implémentation PHP adaptée au volume actuel, avec des limites et des indicateurs permettant de la faire évoluer avant qu’une exportation ne dégrade le reste de l’application.