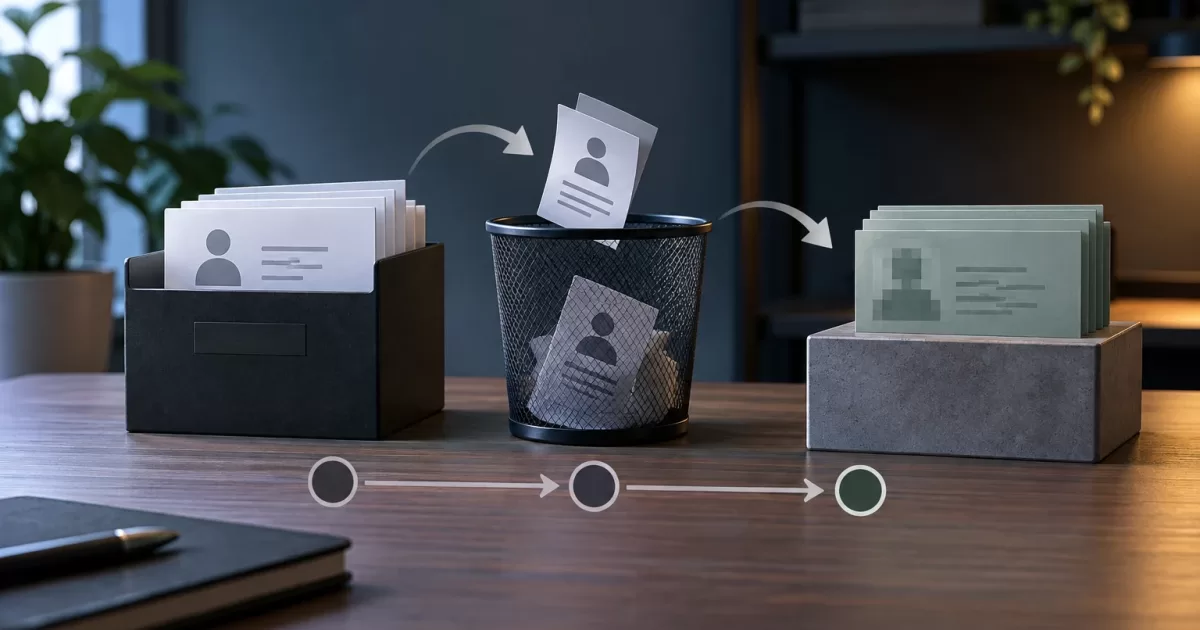
Una solicitud de eliminación no se resuelve con un DELETE sobre la tabla de usuarios. En una aplicación con varios módulos, la información puede aparecer en registros relacionados, archivos, índices de búsqueda, colas, exportaciones o servicios externos. Borrar solo la cuenta visible puede dejar copias accesibles; borrar a ciegas puede afectar datos que deben conservarse para que otros procesos sigan funcionando.
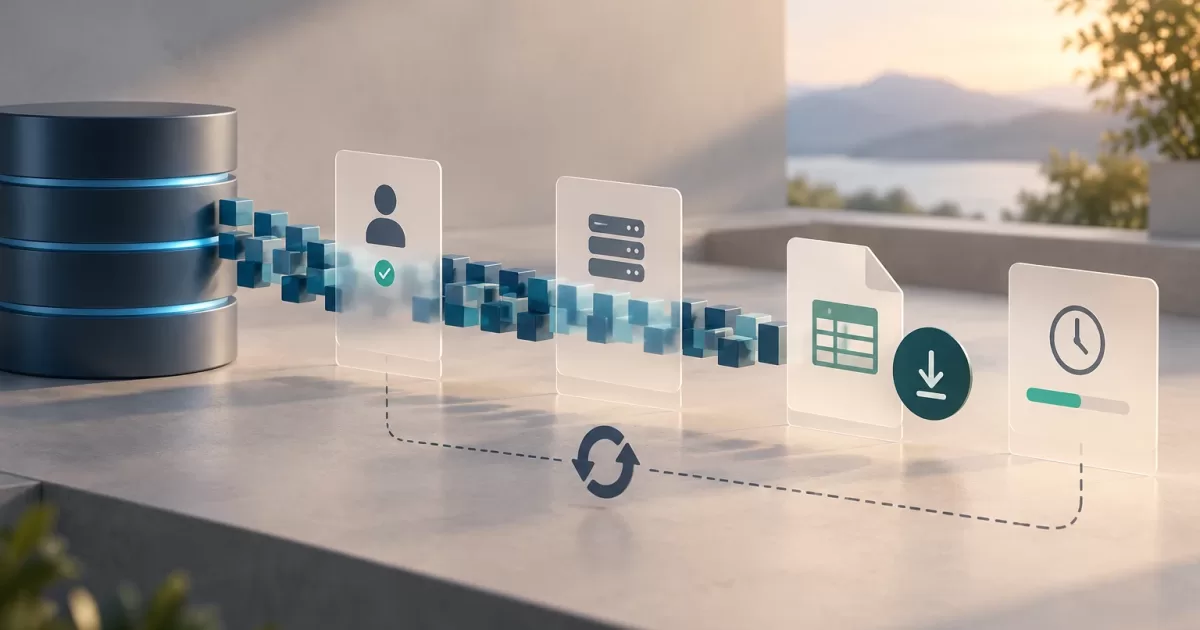
La eliminación verificable de datos en PHP se diseña como un proceso con alcance explícito, responsables, estados, reintentos y comprobaciones. El objetivo operativo no es prometer que cualquier copia desaparece de inmediato: es poder identificar qué destinos se procesaron, qué resultado obtuvo cada uno y qué límites permanecen pendientes.
Definir el alcance antes de ejecutar
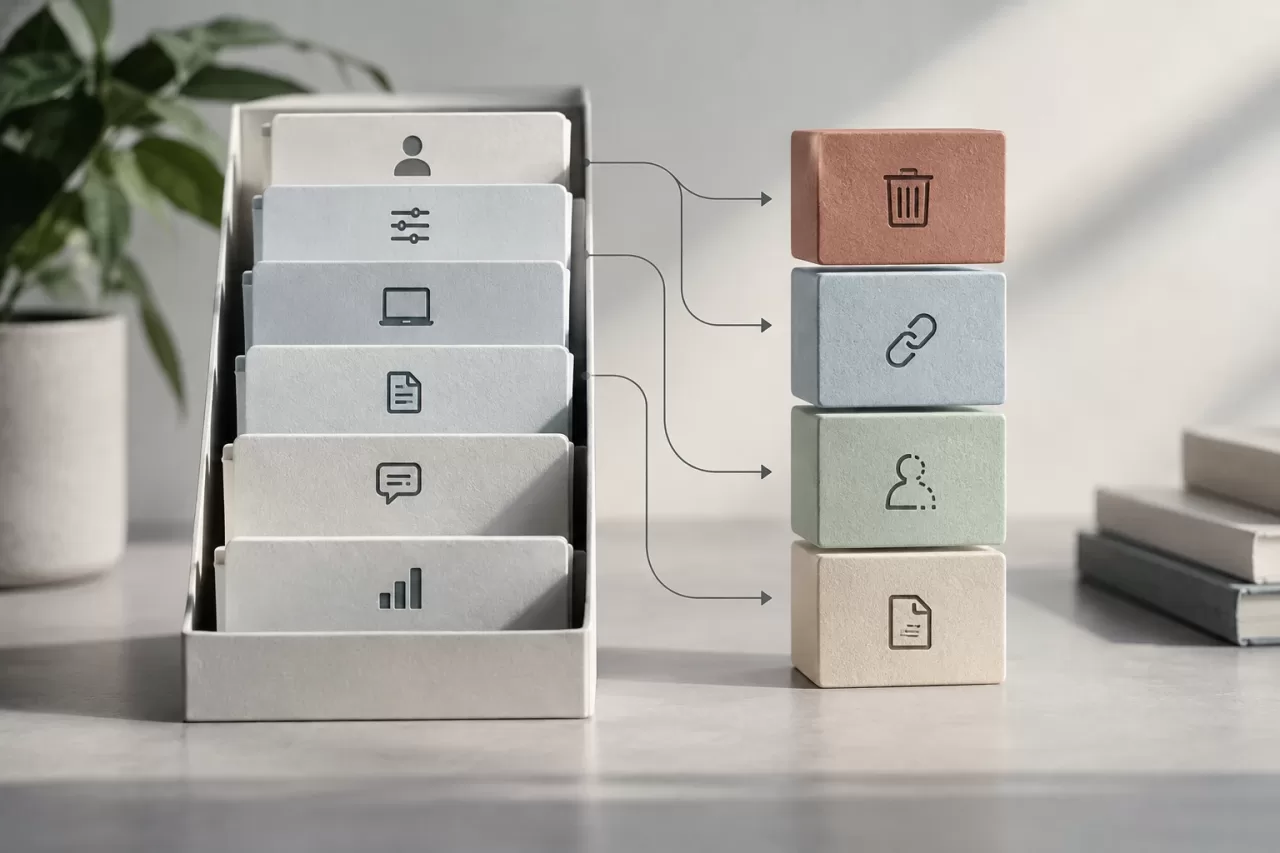
Traducid la solicitud a un inventario de categorías de datos y sistemas. Por ejemplo, una cuenta puede tener perfil, preferencias, sesiones, documentos, comentarios y eventos de actividad. También puede haber referencias en facturas u otros registros compartidos. Para cada categoría, decidid si corresponde eliminarla, desvincularla, anonimizarla o conservarla bajo una política interna aplicable. No tratéis estas opciones como equivalentes: anonimizar requiere que la persona deje de ser identificable en el contexto previsto, y desvincular no elimina necesariamente los datos originales.
Definid también qué significa «completado» para cada destino. Una fila retirada de la base de datos principal no demuestra que se haya actualizado el índice de búsqueda ni que se haya eliminado un archivo. Separad los destinos bajo control directo —base de datos, almacenamiento de objetos, caché— de los que dependen de un proveedor o de una ventana de retención, como ciertas copias de seguridad. El estado final debe reflejar esas diferencias, no ocultarlas bajo una única etiqueta de éxito.
Inventariar las copias y asignar responsables
El inventario debe seguir los flujos reales de datos, no solo el esquema de la base de datos. Revisad dónde se crean, exportan o transforman los datos: colas de trabajos, índices de búsqueda, sistemas de analítica, archivos temporales, registros de aplicación y herramientas conectadas. Preguntad a cada equipo qué identificador permite localizar los registros y qué operación admite su sistema.
Asignad un responsable técnico por destino y documentad el mecanismo, la respuesta esperada, los reintentos y las limitaciones. Si un sistema no permite buscar por un identificador estable, esa carencia dificulta la verificación y debe tratarse como una deuda de diseño. Evitad guardar una copia adicional de los datos personales en el propio registro de la solicitud: suele bastar con un identificador interno del caso, la referencia necesaria para operar y resultados minimizados.
Modelar estados y resultados por sistema
Un proceso robusto tiene estados explícitos, por ejemplo: received, validated, in_progress, partially_completed, verification_pending, completed y failed. Acordad las transiciones y quién puede iniciarlas. Una solicitud no debería marcarse como completada mientras haya destinos obligatorios sin resultado verificable.
Registrad el resultado de cada sistema por separado: pendiente, eliminado, no encontrado, reintentable, requiere revisión o sujeto a una limitación documentada. «No encontrado» puede ser un resultado válido, pero solo si la consulta utilizó la clave correcta y cubrió el ámbito previsto. Diferenciad un fallo transitorio —por ejemplo, un servicio no disponible— de un rechazo permanente que exige intervención.
En PHP, separad la coordinación del trabajo específico de cada destino. Un servicio de aplicación puede cargar el caso, comprobar permisos y despachar tareas; adaptadores independientes implementan operaciones para la base de datos, el almacenamiento o las APIs. Así, un cambio en un proveedor no obliga a mezclar lógica de negocio con detalles de transporte. Proteged además la creación y consulta del caso con controles de acceso y registrad quién inició acciones administrativas.
Ordenar el borrado respetando dependencias
Antes de eliminar, determinad qué relaciones dependen de la cuenta y cuáles son compartidas. Las claves foráneas y las reglas de borrado en cascada ayudan a mantener integridad, pero una cascada puede borrar más de lo previsto si el modelo mezcla datos propios y compartidos. Revisad el impacto de cada relación y preferid operaciones explícitas cuando el alcance no sea obvio.
Una secuencia habitual consiste en detener nuevas escrituras asociadas al sujeto, invalidar sesiones o credenciales, retirar dependencias internas, borrar o transformar los registros propios y, después, propagar la operación a índices y servicios externos. El orden concreto depende de la arquitectura. Si se elimina primero la clave que permite localizar datos en otros sistemas, la tarea puede perder la información necesaria para continuar. Conservad esa referencia de trabajo de forma protegida y limitada al tiempo necesario, sin convertir el registro operativo en un almacén paralelo.
Hacer el flujo idempotente y reanudable
Los trabajos distribuidos pueden fallar después de completar una operación y antes de comunicarlo. Por eso, cada paso debe poder repetirse sin causar efectos indebidos. Una eliminación idempotente puede aceptar que un registro ya no exista y devolver un resultado controlado, en lugar de tratarlo siempre como error.
Guardad el avance por destino y utilizad una clave de idempotencia o un identificador estable del caso cuando el sistema remoto lo admita. Procesad cada destino en una transacción o unidad de trabajo apropiada, sin mantener una transacción de base de datos abierta mientras esperáis una API. Si hay un fallo, reintentad con límites y una estrategia de espera; los errores agotados deben pasar a una cola de revisión, no desaparecer en un log.
La reanudación debe continuar desde los pasos incompletos. No reiniciéis todo el flujo si eso puede repetir acciones no seguras o sobrescribir resultados previos. En particular, distinguíd entre «solicitud enviada» y «eliminación confirmada»: una respuesta HTTP satisfactoria puede confirmar recepción, no necesariamente la finalización del trabajo remoto. Definid el significado de cada acuse con el proveedor.
Verificar sin conservar lo que se elimina
La verificación debe corresponder al destino y al tipo de operación. En la base de datos, una consulta por las claves previstas puede confirmar que ya no quedan filas dentro del alcance. En almacenamiento, se puede comprobar la ausencia del objeto o la respuesta del mecanismo de borrado. En un índice, hay que consultar el documento con una clave adecuada y considerar el tiempo de propagación. Un mensaje de éxito del trabajador no reemplaza esas comprobaciones.
Registrad evidencia mínima: identificador del caso, destino, operación, marca temporal, estado, número de elementos afectados cuando sea seguro y referencia técnica del resultado. Evitad copiar contenido eliminado, credenciales, tokens o identificadores personales innecesarios a logs y métricas. Proteged el registro de auditoría, limitad su acceso y definid su retención interna. La evidencia debe permitir explicar el proceso sin recrear la información que se intentó retirar.
Gestionar límites y probar el flujo
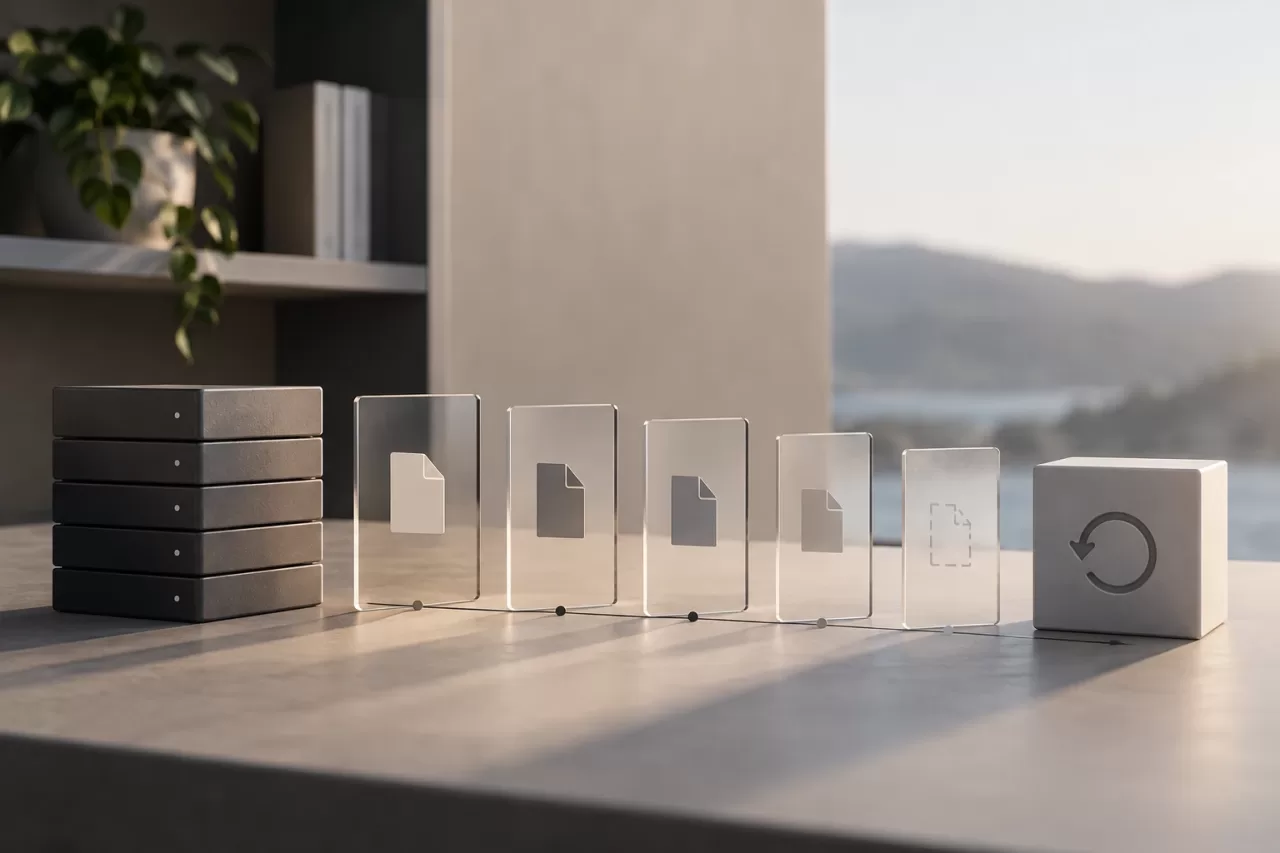
Las copias de seguridad requieren un tratamiento explícito. Puede que no admitan una eliminación selectiva inmediata; documentad el ciclo de retención previsto y cómo se evita que una restauración vuelva a introducir datos ya eliminados. Por ejemplo, el procedimiento de recuperación puede volver a aplicar solicitudes pendientes o completadas antes de habilitar el sistema restaurado. No afirméis que una copia ha sido borrada si el mecanismo disponible solo permite que expire según su retención.
Para sistemas externos, indicad quién puede iniciar la operación, qué confirmación ofrece el proveedor y cuándo debe escalarse un resultado incierto. Una limitación operativa no equivale a una verificación satisfactoria: debe mostrarse como pendiente, restringida o resuelta según la evidencia disponible.
Antes de operar, probad el flujo en entornos no productivos con datos sintéticos: solicitudes duplicadas, relaciones compartidas, archivos ausentes, timeouts, respuestas ambiguas y fallos después de completar un paso. Comprobad que los reintentos no duplican efectos, que los permisos bloquean accesos indebidos y que los informes no exponen datos. En producción, supervisad volumen de fallos, antigüedad de casos pendientes y destinos sin confirmación, sin incluir información personal en las alertas.
Lista de comprobación: alcance y excepciones definidos; destinos y responsables inventariados; estados y transiciones documentados; dependencias revisadas; pasos idempotentes y reanudables; verificación específica por sistema; evidencia minimizada y protegida; límites de copias y proveedores comunicados; pruebas de fallos realizadas; procedimiento de revisión y escalado disponible. Con estos controles, el equipo puede responder con trazabilidad y detectar exactamente dónde se detuvo una eliminación, en lugar de confundir una acción iniciada con un resultado confirmado.