Una richiesta di eliminazione non si risolve con un DELETE sulla tabella degli utenti. In un’applicazione con più moduli, le informazioni possono comparire in record correlati, file, indici di ricerca, code, esportazioni o servizi esterni. Eliminare solo l’account visibile può lasciare copie accessibili; eliminare alla cieca può incidere su dati che devono essere conservati affinché altri processi continuino a funzionare.
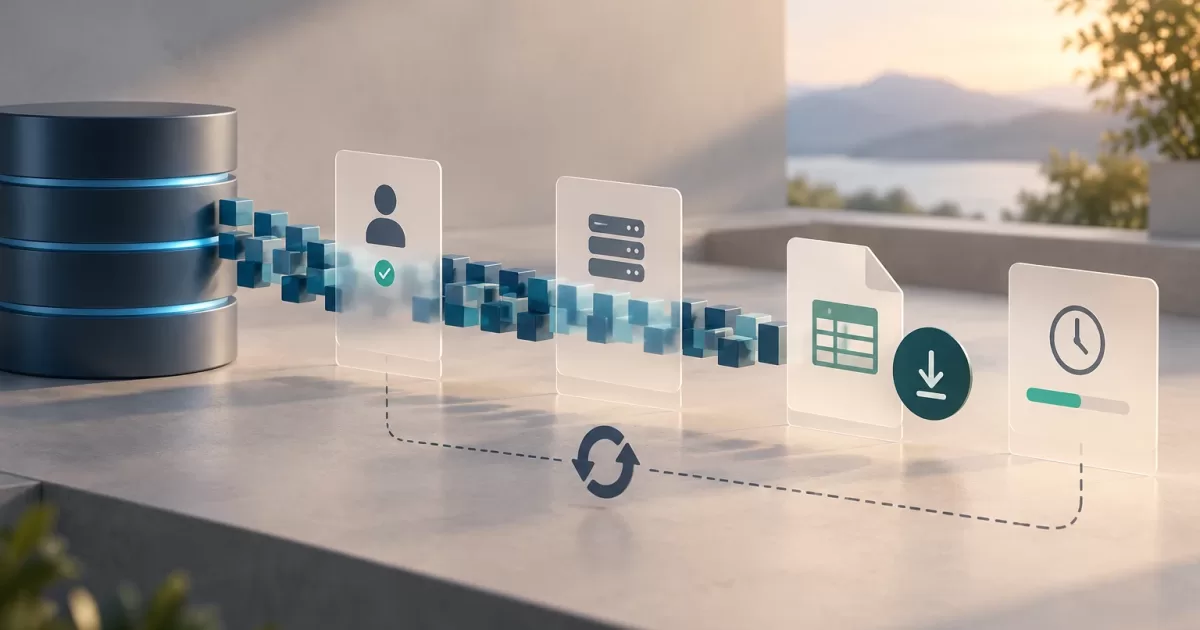
L’eliminazione verificabile dei dati in PHP va progettata come un processo con ambito esplicito, responsabili, stati, tentativi e verifiche. L’obiettivo operativo non è promettere che qualsiasi copia scompaia immediatamente: è poter identificare quali destinazioni sono state elaborate, quale risultato è stato ottenuto per ciascuna e quali limiti restano in sospeso.
Definire l’ambito prima di procedere
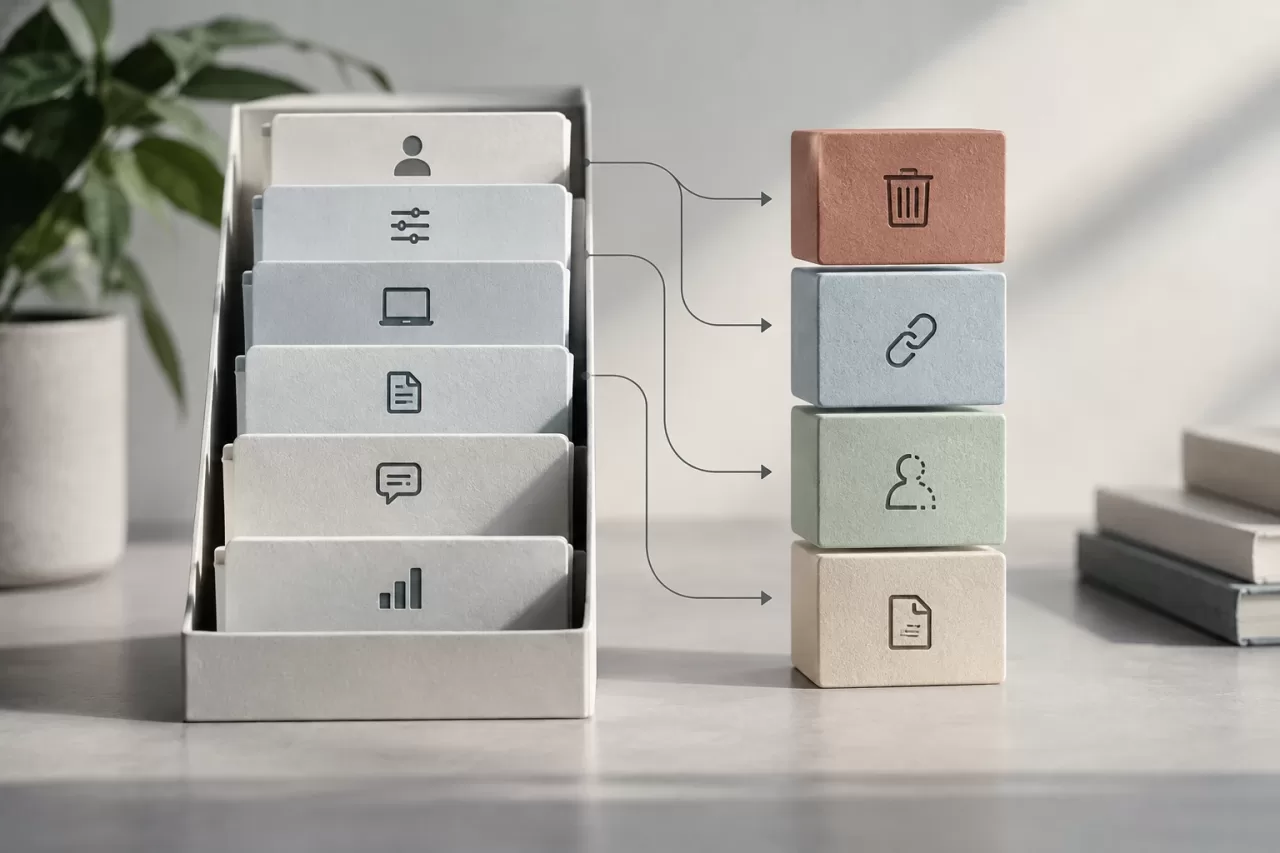
Traducete la richiesta in un inventario di categorie di dati e sistemi. Per esempio, un account può avere un profilo, preferenze, sessioni, documenti, commenti ed eventi di attività. Possono inoltre esserci riferimenti in fatture o altri record condivisi. Per ogni categoria, decidete se eliminarla, scollegarla, anonimizzarla o conservarla in base a una policy interna applicabile. Non considerate queste opzioni equivalenti: per anonimizzare è necessario che la persona non sia più identificabile nel contesto previsto, mentre scollegare non elimina necessariamente i dati originali.
Definite anche che cosa significa «completato» per ciascuna destinazione. Una riga rimossa dal database principale non dimostra che l’indice di ricerca sia stato aggiornato o che un file sia stato eliminato. Distinguete le destinazioni sotto controllo diretto — database, object storage, cache — da quelle che dipendono da un provider o da una finestra di conservazione, come alcuni backup. Lo stato finale deve riflettere queste differenze, non nasconderle dietro un’unica etichetta di successo.
Inventariare le copie e assegnare i responsabili
L’inventario deve seguire i flussi di dati reali, non soltanto lo schema del database. Verificate dove i dati vengono creati, esportati o trasformati: code di job, indici di ricerca, sistemi di analytics, file temporanei, log applicativi e strumenti integrati. Chiedete a ogni team quale identificatore consente di trovare i record e quale operazione supporta il suo sistema.
Assegnate un responsabile tecnico per ogni destinazione e documentate il meccanismo, la risposta attesa, i tentativi e le limitazioni. Se un sistema non consente di cercare tramite un identificatore stabile, questa mancanza rende più difficile la verifica e va trattata come debito di progettazione. Evitate di salvare una copia aggiuntiva dei dati personali nel registro stesso della richiesta: in genere bastano un identificatore interno del caso, il riferimento necessario per eseguire l’operazione e risultati minimizzati.
Modellare stati e risultati per sistema
Un processo robusto prevede stati espliciti, per esempio: received, validated, in_progress, partially_completed, verification_pending, completed e failed. Concordate le transizioni e chi può avviarle. Una richiesta non dovrebbe essere contrassegnata come completata finché le destinazioni obbligatorie non hanno un risultato verificabile.
Registrate separatamente il risultato di ogni sistema: in sospeso, eliminato, non trovato, ripetibile, da sottoporre a revisione o soggetto a una limitazione documentata. «Non trovato» può essere un risultato valido, ma solo se la ricerca ha utilizzato la chiave corretta e coperto l’ambito previsto. Distinguete un errore temporaneo — per esempio, un servizio non disponibile — da un rifiuto permanente che richiede un intervento.
In PHP, separate il coordinamento dalle operazioni specifiche di ogni destinazione. Un application service può caricare il caso, verificare i permessi e accodare i task; adapter indipendenti implementano le operazioni per il database, lo storage o le API. In questo modo, una modifica a un provider non obbliga a mescolare la logica di business con i dettagli di trasporto. Proteggete inoltre la creazione e la consultazione del caso con controlli di accesso e registrate chi ha avviato le azioni amministrative.
Ordinare la cancellazione rispettando le dipendenze
Prima di eliminare, determinate quali relazioni dipendono dall’account e quali sono condivise. Le chiavi esterne e le regole di cancellazione a cascata aiutano a mantenere l’integrità, ma una cascata può eliminare più del previsto se il modello mescola dati propri e condivisi. Verificate l’impatto di ogni relazione e preferite operazioni esplicite quando l’ambito non è ovvio.
Una sequenza comune consiste nel bloccare nuove scritture associate al soggetto, invalidare sessioni o credenziali, rimuovere le dipendenze interne, eliminare o trasformare i record propri e, successivamente, propagare l’operazione a indici e servizi esterni. L’ordine specifico dipende dall’architettura. Se si elimina per prima la chiave che consente di trovare i dati in altri sistemi, il task potrebbe perdere le informazioni necessarie per proseguire. Conservate questo riferimento operativo in modo protetto e solo per il tempo necessario, senza trasformare il registro operativo in un archivio parallelo.
Rendere il flusso idempotente e riprendibile
I job distribuiti possono fallire dopo aver completato un’operazione e prima di comunicarlo. Per questo, ogni passaggio deve poter essere ripetuto senza causare effetti indesiderati. Un’operazione di eliminazione idempotente può accettare che un record non esista già e restituire un risultato controllato, invece di trattare sempre il caso come un errore.
Salvate l’avanzamento per destinazione e utilizzate una chiave di idempotenza o un identificatore stabile del caso, quando il sistema remoto lo supporta. Elaborate ogni destinazione in una transazione o unità di lavoro appropriata, senza mantenere aperta una transazione del database mentre aspettate una API. In caso di errore, riprovate con limiti e una strategia di attesa; gli errori che esauriscono i tentativi devono passare a una coda di revisione, non sparire in un log.
La ripresa deve proseguire dai passaggi incompleti. Non riavviate l’intero flusso se ciò può ripetere azioni non sicure o sovrascrivere risultati precedenti. In particolare, distinguete tra «richiesta inviata» ed «eliminazione confermata»: una risposta HTTP positiva può confermare la ricezione, ma non necessariamente il completamento del lavoro remoto. Definite con il provider il significato di ogni conferma.
Verificare senza conservare ciò che viene eliminato
La verifica deve essere adeguata alla destinazione e al tipo di operazione. Nel database, una query sulle chiavi previste può confermare che non restano righe nell’ambito. Nello storage, si può verificare l’assenza dell’oggetto o la risposta del meccanismo di eliminazione. In un indice, occorre interrogare il documento con una chiave appropriata e considerare i tempi di propagazione. Un messaggio di successo del worker non sostituisce queste verifiche.
Registrate solo le evidenze minime: identificatore del caso, destinazione, operazione, timestamp, stato, numero di elementi interessati quando è sicuro e riferimento tecnico del risultato. Evitate di copiare contenuti eliminati, credenziali, token o identificatori personali non necessari nei log e nelle metriche. Proteggete il registro di audit, limitatene l’accesso e definite la sua conservazione interna. Le evidenze devono consentire di spiegare il processo senza ricreare le informazioni che si è tentato di rimuovere.
Gestire i limiti e testare il flusso
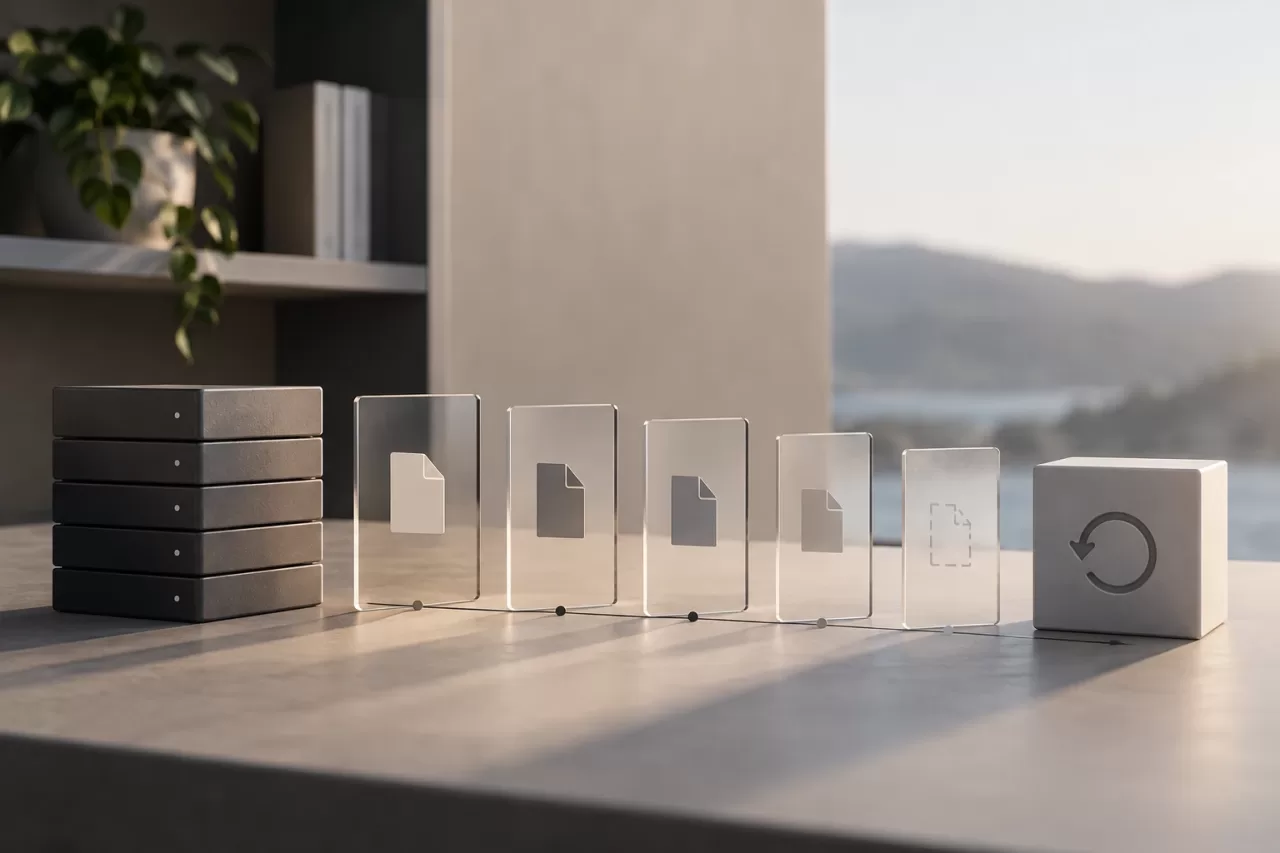
I backup richiedono una gestione esplicita. Potrebbero non consentire un’eliminazione selettiva immediata; documentate il ciclo di conservazione previsto e come si evita che un ripristino reintroduca dati già eliminati. Per esempio, la procedura di ripristino può applicare nuovamente le richieste in sospeso o completate prima di rendere disponibile il sistema ripristinato. Non dichiarate che un backup è stato eliminato se il meccanismo disponibile consente soltanto di lasciarlo scadere secondo i tempi di conservazione.
Per i sistemi esterni, indicate chi può avviare l’operazione, quale conferma offre il provider e quando occorre segnalare un risultato incerto. Una limitazione operativa non equivale a una verifica positiva: in base alle evidenze disponibili, deve essere indicata come in sospeso, limitata o risolta.
Prima di operare, testate il flusso in ambienti non produttivi con dati sintetici: richieste duplicate, relazioni condivise, file assenti, timeout, risposte ambigue ed errori dopo il completamento di un passaggio. Verificate che i tentativi non duplichino gli effetti, che i permessi blocchino gli accessi impropri e che i report non espongano dati. In produzione, monitorate il volume degli errori, l’età dei casi in sospeso e le destinazioni senza conferma, senza includere informazioni personali negli alert.
Lista di controllo: ambito ed eccezioni definiti; destinazioni e responsabili inventariati; stati e transizioni documentati; dipendenze verificate; passaggi idempotenti e riprendibili; verifica specifica per sistema; evidenze minimizzate e protette; limiti di backup e provider comunicati; test dei guasti eseguiti; procedura di revisione e escalation disponibile. Con questi controlli, il team può rispondere con tracciabilità e individuare esattamente dove si è fermata un’eliminazione, invece di confondere un’azione avviata con un risultato confermato.