Una policy di conservazione e cancellazione non si implementa con una singola istruzione DELETE. In un’applicazione PHP, le stesse informazioni possono trovarsi in più tabelle, file, cache, log e servizi esterni. Se il processo elimina solo la riga principale, può lasciare copie attive; se cancella senza verificare le dipendenze, può compromettere le operazioni o eliminare dati che andavano conservati.
L’obiettivo pratico è trasformare ogni regola in un flusso che individui i dati interessati, applichi l’azione adeguata, gestisca le eccezioni e lasci evidenze verificabili. La policy deve essere concordata con le aree responsabili di prodotto, tecnologia e dati e confrontata con gli obblighi applicabili all’attività. Non è opportuno dedurre scadenze legali universali: dipendono dal contesto e devono essere convalidate prima di automatizzarle.
Inizia dalle categorie e dalle regole di conservazione
Prima di progettare la cancellazione, classifica le informazioni in base alla loro finalità e al loro utilizzo. Un profilo, un indirizzo necessario per un’operazione in corso, uno storico delle attività e un registro contabile possono essere soggetti a regole diverse, anche se sono collegati allo stesso account.
Per ogni categoria, documenta almeno:
- Finalità e responsabile: perché le informazioni vengono archiviate e quale team decide in merito alla loro conservazione.
- Evento che avvia la regola: per esempio, chiusura dell’account, scadenza di una relazione o richiesta convalidata.
- Termine e condizione: quando l’azione viene verificata o eseguita, incluse eventuali sospensioni giustificate.
- Azione: cancellare, anonimizzare, conservare con accesso limitato o sottoporre a revisione manuale.
- Dipendenze: sistemi e processi che devono essere completati prima di dichiarare concluso il caso.
“Conservare” non significa mantenere i dati a tempo indeterminato per comodità. Occorrono una motivazione, un ambito e una data o condizione per la revisione. Se una parte delle informazioni deve essere mantenuta per esigenze operative, separa quel sottoinsieme dal resto e limita chi può accedervi.
Inventaria copie, riferimenti e sistemi collegati
L’inventario deve seguire il percorso effettivo del dato, non solo lo schema del database. Esamina tabelle correlate, campi JSON, file caricati, esportazioni, indici di ricerca, cache, code, log applicativi e sistemi integrati. Includi anche i flussi che generano copie: report, strumenti di supporto, analisi o processi di importazione.
Per ogni posizione, annota quale identificatore consente di trovare il dato, chi ne è responsabile, come viene eliminato o aggiornato e cosa accade se il sistema non è disponibile. Verifica le relazioni tramite chiavi esterne e logica applicativa: una relazione nel database può impedire la cancellazione a cascata, mentre una cancellazione a cascata può eliminare più dati del previsto.
Considera i backup come un caso distinto. La possibilità di cancellare un singolo elemento da una copia di backup potrebbe dipendere dal ripristino della copia completa. Definisci come limitarne l’accesso, per quanto tempo vengono conservati e quale procedura impedisce che un dato cancellato torni nei sistemi attivi dopo un ripristino. Documenta la decisione e convalidala con i responsabili dell’infrastruttura e della compliance.
Decidi quando cancellare, anonimizzare o conservare
La cancellazione fisica rimuove il dato da un sistema attivo, ma non è sempre la scelta corretta per ogni record. L’anonimizzazione può essere appropriata quando è necessario conservare informazioni statistiche e si può eliminare efficacemente la possibilità di ricondurle a una persona. Sostituire un nome con un identificatore stabile non è sufficiente se un’altra tabella consente di ricostruire il collegamento.
La conservazione con accesso limitato può essere utile per i dati ancora necessari a un’operazione o a un obbligo convalidato. Mantieni questi elementi separati, con autorizzazioni specifiche e una regola di revisione. Se non è possibile stabilire con sicurezza quale azione intraprendere — per esempio, a causa di una disputa, di una dipendenza sconosciuta o di un’incoerenza nell’identità — indirizza il caso a una coda di revisione, invece di improvvisare.
Occorre inoltre verificare le conseguenze funzionali: cosa accade a ordini, abbonamenti, ticket, chiavi API o documenti condivisi quando un account viene eliminato. Il comportamento deve essere esplicito e coerente tra interfaccia, logica PHP e servizi collegati.
Implementa un flusso idempotente e osservabile
Un processo di cancellazione viene spesso eseguito in background, tramite una coda o un’attività pianificata. Modella il caso con stati espliciti, per esempio: richiesto, convalidato, in elaborazione, in attesa dei sistemi esterni, completato o da sottoporre a revisione. Definisci le transizioni consentite e chi può ritentare l’operazione o chiudere un’eccezione.
L’idempotenza è essenziale: ripetere una fase non deve duplicare gli effetti né causare danni. Prima di cancellare un file, verifica che esista; quando elabori una richiesta, controlla lo stato corrente; quando chiami un servizio esterno, utilizza meccanismi di idempotenza, se disponibili. Se non puoi garantirla, registra la risposta e progetta una riconciliazione prima di ritentare alla cieca.
Uno schema concettuale in PHP potrebbe separare l’orchestrazione dalle azioni specifiche per sistema:
foreach ($steps as $step) {
    if ($step->isComplete($requestId)) {
        continue;
    }

    $step->execute($subjectReference);
    $step->markComplete($requestId);
}
L’esempio non risolve il problema delle transazioni distribuite: un database e un fornitore esterno non condividono necessariamente una transazione. Salva i progressi in modo affidabile, gestisci gli errori per fase e consenti di riprendere il lavoro. Se un’operazione fallisce a metà, lo stato deve indicare cosa resta da fare; non deve risultare completata.
Registra l’esecuzione senza creare un’altra copia di dati personali
La tracciabilità consente di rispondere a domande come chi o quale processo ha agito, quando, su quale richiesta e con quale risultato. Registra gli identificatori interni dell’operazione, gli stati, le fasi e i codici di errore utili alla diagnosi. Evita di copiare nei log nomi, indirizzi email, documenti, contenuti di file o payload API completi.
Anche un identificatore utente pseudonimo può essere sensibile se consente di risalire a una persona. Limita l’accesso ai log, definiscine il periodo di conservazione e, quando possibile, separa le informazioni operative dall’identità. I messaggi di errore devono aiutare a individuare il sistema interessato senza esporre dati personali negli strumenti di monitoraggio.
Verifica il risultato e prepara la gestione delle eccezioni
I test devono coprire sia il caso normale sia gli errori parziali. Usa dati di test e verifica le posizioni individuate nell’inventario, non solo la tabella principale. Includi scenari come una relazione che impedisce la cancellazione, un file assente, un fornitore esterno non disponibile, un nuovo tentativo e un’eccezione che richiede una revisione.
Una checklist operativa utile si chiede: è stata individuata ogni copia nota? È stata applicata l’azione prevista per ogni categoria? È rimasta qualche fase in sospeso? I sistemi esterni hanno confermato il risultato? I log contengono solo le informazioni necessarie? Un nuovo tentativo mantiene sicuro il processo? Aggiungi verifiche periodiche per rilevare nuove tabelle, integrazioni o percorsi dei dati esclusi dall’inventario.
Esempio ipotetico: chiusura di un account
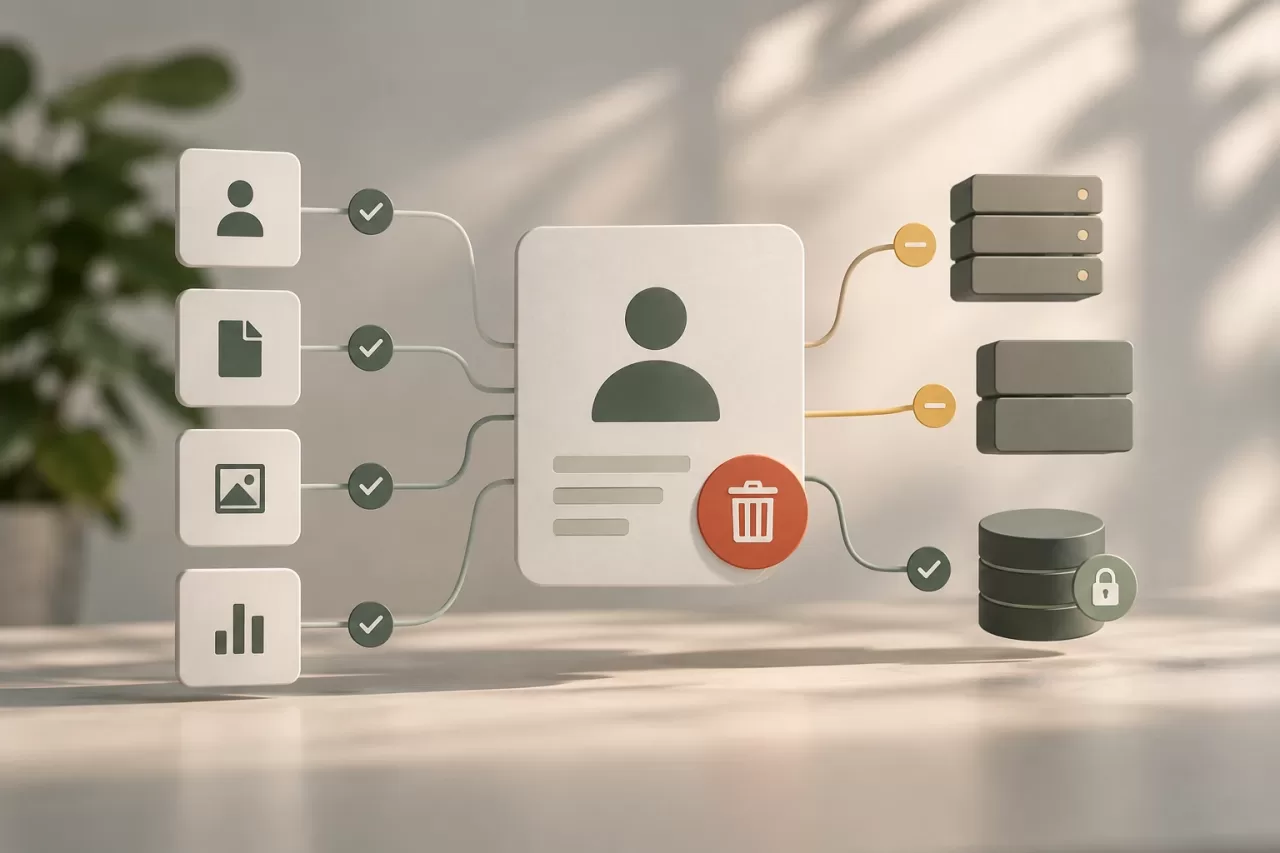
Supponiamo che una persona chieda di chiudere il proprio account in un’applicazione PHP. Il flusso convalida la richiesta e consulta le regole definite per il profilo, i file, le attività e le informazioni associate alle operazioni in corso. Il profilo e i file idonei vengono eliminati; alcuni record vengono conservati con accesso limitato se esiste una motivazione approvata; i dati destinati all’analisi vengono mantenuti solo se sono stati anonimizzati in modo efficace.
L’applicazione registra ogni fase senza includere l’indirizzo email né il contenuto dei file. Se un servizio esterno non risponde, il caso rimane in sospeso e un processo successivo ritenta l’operazione o richiede un intervento, secondo quanto previsto dalla policy. Il caso viene contrassegnato come completato solo quando tutte le azioni richieste sono state confermate oppure quando un’eccezione formale è stata documentata e approvata.
Prima di implementare il processo, risolvi le decisioni ancora aperte: quali sistemi contengono il dato, chi autorizza le eccezioni, cosa significa “completato” per ciascuna destinazione, come vengono gestiti i backup e chi esamina gli errori. Questa definizione trasforma un’intenzione di cancellazione in un processo manutenibile, verificabile e sicuro.