Una migrazione può modificare milioni di record, alimentare processi attivi e produrre effetti al di fuori del database. Se una trasformazione fallisce a metà, ripristinare una copia completa non è sempre sicuro né accettabile: dopo la copia potrebbero essere stati scritti nuovi dati oppure il sistema potrebbe non potersi fermare per il tempo richiesto dal ripristino.
Per questo, un piano di rollback per migrazioni di dati non deve ridursi a un comando per tornare indietro. Deve stabilire come identificare lo stato interessato, quali operazioni possono essere annullate, quali richiedono una compensazione e quando è opportuno correggere o riprendere l’esecuzione. La decisione va preparata prima di eseguire la migrazione, sulla base di criteri che il team possa verificare sotto pressione.
Perché ripristinare una copia non è sempre una soluzione praticabile
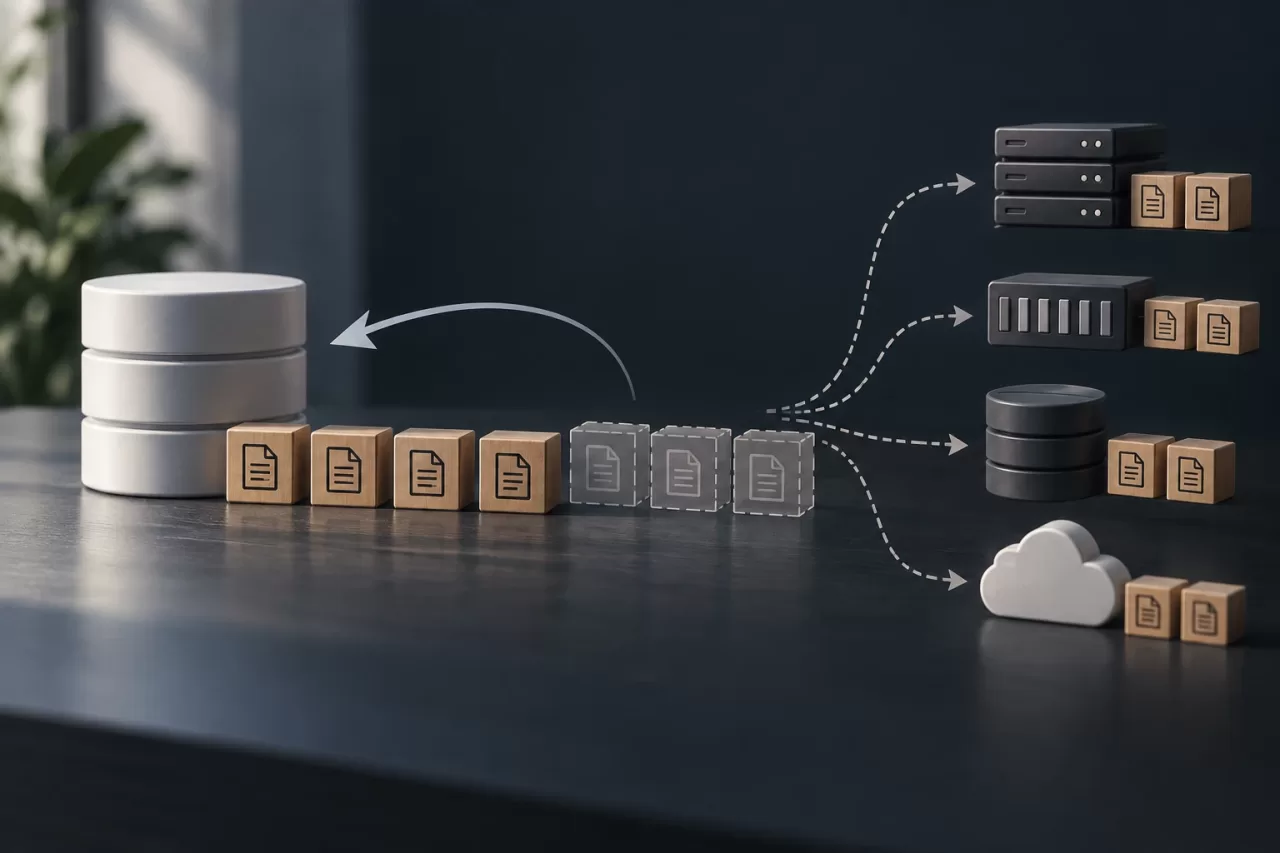
Un backup consente di recuperare i dati in caso di determinati incidenti, ma il ripristino può eliminare modifiche legittime apportate dopo la sua creazione. Può anche comportare un’indisponibilità, la ricostruzione degli indici o la perdita di scritture inviate ad altri sistemi. In presenza di replica, code, esportazioni o integrazioni, recuperare un database non annulla automaticamente questi effetti.
È utile distinguere tre azioni. Ripristinare recupera una copia o un punto nel tempo; annullare tenta di disfare le modifiche della migrazione; compensare applica nuove operazioni per correggerne gli effetti. Non sono equivalenti: una compensazione può lasciare una cronologia diversa da quella originale, pur ripristinando le regole di business.
La scelta dipende dall’entità del guasto, dalle scritture successive e dagli obiettivi di ripristino. Prima di iniziare, stabilite quale perdita di dati è tollerabile, quanto può durare l’interruzione e chi autorizza il ripristino. Se questi limiti non sono definiti, il team non dispone di criteri operativi per decidere.
Classificare ogni trasformazione in base alla possibilità di recupero
Descrivete ogni passaggio della migrazione e classificatelo secondo la modalità di recupero prevista:
- Reversibile: esiste un’operazione inversa affidabile. Per esempio, il valore originale viene conservato prima di normalizzare un campo e può essere ripristinato senza sovrascrivere modifiche successive.
- Compensabile: non è possibile ricostruire esattamente lo stato precedente, ma una nuova operazione può correggere l’effetto in base a una regola di business. La compensazione deve essere esplicita, verificabile e, quando possibile, idempotente.
- Irreversibile: vengono scartate informazioni o si produce un effetto che non può essere annullato con garanzie. Richiede una decisione esplicita sull’accettazione del rischio, la conservazione dei dati di origine e ulteriori convalide.
L’etichetta non va assegnata basandosi solo sul tipo di istruzione SQL. Un aggiornamento massivo può essere reversibile se il valore precedente viene salvato e la concorrenza è gestita; potrebbe non esserlo se, durante l’esecuzione, altri processi modificano le stesse righe. Considerate anche gli effetti collaterali, come notifiche, chiamate API, addebiti o messaggi nelle code. Spesso è preferibile separare queste azioni dalla trasformazione dei dati.
Fissare lo stato iniziale e le invarianti
Prima dell’esecuzione, registrate l’ambito della migrazione: entità incluse, filtri, versione dell’applicazione e regole applicate. Definite una baseline con conteggi rilevanti e, quando utile, aggregati o hash di insiemi stabili. Registrate il momento di riferimento e la fonte di questi dati. Un valore numerico senza ambito né contesto non consente di verificare un ripristino.
Le invarianti sono condizioni che devono continuare a essere vere durante e dopo la migrazione. Possono includere relazioni tra tabelle, unicità, stati consentiti, importi da preservare o corrispondenze tra i record del database e i sistemi connessi. Per ciascuna, aggiungete una query o una procedura riproducibile e una soglia di accettazione. Se i dati cambiano legittimamente durante l’esecuzione, definite come distinguere tale attività dagli effetti della migrazione.
In un’applicazione PHP, le trasformazioni possono essere implementate in comandi da console o processi worker, anziché dipendere da una richiesta web di lunga durata. Questa scelta non elimina i rischi di concorrenza né i limiti delle transazioni: stabilite quale unità può essere eseguita atomicamente e cosa fare se il processo termina tra due operazioni.
Progettare batch, checkpoint ed esecuzione riprendibile
Suddividete il lavoro in batch con limiti espliciti, per esempio usando una chiave stabile e ordinata. Evitate la paginazione tramite offset se le righe possono cambiare o scomparire durante il processo; un cursore di continuazione basato su una chiave è spesso più prevedibile. La dimensione del batch deve bilanciare la durata delle transazioni, il carico sul database e la facilità di rilevamento dei guasti.
Dopo ogni batch, salvate un checkpoint con l’identificativo del job, l’intervallo elaborato, lo stato, l’ora e i risultati della convalida. L’aggiornamento dei dati e l’avanzamento del checkpoint devono essere coordinati, per evitare di dichiarare elaborato un batch che non è stato confermato. Se le due operazioni non possono far parte di un’unica transazione, progettate una riconciliazione che rilevi la situazione intermedia.
Una migrazione riprendibile non riapplica ciecamente le modifiche. Ogni operazione deve tollerare i tentativi ripetuti o verificare se l’effetto esiste già. In PHP, si possono usare transazioni, vincoli univoci e operazioni idempotenti, in base al motore e al modello dei dati. Provate anche interruzioni intenzionali: un deploy, un’eccezione o una perdita di connessione non dovrebbero lasciare il processo senza una modalità nota per riprendere.
Registrare le modifiche per individuare gli effetti e verificare le decisioni
Assegnate un identificativo univoco a ogni esecuzione e registrate almeno la trasformazione, l’ambito, i batch, le righe interessate, gli errori e le decisioni di recupero. Per le modifiche compensabili, conservate i dati precedenti necessari o un riferimento sicuro a essi. Non registrate indiscriminatamente informazioni sensibili nei log: limitate l’accesso, il periodo di conservazione e il contenuto a quanto è necessario per il recupero e la verifica.
Il registro deve consentire di rispondere a domande precise: quali righe si è tentato di elaborare, quali sono state confermate, quali sono fallite e quale operazione successiva le ha modificate. Se necessario, affiancate i log tecnici a una cronologia delle modifiche di business. Non confondete la tracciabilità con un backup: il registro deve contenere dettagli sufficienti per il suo scopo e va protetto da perdita o alterazione.
Scegliere tra riprendere, compensare o ripristinare
Definite in anticipo segnali e risposte, invece di decidere solo d’istinto quando si verifica un errore:
- Riprendere: se il guasto è transitorio, le invarianti sono rispettate e i batch confermati sono identificati. Riprovate entro limiti definiti e monitorate gli errori e il carico.
- Compensare: se le modifiche applicate sono note ed esiste un’operazione correttiva collaudata. Interrompete prima le nuove scritture incompatibili e verificate che la compensazione non sovrascriva modifiche valide.
- Ripristinare: se la corruzione è estesa, il recupero dal backup è stato convalidato e l’impatto della perdita o della ricostruzione delle modifiche successive è accettabile. Coordinate il recupero con le repliche e le integrazioni.
- Fermarsi e coinvolgere i responsabili: se non è possibile determinare lo stato, i conteggi divergono senza spiegazioni o la compensazione potrebbe causare ulteriori danni. Conservate le evidenze prima di intervenire.
Stabilite soglie per sospendere il lavoro, come un tasso di errore superiore a quello consentito, un’invariante non rispettata o uno scostamento nei conteggi. Definite chi può autorizzare la ripresa e chi decide un ripristino. A volte, la scelta più sicura è isolare il flusso interessato e mantenere il sistema in uno stato controllato durante le indagini.
Convalidare e chiudere la migrazione con una lista di controllo
Il completamento del processo non dimostra che i dati siano corretti. Confrontate i conteggi prima e dopo con l’ambito previsto, eseguite le regole di business e controllate le relazioni e i valori estremi. Usate campionamenti per esaminare casi specifici, ma non come sostituti delle verifiche complete quando queste ultime sono possibili. Se esistono consumer esterni, controllatene anche gli stati e concordate come riconciliare le differenze.
Prima dell’esecuzione: classificate le trasformazioni, confermate il backup e il ripristino, provate batch e tentativi ripetuti con dati rappresentativi, definite invarianti, limiti di arresto, responsabili e finestra operativa. Assicuratevi che il team possa consultare il registro delle modifiche e che le procedure di compensazione o ripristino siano state collaudate.
Dopo l’esecuzione: convalidate i conteggi e le regole, esaminate gli errori e gli effetti esterni, conservate il registro dell’esecuzione e documentate ogni eccezione. Mantenete disponibili le informazioni di recupero per il periodo concordato e rimuovetele in modo sicuro quando non saranno più necessarie. La migrazione è chiusa solo quando i risultati sono verificabili ed è stata presa una decisione esplicita sulle eventuali deviazioni ancora aperte.