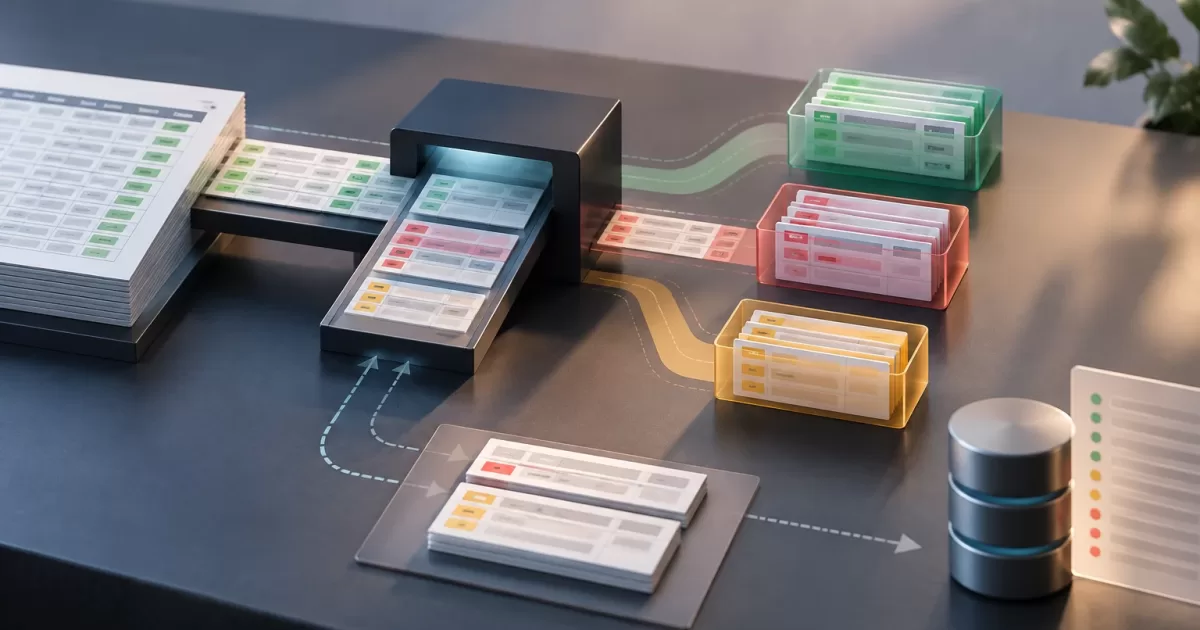
Un’importazione aziendale non dovrebbe costringere a scegliere tra annullare un intero lotto per una riga difettosa e acquisire dati dubbi. La quarantena dei dati nelle importazioni PHP offre una terza opzione: accettare i record validi, isolare quelli che richiedono attenzione e conservare un contesto sufficiente per risolvere i problemi in sicurezza.
La quarantena non è semplicemente una cartella degli errori né una tabella in cui salvare le righe non riuscite. È un flusso operativo con regole di classificazione, stati espliciti, correzioni controllate e tentativi ripetuti che non duplicano gli effetti. Per progettarlo, è opportuno concordare prima che cosa significhi «valido» per il business e quali azioni possa eseguire ciascun ruolo.
Classifichi gli errori prima di decidere come gestire ogni riga
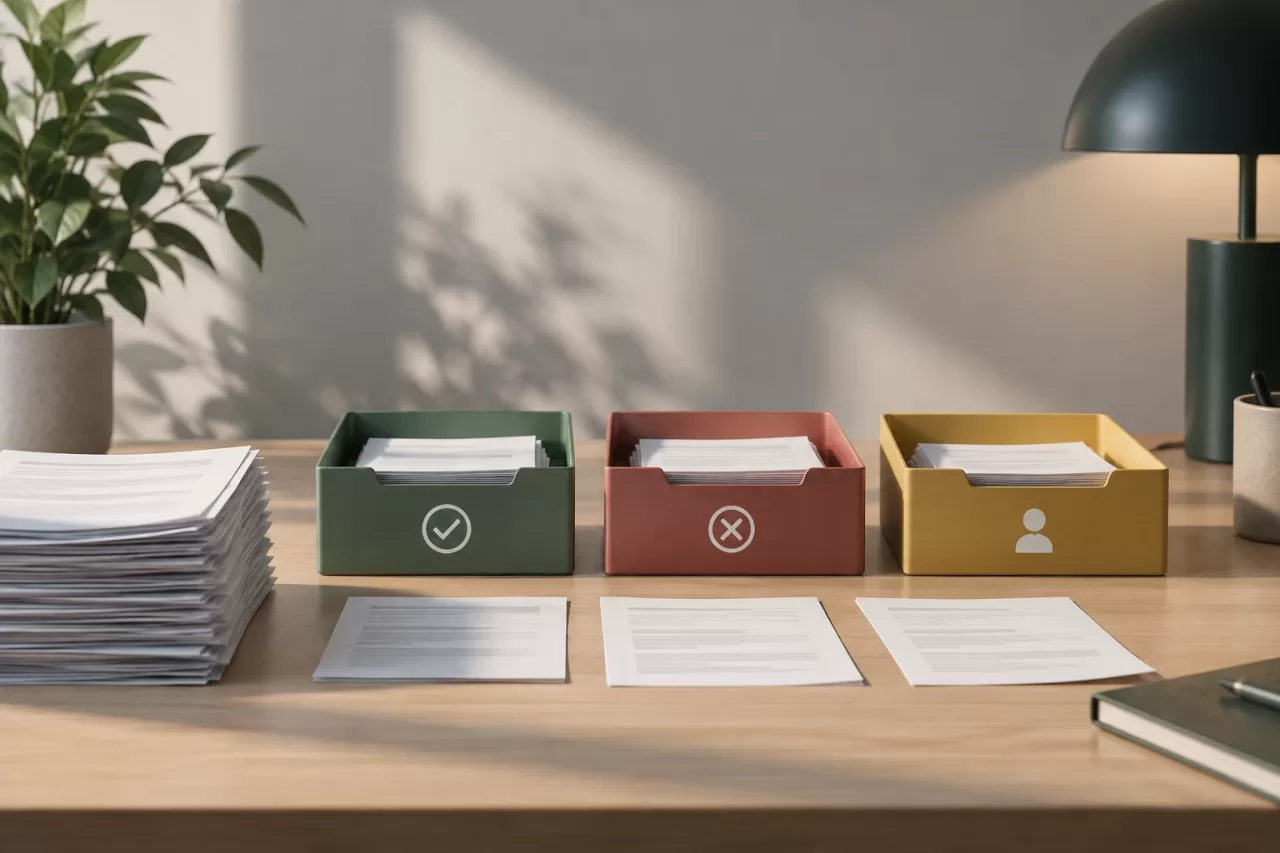
Un’importazione combina solitamente controlli diversi. Separarli permette di spiegare il risultato e decidere se il record può proseguire, deve essere rifiutato o richiede una revisione umana.
- Validazione strutturale: verifica il formato e il contenuto di base: colonne presenti, tipi di dato, date interpretabili, campi obbligatori e limiti ragionevoli. Un file illeggibile può impedire di elaborare il lotto; una data non valida in una sola riga, di norma, non dovrebbe farlo.
- Regole di business: verificano le condizioni del dominio, come un prezzo non negativo, un cliente attivo o una categoria consentita. Alcune violazioni possono essere rifiutate; altre possono dipendere da una decisione operativa.
- Conflitti con dati esistenti: rilevano, per esempio, un identificativo esterno già associato a un altro record o un aggiornamento basato su una versione obsoleta. Non sempre si risolvono correggendo il file: possono richiedere una riconciliazione o una revisione.
Definisca una policy per ogni tipo di errore. Un campo facoltativo mancante può ammettere un valore predefinito; un’identità ambigua non dovrebbe essere risolta scegliendo arbitrariamente un record. Eviti sia regole troppo permissive sia la classificazione di ogni difetto come errore fatale. La decisione dovrebbe riflettere l’impatto dell’accettazione del dato e il costo dell’interruzione del lotto.
Modelli stati e transizioni espliciti
Usi stati con un significato operativo, invece di dedurre la situazione da campi vuoti o messaggi di testo. Un modello iniziale può includere pending, accepted, rejected e needs_review. Aggiunga stati come processing o resolved solo se corrispondono a transizioni reali del flusso.
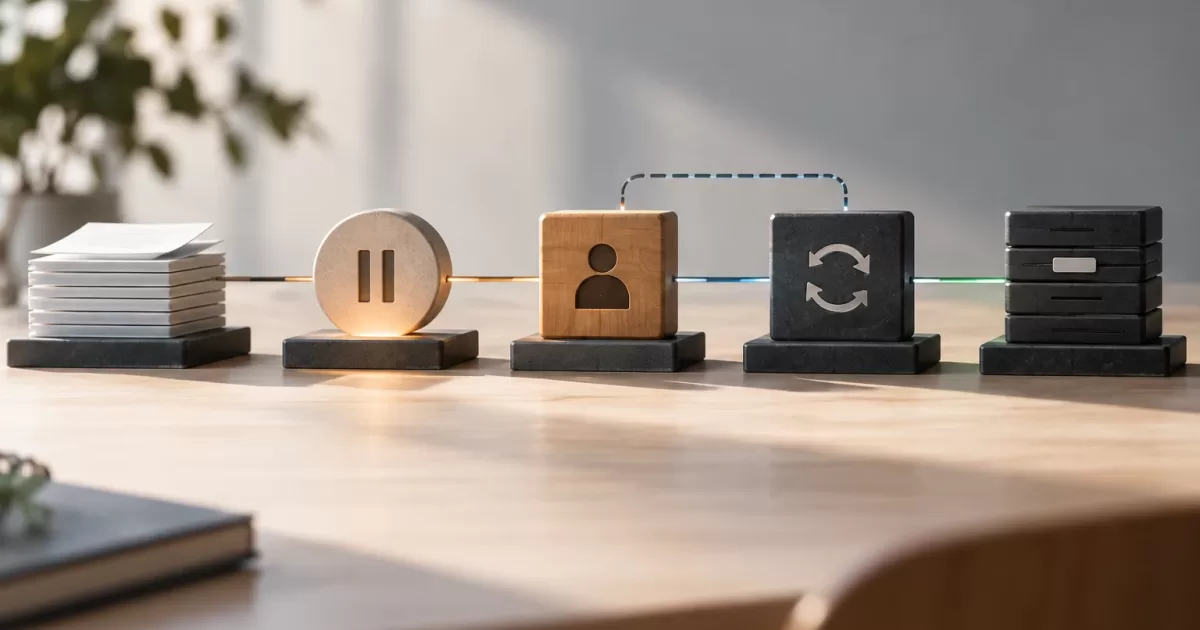
Documenti le azioni consentite da ogni transizione. Per esempio, una riga in attesa viene validata; se supera i controlli, viene accettata, mentre se presenta un conflitto che richiede revisione resta in attesa di revisione. Una riga corretta può essere validata di nuovo, ma una riga accettata non dovrebbe essere elaborata nuovamente come se fosse nuova. Registri separatamente lo stato del lotto: un lotto può terminare con alcune righe accettate e altre in quarantena, perciò «completato parzialmente» descrive il risultato meglio di un unico indicatore di successo o fallimento.
Gli stati devono corrispondere a decisioni verificabili. «Rifiutata» dovrebbe significare che la modifica dei dati aziendali non è stata applicata; «richiede revisione» indica che una persona deve prendere una decisione. Se è consentito sovrascrivere dati esistenti, specifichi chi può farlo e a quali condizioni.
Conservi l’originale e spieghi ogni decisione
Salvi separatamente l’input originale della riga, i relativi valori normalizzati e l’esito della validazione. Questa separazione permette di indagare sulle discrepanze — per esempio, tra una data ricevuta e la sua interpretazione — senza trasformare la versione elaborata nell’unica evidenza disponibile.
Una struttura di persistenza può includere un identificativo del lotto, il numero di riga, la provenienza, il riferimento al file, il contenuto originale, lo stato, gli errori rilevati, le date di creazione e risoluzione e l’attore responsabile. Registri i motivi con codici stabili e messaggi leggibili: un codice come customer_id_ambiguous aiuta a filtrare e quantificare i casi; il messaggio dovrebbe spiegare quale dato verificare. Eviti di affidarsi al testo libero come unica logica di classificazione.
Conservi anche il contesto necessario per riprodurre l’analisi: la versione o l’identificativo delle regole utilizzate, l’identificativo esterno e i dati rilevanti per il conflitto. Non salvi segreti né dati personali non necessari nei log tecnici. Definisca i controlli di accesso e un periodo di conservazione adeguati alla sensibilità dei dati e agli obblighi applicabili. Se l’intero file può contenere informazioni non necessarie a risolvere una riga, ne limiti l’esposizione.
Corregga e ritenti senza duplicare gli effetti
Un tentativo ripetuto sicuro parte dalla distinzione tra la riga e il tentativo di elaborarla. Assegni a ogni riga un’identità stabile nel relativo ambito, per esempio una combinazione di lotto e indice di riga o una chiave esterna convalidata. Per le importazioni ripetibili, definisca anche una chiave di idempotenza che consenta di riconoscere la stessa operazione. La scelta dipende dal fatto che ricaricare lo stesso file debba aggiornare i dati, ignorarli o creare una nuova versione.
Quando elabora una riga, applichi la scrittura dei dati aziendali e la modifica dello stato in modo atomico, se possibile: entrambe le operazioni vengono confermate insieme oppure nessuna delle due. In PHP, una transazione del database può proteggere le modifiche che utilizzano la stessa connessione; da sola, non rende atomica una chiamata a un’API esterna. Per gli effetti esterni, usi una strategia compatibile con il sistema ricevente, come chiavi di idempotenza, una tabella outbox transazionale o una compensazione progettata per il caso specifico.
Dopo una correzione, esegua di nuovo le validazioni pertinenti e conservi lo storico precedente. Non cancelli l’errore originale: aggiunga un nuovo tentativo con il relativo esito. Se cambiano le regole o i dati di riferimento, indichi quale versione è stata applicata ed eviti che una ripetizione modifichi silenziosamente una decisione già accettata. Il nuovo tentativo dovrebbe interessare solo i record selezionati, senza rielaborare indiscriminatamente l’intero lotto.
Progetti una revisione operativa sottoponibile ad audit
L’interfaccia di revisione dovrebbe aiutare a prendere una decisione, non limitarsi a mostrare un’eccezione tecnica. Includa il valore ricevuto, il motivo, il campo interessato, il contesto pertinente e, quando è sicuro, una proposta di correzione. Consenta di filtrare per stato, lotto, tipo di errore e anzianità; renda chiaro quali righe hanno già prodotto effetti e quali no.
Registri chi ha esaminato il caso, quando, quale valore ha modificato, la decisione presa e il motivo. Distingua la correzione di un operatore da una trasformazione automatica. Applichi le autorizzazioni in base alle responsabilità: chi può importare un file non dovrebbe necessariamente poter approvare conflitti o modificare record accettati. Per le modifiche ad alto impatto, valuti un’ulteriore approvazione.
Eviti che lo strumento faciliti la sovrascrittura di informazioni senza avvisi. Prima di accettare una correzione, verifichi nuovamente l’unicità, le autorizzazioni e lo stato attuale del record. Se un’altra persona ha modificato il dato dopo il rilevamento del conflitto, mostri la situazione affinché venga risolta, invece di applicare un aggiornamento obsoleto.
Testi i guasti parziali e il ripristino
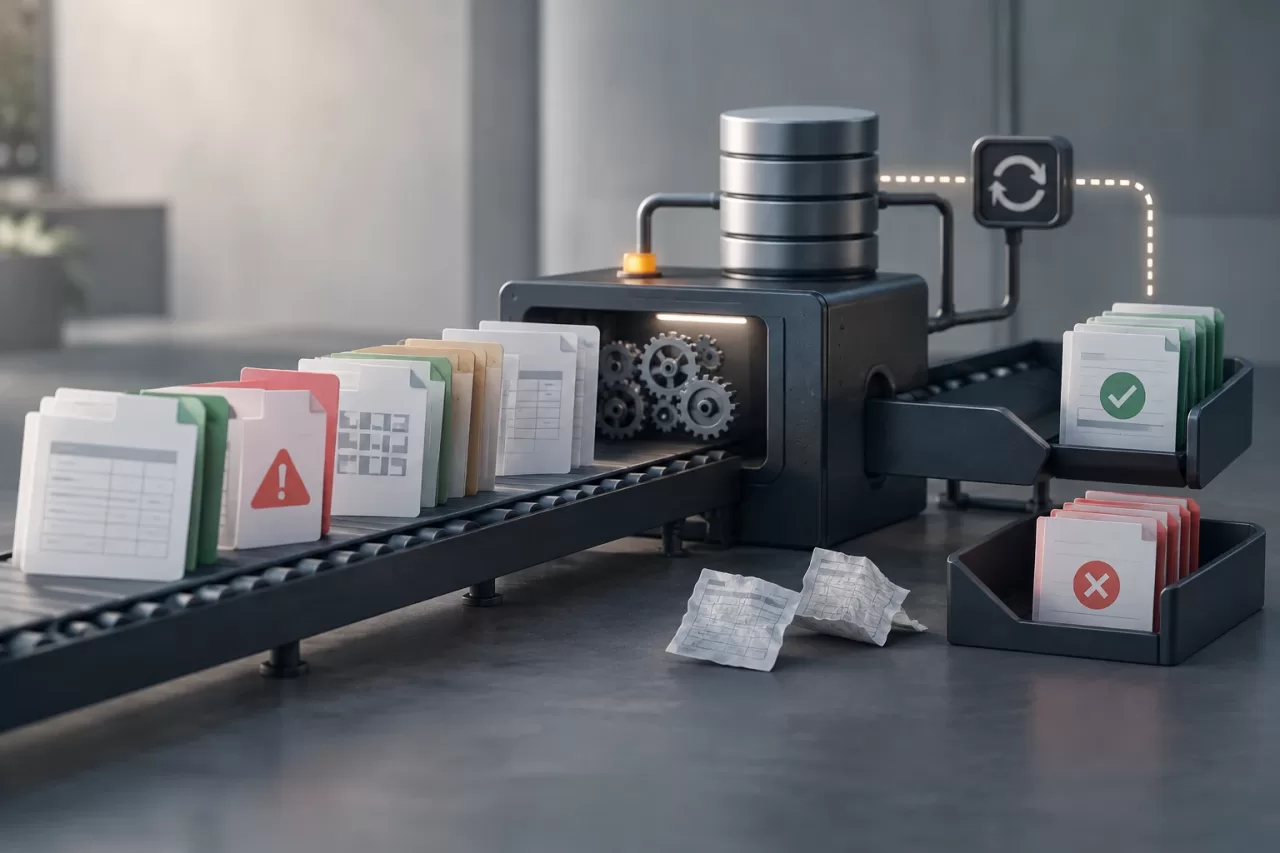
I test dovrebbero coprire sia le regole sia il comportamento del flusso. Includa file con righe valide e non valide mescolate, formati imprevisti, conflitti, errori temporanei del database e tentativi ripetuti. Verifichi che una riga rifiutata non impedisca di accettare le altre, se questa è la policy concordata, e che un errore all’interno di una transazione non lasci effetti parziali.
- Rielaborare una riga con la stessa chiave di idempotenza non duplica record né azioni esterne.
- Correggere un campo consente una nuova validazione senza cancellare l’originale né lo storico.
- Una riga già accettata non viene applicata di nuovo quando si ritenta l’elaborazione di un’altra.
- I conflitti rilevati tra la revisione e la risoluzione non vengono sovrascritti silenziosamente.
- I messaggi di errore consentono di intervenire senza esporre inutilmente dati sensibili.
In produzione, monitori il volume e l’anzianità dei record in quarantena, i motivi più frequenti, il tasso di risoluzione e i fallimenti dei tentativi ripetuti. Un aumento costante può segnalare un cambiamento nel sistema di origine, una regola non aggiornata o istruzioni di caricamento poco chiare. La quarantena funziona quando rende visibili queste cause e permette di risolverle in modo controllato, non quando diventa un deposito indefinito di eccezioni.