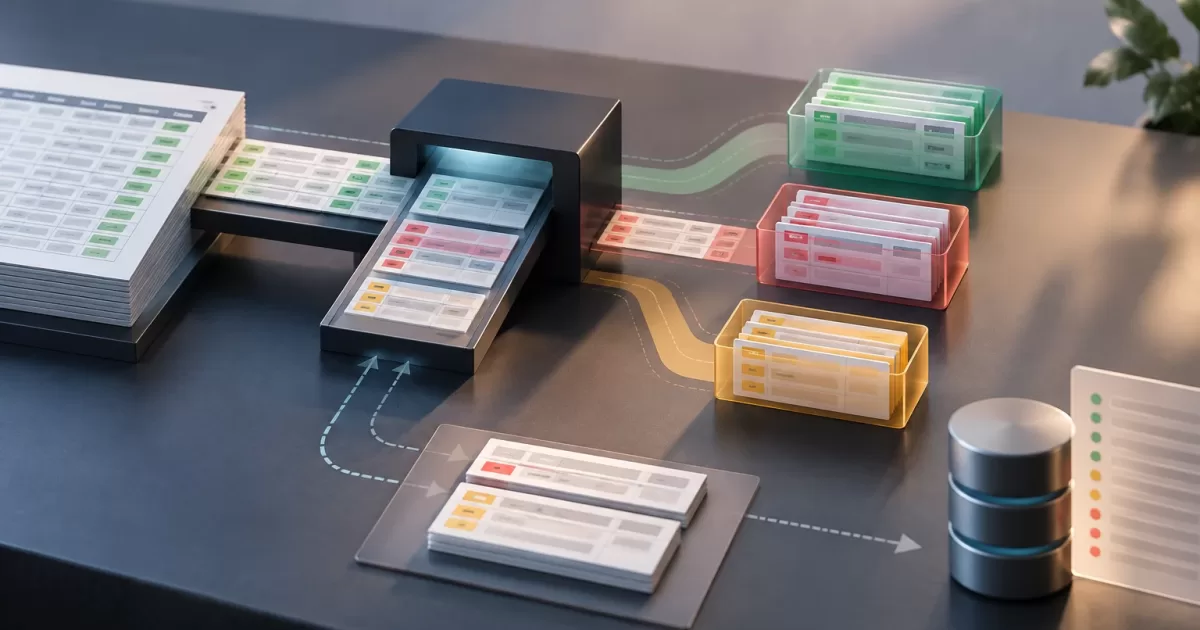
Import korporacyjny nie powinien zmuszać do wyboru między anulowaniem całej partii z powodu jednego wadliwego wiersza a przyjęciem danych budzących wątpliwości. Kwarantanna danych w importach PHP oferuje trzecią możliwość: przyjęcie prawidłowych rekordów, odizolowanie tych wymagających uwagi i zachowanie wystarczającego kontekstu, by bezpiecznie je rozwiązać.
Kwarantanna to nie tylko folder na błędy ani tabela do przechowywania nieudanych wierszy. To operacyjny przepływ obejmujący reguły klasyfikacji, jawne stany, kontrolowane korekty i ponowne przetwarzanie, które nie powiela skutków. Projektowanie warto zacząć od uzgodnienia, co dla firmy oznacza „prawidłowy” rekord i jakie działania może wykonywać każda rola.
Sklasyfikuj błędy, zanim zdecydujesz, co zrobić z każdym wierszem
Import zwykle łączy różne rodzaje kontroli. Rozdzielenie ich pozwala wyjaśnić wynik i zdecydować, czy rekord może być dalej przetwarzany, należy go odrzucić, czy wymaga weryfikacji przez człowieka.
- Walidacja strukturalna: sprawdza format i podstawową zawartość: obecność kolumn, typy danych, możliwość interpretacji dat, pola wymagane i rozsądne limity. Nieczytelny plik może uniemożliwić przetworzenie partii; nieprawidłowa data w pojedynczym wierszu zazwyczaj nie powinna go blokować.
- Reguły biznesowe: sprawdzają warunki dziedzinowe, takie jak nieujemna cena, aktywny klient czy dozwolona kategoria. Niektóre naruszenia należy odrzucić, inne mogą wymagać decyzji operacyjnej.
- Konflikty z istniejącymi danymi: wykrywają na przykład zewnętrzny identyfikator przypisany już do innego rekordu albo aktualizację opartą na nieaktualnej wersji. Nie zawsze można je rozwiązać przez poprawienie pliku — mogą wymagać uzgodnienia danych lub weryfikacji.
Określ politykę dla każdego rodzaju błędu. Brak opcjonalnego pola może pozwalać na użycie wartości domyślnej; niejednoznacznej tożsamości nie należy rozstrzygać przez arbitralny wybór rekordu. Unikaj zarówno zbyt liberalnych reguł, jak i uznawania każdej wady za błąd krytyczny. Decyzja powinna odzwierciedlać skutki przyjęcia danych oraz koszt zatrzymania partii.
Zdefiniuj jawne stany i przejścia
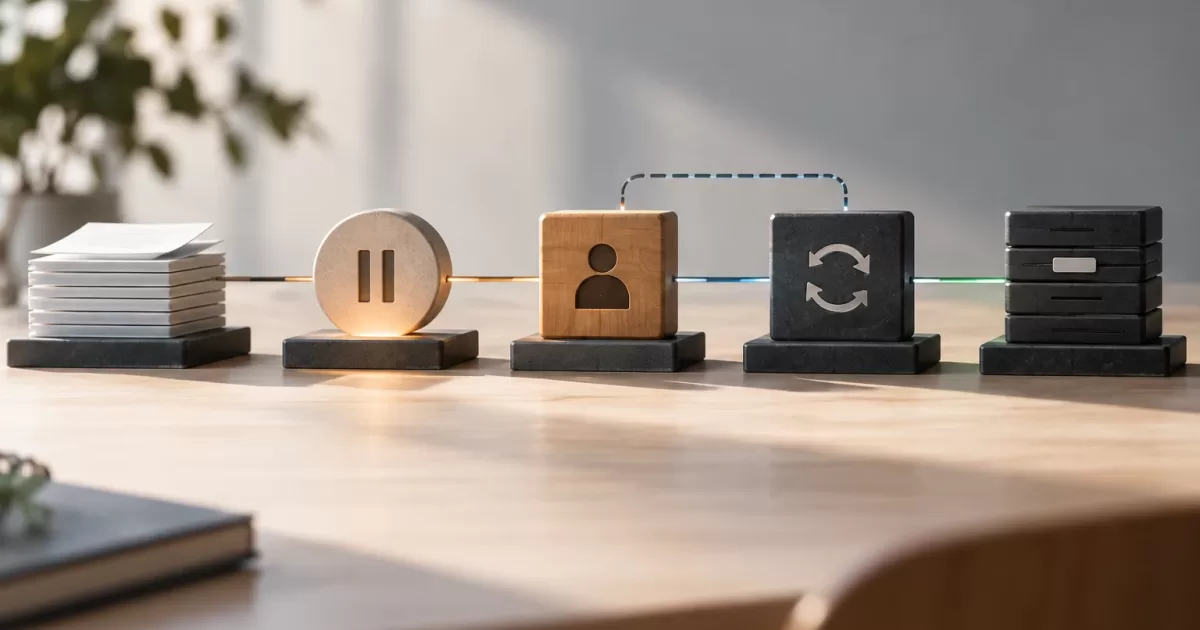
Używaj stanów o znaczeniu operacyjnym zamiast wywnioskowywać sytuację z pustych pól lub komunikatów tekstowych. Początkowy model może obejmować pending, accepted, rejected i needs_review. Dodawaj stany takie jak processing lub resolved tylko wtedy, gdy odpowiadają rzeczywistym przejściom w przepływie.
Udokumentuj, na co pozwala każde przejście. Na przykład oczekujący wiersz jest walidowany; jeśli spełnia reguły, zostaje zaakceptowany, a jeśli występuje w nim konflikt wymagający weryfikacji, trafia do sprawdzenia. Poprawiony wiersz można zwalidować ponownie, ale zaakceptowanego nie należy przetwarzać ponownie tak, jakby był nowy. Stan partii rejestruj oddzielnie: partia może zakończyć się z zaakceptowanymi wierszami i innymi w kwarantannie, dlatego „częściowo ukończona” lepiej opisuje wynik niż pojedynczy wskaźnik sukcesu lub porażki.
Stany powinny odpowiadać decyzjom, które można zweryfikować. „Odrzucony” powinien oznaczać, że zmiana biznesowa nie została zastosowana; „wymaga weryfikacji” oznacza, że decyzję musi podjąć człowiek. Jeśli dozwolone jest nadpisywanie istniejących danych, określ, kto może to zrobić i na jakich warunkach.
Zachowaj oryginał i wyjaśnij każdą decyzję
Zapisuj oryginalne dane wiersza osobno od jego znormalizowanych wartości i wyniku walidacji. Takie rozdzielenie pozwala badać rozbieżności — na przykład różnice między otrzymaną datą a jej interpretacją — bez sprowadzania przekształconej wersji do jedynego dostępnego materiału dowodowego.
Struktura przechowywania może obejmować identyfikator partii, numer wiersza, źródło, odwołanie do pliku, oryginalną zawartość, stan, wykryte błędy, daty utworzenia i rozwiązania oraz odpowiedzialnego użytkownika. Zapisuj przyczyny jako stabilne kody i czytelne komunikaty: kod taki jak customer_id_ambiguous ułatwia filtrowanie i analizę przypadków, a komunikat powinien wyjaśniać, które dane należy sprawdzić. Nie opieraj klasyfikacji wyłącznie na dowolnym tekście.
Zachowaj również kontekst niezbędny do odtworzenia analizy: wersję lub identyfikator zastosowanych reguł, zewnętrzny identyfikator i dane istotne dla konfliktu. Nie zapisuj sekretów ani zbędnych danych osobowych w logach technicznych. Określ kontrolę dostępu i okres przechowywania odpowiedni do poziomu wrażliwości danych oraz mających zastosowanie obowiązków. Jeśli cały plik może zawierać informacje niepotrzebne do rozwiązania problemu pojedynczego wiersza, ogranicz ich ekspozycję.
Koryguj dane i ponawiaj przetwarzanie bez powielania skutków
Bezpieczne ponowienie zaczyna się od odróżnienia wiersza od próby jego przetworzenia. Przypisz każdemu wierszowi stabilną tożsamość w jego zakresie, na przykład jako kombinację partii i indeksu wiersza lub zwalidowanego klucza zewnętrznego. W importach, które można powtarzać, zdefiniuj także klucz idempotencji pozwalający rozpoznać tę samą operację. Wybór zależy od tego, czy ponowne wczytanie tego samego pliku ma aktualizować dane, pomijać je czy tworzyć nową wersję.
Podczas przetwarzania wiersza, jeśli to możliwe, wykonuj zapis danych biznesowych i zmianę stanu atomowo: obie operacje są zatwierdzane razem albo żadna z nich. W PHP transakcja bazodanowa może chronić zmiany korzystające z tego samego połączenia; sama z siebie nie zapewnia atomowości wywołania zewnętrznego API. W przypadku efektów zewnętrznych zastosuj strategię zgodną z systemem odbierającym, na przykład klucze idempotencji, transakcyjną tabelę outbox albo mechanizm kompensacyjny zaprojektowany dla danego przypadku.
Po korekcie ponownie uruchom odpowiednie walidacje i zachowaj wcześniejszą historię. Nie usuwaj pierwotnego błędu — dodaj nową próbę wraz z jej wynikiem. Jeśli zmienią się reguły lub dane referencyjne, wskaż zastosowaną wersję i nie dopuszczaj, by ponowienie po cichu zmieniało wcześniej zaakceptowaną decyzję. Ponowne przetwarzanie powinno obejmować tylko wybrane rekordy, a nie uruchamiać bez rozróżnienia całej partii.
Zaprojektuj operacyjny i audytowalny proces weryfikacji
Interfejs weryfikacji powinien pomagać w podejmowaniu decyzji, a nie ograniczać się do wyświetlenia wyjątku technicznego. Pokaż otrzymaną wartość, przyczynę, pole, którego dotyczy problem, istotny kontekst oraz — jeśli jest to bezpieczne — propozycję korekty. Umożliwiaj filtrowanie według stanu, partii, rodzaju błędu i czasu oczekiwania; jasno wskazuj, które wiersze wywołały już skutki, a które nie.
Rejestruj, kto i kiedy zweryfikował przypadek, jaką wartość zmienił, jaką podjął decyzję i z jakiego powodu. Odróżniaj korektę operatora od automatycznego przekształcenia. Przydzielaj uprawnienia stosownie do zakresu odpowiedzialności: osoba, która może zaimportować plik, nie musi mieć prawa zatwierdzania konfliktów ani zmieniania zaakceptowanych rekordów. W przypadku zmian o dużym wpływie rozważ dodatkowe zatwierdzenie.
Nie dopuszczaj, by narzędzie ułatwiało nadpisywanie informacji bez ostrzeżenia. Przed zaakceptowaniem korekty ponownie sprawdź unikalność, uprawnienia i aktualny stan rekordu. Jeśli ktoś zmienił dane od momentu wykrycia konfliktu, pokaż tę informację, aby można było rozstrzygnąć sytuację zamiast stosować nieaktualną aktualizację.
Testuj częściowe awarie i odzyskiwanie
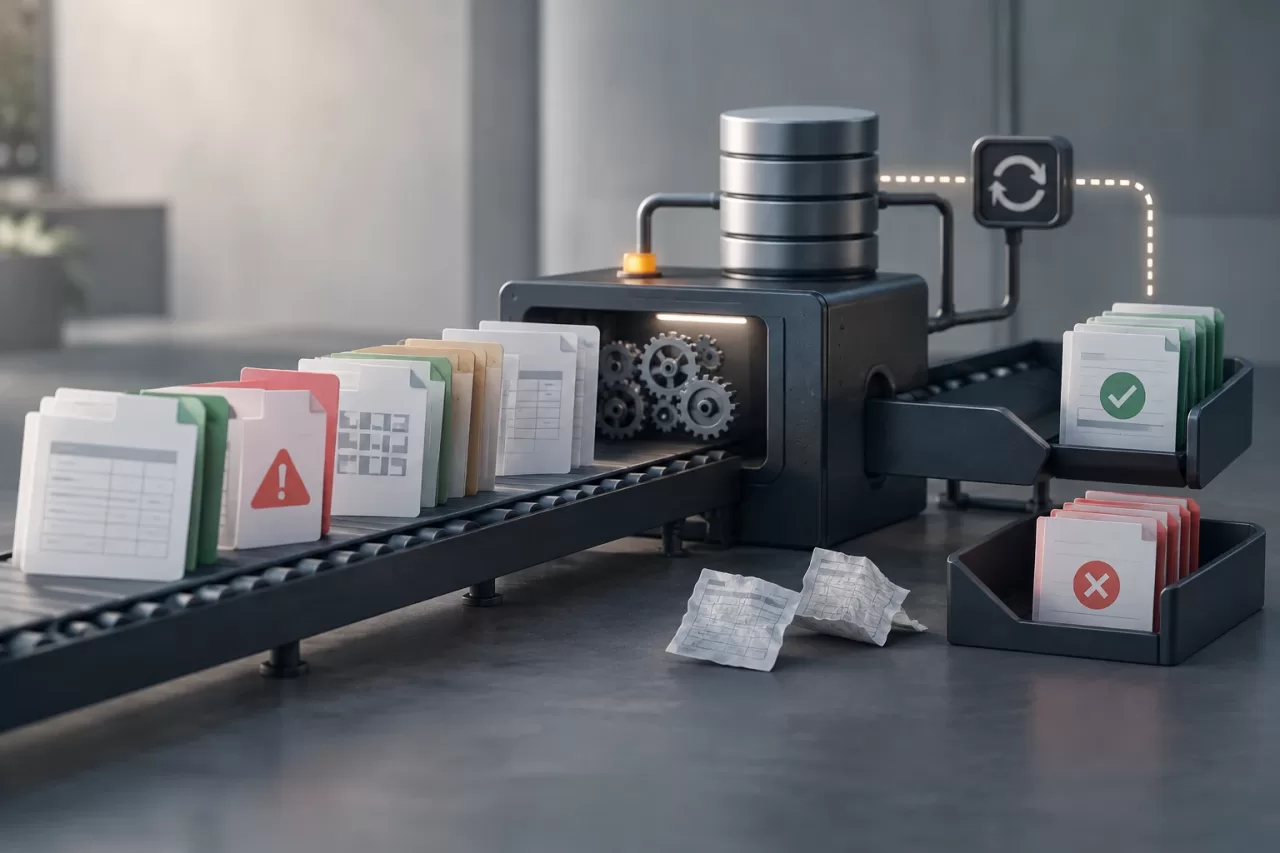
Testy powinny obejmować zarówno reguły, jak i zachowanie przepływu. Uwzględnij pliki z wymieszanymi prawidłowymi i nieprawidłowymi wierszami, nieoczekiwane formaty, konflikty, przejściowe błędy bazy danych i wielokrotne ponowienia. Sprawdź, czy odrzucony wiersz nie blokuje zaakceptowania pozostałych, jeśli tak stanowi uzgodniona polityka, oraz czy awaria wewnątrz transakcji nie pozostawia częściowych skutków.
- Ponowne przetworzenie wiersza z tym samym kluczem idempotencji nie powiela rekordów ani działań zewnętrznych.
- Korekta pola umożliwia ponowną walidację bez usuwania oryginału ani historii.
- Wiersz, który został już zaakceptowany, nie jest ponownie stosowany wskutek ponowienia dotyczącego innego wiersza.
- Konflikty wykryte między weryfikacją a rozwiązaniem nie są po cichu nadpisywane.
- Komunikaty o błędach pozwalają podjąć działanie bez niepotrzebnego ujawniania wrażliwych danych.
W środowisku produkcyjnym monitoruj liczbę i wiek rekordów w kwarantannie, najczęstsze przyczyny, odsetek rozwiązanych przypadków oraz błędy ponownego przetwarzania. Utrzymujący się wzrost może wskazywać na zmianę w systemie źródłowym, nieaktualną regułę lub niejasne instrukcje ładowania danych. Kwarantanna działa wtedy, gdy ujawnia te przyczyny i pozwala je kontrolowanie rozwiązać, a nie gdy staje się bezterminowym składowiskiem wyjątków.