Zastąpienie starszej aplikacji PHP nie wymaga jednorazowego przepisania jej od nowa. Stopniowa wymiana pozwala przenosić obszary działania, gdy firma nadal funkcjonuje, ale sprawdza się tylko wtedy, gdy precyzyjnie określono, który system obsługuje każdą operację i który jest źródłem prawdy dla poszczególnych danych. Bez takich granic obie aplikacje mogą zacząć stosować różne reguły, akceptować niezgodne zapisy i generować wyniki trudne do uzgodnienia.
Celem nie jest bezterminowe utrzymywanie dwóch implementacji równolegle. Chodzi o kontrolowane przenoszenie odpowiedzialności, sprawdzenie, czy nowe rozwiązanie zachowuje wymagane działanie, oraz wycofanie starych zależności, gdy dostępne będą wystarczające dowody. Wymaga to granic funkcjonalnych, obserwowalności, jednego źródła prawdy dla każdej domeny danych oraz uzgodnionych przez zespoły technologiczne i produktowe kryteriów postępu.
Dlaczego równoległe działanie dwóch aplikacji nie wystarczy
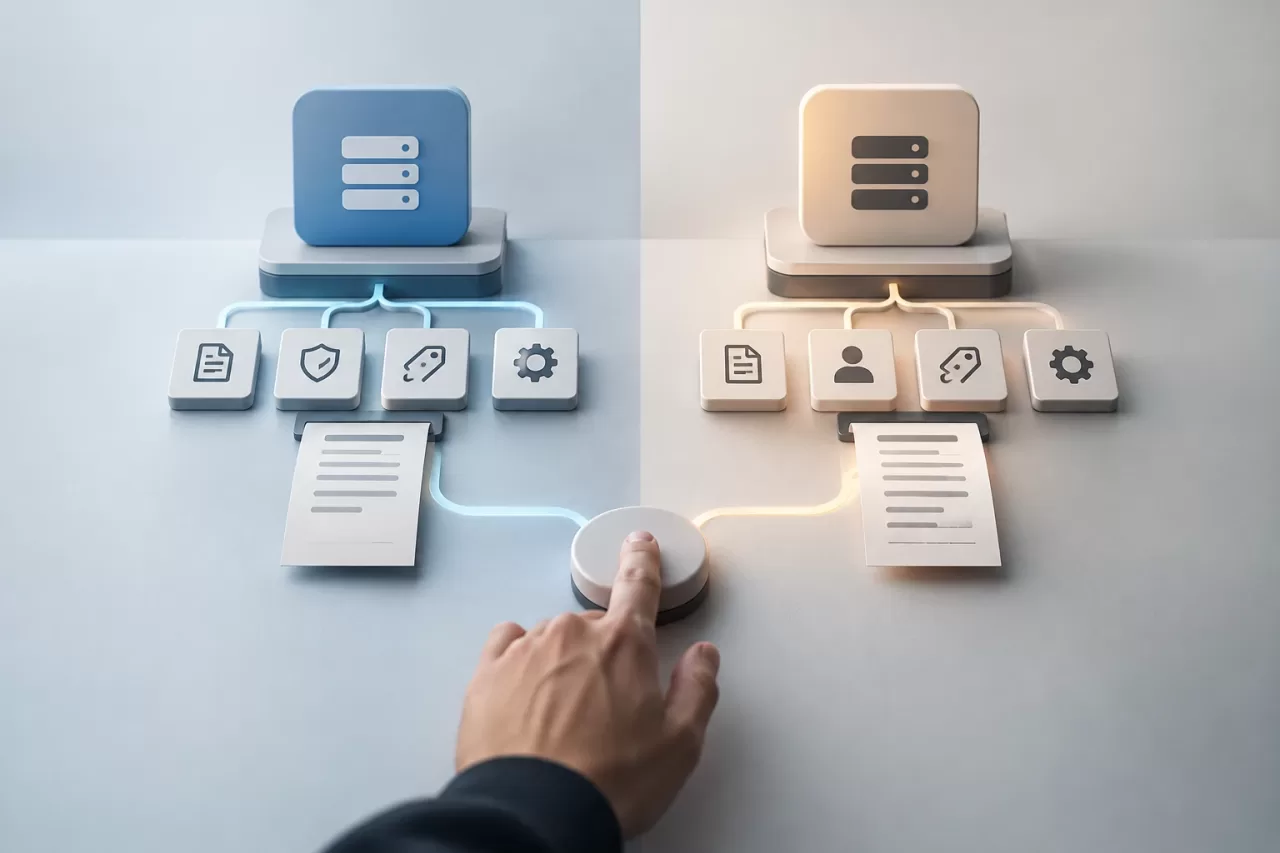
Samo udostępnienie starej i nowej aplikacji nie definiuje migracji. Jeśli obie akceptują tę samą operację, mogą stosować różne reguły dotyczące walidacji, uprawnień, cen, statusów lub efektów ubocznych. Problem często ujawnia się późno: faktura jest obliczana na dwa sposoby, powiadomienie zostaje wysłane dwukrotnie albo zmiana statusu nie jest odzwierciedlona we wszystkich systemach.
Stopniowe zastępowanie systemu legacy w PHP wymaga jednoznacznego opisania, który obszar jest przenoszony, kto otrzymuje żądania i gdzie pozostaje źródło prawdy dla danych. Granica powinna być funkcjonalna, a nie stanowić jedynie listy kontrolerów lub tabel. Zdolność biznesowa taka jak „obsługa zwrotu” może obejmować autoryzację, aktualizację stanu magazynowego i zwrot płatności; podzielenie jej bez zrozumienia tych zależności tworzy mylącą granicę.
Przed zmianą routingu udokumentuj obserwowalne zachowanie: dane wejściowe, wyniki, istotne błędy, uprawnienia, efekty uboczne i zależności zewnętrzne. Odróżnij reguły biznesowe od przypadkowych szczegółów implementacji. Nie każde historyczne zachowanie trzeba zachować, ale każda zamierzona zmiana powinna zostać zatwierdzona i przetestowana jako taka, a nie po cichu przypisana migracji.
Wybór pierwszego obszaru, który można zweryfikować
Pierwszy kandydat nie musi być najmniejszy ani najbardziej widoczny. Warto priorytetowo potraktować obszar o zrozumiałych granicach, rozsądnym poziomie sprzężenia i weryfikowalnym wyniku. Znaczenie ma również wartość operacyjna: migracja może ograniczyć ryzyko, odblokować częste zmiany lub usprawnić obszar, który firma chce rozwijać.
- Sprzężenie: zidentyfikuj wywołania innych modułów, bezpośredni dostęp do współdzielonych tabel, zadania cykliczne i zależności od stanu globalnego. Liczne powiązania nie uniemożliwiają migracji, ale zwiększają koszt wyznaczenia granicy.
- Możliwość weryfikacji: sprawdź, czy można określić reprezentatywne przypadki i zaobserwować wynik bez polegania na subiektywnych interpretacjach.
- Wpływ i odwracalność: oceń, co się stanie w razie awarii danego obszaru oraz czy można wrócić do poprzedniego systemu bez utraty danych lub ponownego wywołania efektów zewnętrznych.
- Gotowość operacyjna: potwierdź, że przed skierowaniem rzeczywistego ruchu są wyznaczeni właściciele, dostępne metryki i procedury badania rozbieżności.
Pomocny będzie krótki spis: obszar, konsumenci, odczytywane i modyfikowane dane, efekty zewnętrzne, właściciel po stronie produktu i właściciel techniczny. Jeśli nie da się ustalić, kto korzysta z danej operacji lub który system aktualizuje dane, najpierw trzeba lepiej poznać system; natychmiastowa migracja nie zmniejszy niepewności.
Określenie routingu i źródła prawdy dla danych
Router powinien jawnie decydować, która implementacja obsługuje żądanie. W zależności od architektury może to być warstwa aplikacji, gateway lub decyzja podejmowana w punkcie wejścia. Najważniejsze, by kryterium było obserwowalne i spójne: według obszaru, klienta, operacji lub kontrolowanej kohorty. Unikaj sytuacji, w której dwie ścieżki mogą przetworzyć to samo zamówienie bez koordynacji.
Dla każdej granicy przypisz właściciela danych lub agregatu. Jeśli na przykład nowy system jest właścicielem zamówień, stary nie powinien nadal modyfikować ich bezpośrednio przez współdzielony dostęp do tabel. Pozostałe komponenty mogą odczytywać dane za pośrednictwem zdefiniowanego interfejsu lub otrzymywać zmiany w postaci zdarzeń — zależnie od wymagań dotyczących spójności. Współdzielenie bazy danych może być etapem przejściowym, ale nie oznacza współdzielenia odpowiedzialności za dane.
Synchronizacja musi jasno określać kierunek i cel. Kopia do odczytu może zasilać raporty lub starszych konsumentów; nie może przypadkowo stać się drugim autorytatywnym miejscem zapisu. Jeśli wymieniane są zdarzenia, określ identyfikatory, kolejność — gdy jest potrzebna — ponowienia, deduplikację i obsługę nieudanych wiadomości. Ustal również, jak wykrywane są opóźnienia synchronizacji i kto rozwiązuje rozbieżności.
Unikanie niejednoznacznych podwójnych zapisów
Zapis do dwóch systemów w trakcie jednego żądania wydaje się prostym sposobem na utrzymanie ich spójności, ale wprowadza częściowe awarie: jeden zapis może się powieść, a drugi nie. Ponowienie żądania może zduplikować operację. Bez strategii zapewniającej idempotencję, uzgadnianie i obsługę błędów nie istnieje jedna transakcja, która zagwarantuje spójność między niezależnymi aplikacjami.
Priorytetem powinno być jedno źródło prawdy dla zapisu każdej operacji. W okresie przejściowym system będący właścicielem może publikować zmiany, aby aktualizować projekcję lub kopię kompatybilności. W procesach asynchronicznych zapisuj zmianę i powiązaną z nią wiadomość w ramach tej samej granicy transakcyjnej, jeśli pozwala na to infrastruktura, a konsumentów projektuj tak, by byli idempotentni. Jeśli z konkretnego ograniczenia wynika konieczność podwójnego zapisu, potraktuj ją jako tymczasowy wyjątek: określ kolejność, możliwe awarie, sposób uzgadniania oraz datę lub warunek jego usunięcia.
Historyczna kopia danych również wymaga określonych zasad. Ustal, jak ładowany jest stan początkowy, jak stosowane są równoległe zmiany i jak weryfikowany jest wynik przed zmianą właściciela. Nie zakładaj, że poprawny import oznacza kompletność powiązań, stanów pochodnych i uprawnień.
Porównywanie działania bez dublowania efektów
Porównywanie ogranicza ryzyko, jeśli odróżnia obliczanie od wykonywania działań. Jedną z metod jest przekazanie kopii danych wejściowych do nowej implementacji w trybie obserwacyjnym i porównanie jej odpowiedzi z odpowiedzią aktywnego systemu, bez umożliwiania kopii wysyłania e-maili, pobierania opłat, zmiany stanu magazynowego ani wywoływania innych efektów zewnętrznych. Takie uruchomienie powinno korzystać z kontrolowanych danych i zależności albo zastępować efekty adapterami, które jedynie rejestrują zamiar ich wykonania.
Porównuj wyniki pod względem semantycznym: statusy, kwoty, decyzje i istotne błędy, a niekoniecznie kolejność pól czy znaczniki czasu. Korzystaj z reprezentatywnych przypadków obejmujących wartości graniczne, niekompletne dane, uprawnienia i awarie zależności. Dodaj automatyczne testy krytycznych reguł, a gdy rzeczywiste dane nie nadają się do oceny, zachowaj zanonimizowane lub syntetyczne przykłady.
Uruchomienie w trybie shadow samo w sobie nie dowodzi, że nowy system może działać. Może nie odtwarzać latencji, współbieżności ani rzeczywistych integracji, a rozbieżność może wskazywać zarówno na defekt, jak i na nieudokumentowaną starą regułę. Każda rozbieżność wymaga klasyfikacji, przypisania właściciela i rozstrzygnięcia: poprawienia błędu, zaakceptowania zatwierdzonej zmiany albo wykluczenia przypadku z możliwym do zweryfikowania uzasadnieniem.
Monitorowanie postępu i przygotowanie procedury powrotu
Rejestruj wybraną ścieżkę, wersję implementacji, identyfikator korelacji i wynik każdej operacji. Mierz błędy, latencję, ponowienia, opóźnienia synchronizacji i rozbieżności, z podziałem na obszary. Unikaj rejestrowania zbędnych sekretów i danych osobowych; określ kontrolę dostępu i okres przechowywania logów.
Przed zwiększeniem skali kierowania ruchu uzgodnij progi zatrzymania i osoby uprawnione do wstrzymania postępu. Powrót do poprzedniego systemu nie zawsze oznacza zmianę routingu: jeśli nowy system zdążył już przyjąć zapisy, stara aplikacja może nie mieć najnowszego stanu. Procedura musi określać sposób obsługi trwających operacji, oczekujących wiadomości i zapisanych danych; przećwicz ją w odpowiednim środowisku. Odwracalność zależy od stanu i efektów, a nie tylko od opcji konfiguracyjnej.
Wycofanie starego systemu na podstawie weryfikowalnych kryteriów
Decyzja o wycofaniu powinna opierać się na dowodach, a nie wyłącznie na ustalonej dacie. W przypadku danego obszaru potwierdź, że wszystkie planowane ścieżki prowadzą do nowego właściciela; krytyczne operacje i ich przypadki błędów są objęte testami; konsumenci i zadania cykliczne przestały zależeć od starego komponentu; oraz nie pozostały bezpośrednie zapisy ani procesy uzgadniania bez przypisanego właściciela.
Następnie obserwuj działanie przez okres uzgodniony z zespołami produktu i operacji, uwzględniając obciążenie oraz cykle istotne dla danego obszaru. Przed usunięciem komponentów zweryfikuj oczekujące dane, kopie kompatybilności oraz wymagania audytowe i retencyjne. Zaktualizuj dokumentację, alerty i procedury wsparcia. Utrzymywanie starego elementu „na wszelki wypadek” również ma swoją cenę: może zachować uprawnienia, podatności i ścieżki zapisu, które utrudniają ustalenie odpowiedzialności.
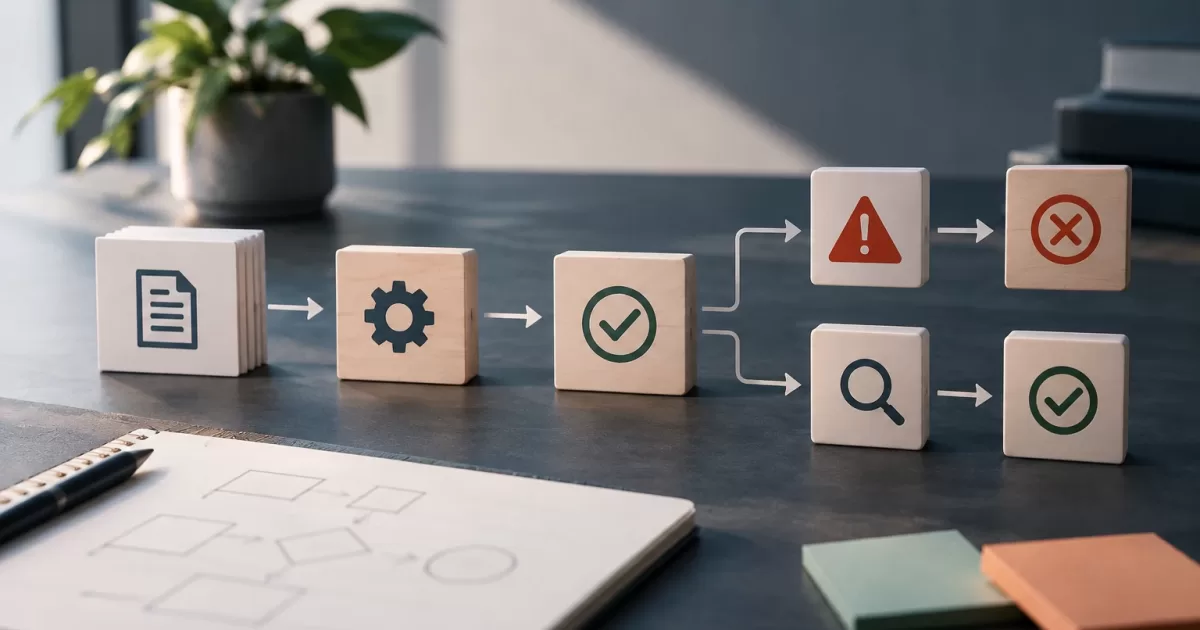
Praktyczna sekwencja wygląda następująco: wyznaczenie granic obszaru, przypisanie źródła prawdy dla danych, udokumentowanie zachowania, przygotowanie testów i obserwowalności, załadowanie lub synchronizacja danych, porównanie bez efektów ubocznych, stopniowe kierowanie ruchu, przegląd wyników i wycofanie zależności po uzyskaniu jawnej akceptacji. Jeśli etap nie ma kryteriów akceptacji lub przypisanego właściciela, migracja nie jest jeszcze gotowa do dalszego postępu.