Sostituire un’applicazione PHP legacy non richiede una riscrittura in un’unica soluzione. Una sostituzione graduale consente di trasferire funzionalità mentre l’attività continua a operare, ma funziona solo se si decide con precisione quale sistema gestisce ogni operazione e quale detiene l’autorità su ciascun dato. Senza questi confini, le due applicazioni possono finire per eseguire regole diverse, accettare scritture incompatibili e generare risultati difficili da riconciliare.
L’obiettivo non è mantenere indefinitamente due implementazioni in parallelo. È trasferire le responsabilità in modo controllato, verificare che la nuova soluzione preservi il comportamento necessario e ritirare le dipendenze obsolete quando ci sono prove sufficienti. Servono quindi confini funzionali, osservabilità, un’unica fonte di verità per ciascun dominio di dati e criteri di avanzamento concordati da tecnologia e prodotto.
Perché avere due applicazioni in parallelo non basta
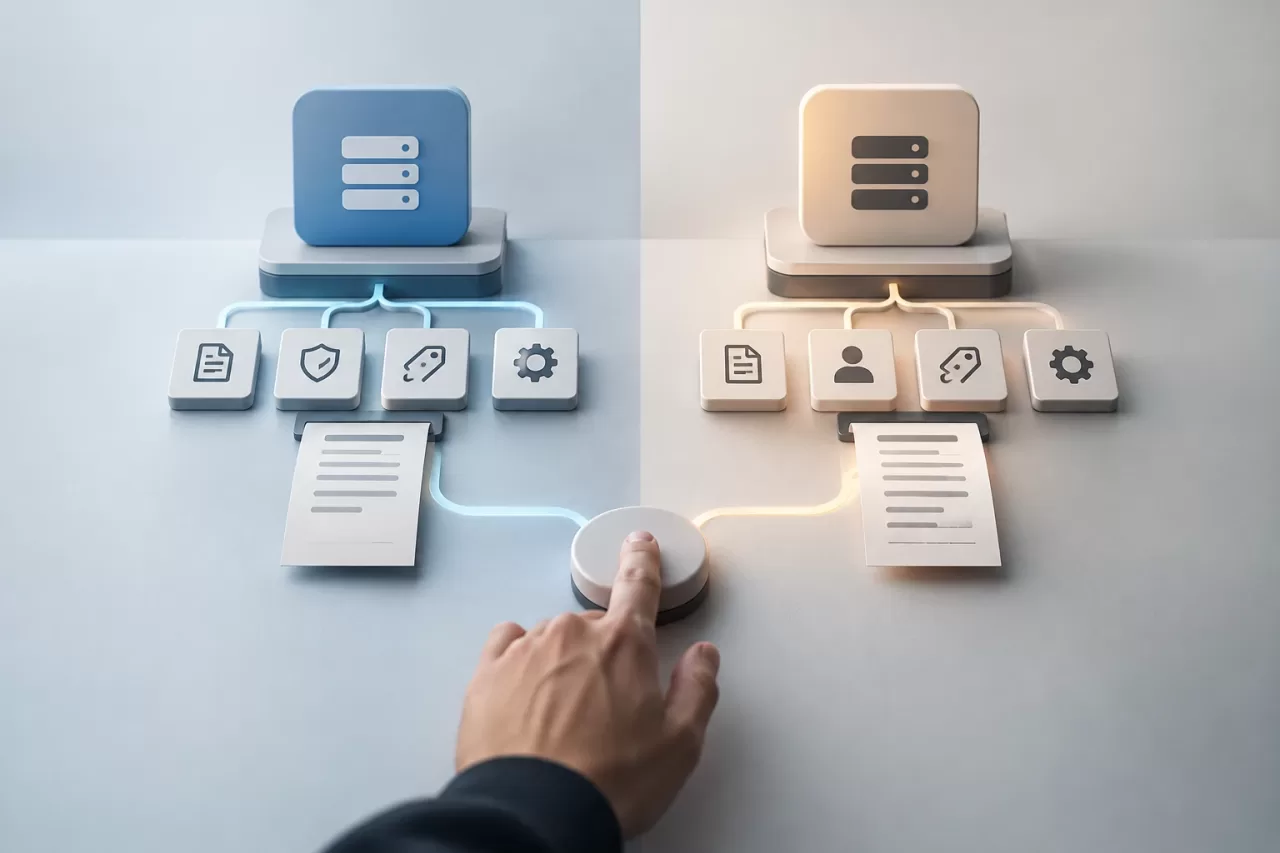
La disponibilità di un’applicazione vecchia e di una nuova non definisce una migrazione. Se entrambe accettano la stessa operazione, possono applicare regole diverse a convalide, autorizzazioni, prezzi, stati o effetti collaterali. Spesso il problema emerge tardi: una fattura viene calcolata in due modi, una notifica viene inviata due volte oppure una modifica di stato non si riflette in tutti i sistemi.
Una sostituzione graduale di un sistema legacy in PHP deve descrivere esplicitamente quale funzionalità viene trasferita, chi riceve le richieste e dove risiede l’autorità sui dati. Il confine deve essere funzionale, non semplicemente un elenco di controller o tabelle. Una funzionalità come “gestire un reso” può comportare autorizzazione, aggiornamento dell’inventario e rimborso; suddividerla senza comprenderne le dipendenze crea un confine ingannevole.
Prima di modificare il routing, documenta il comportamento osservabile: input, output, errori rilevanti, autorizzazioni, effetti collaterali e dipendenze esterne. Distingui le regole di business dai dettagli accidentali dell’implementazione. Non è necessario preservare ogni comportamento storico, ma qualsiasi modifica intenzionale deve essere approvata e testata come tale, non attribuita tacitamente alla migrazione.
Scegliere una prima funzionalità verificabile
La prima candidata non deve necessariamente essere la più piccola o la più visibile. È opportuno dare priorità a una funzionalità con confini comprensibili, accoppiamento ragionevole e risultati verificabili. Conta anche il valore operativo: una migrazione può ridurre un rischio, sbloccare modifiche frequenti o migliorare una parte che l’attività deve poter far evolvere.
- Accoppiamento: individua le chiamate ad altri moduli, l’accesso diretto a tabelle condivise, le attività pianificate e le dipendenze dallo stato globale. Molti collegamenti non impediscono la migrazione, ma aumentano il costo di definizione del confine.
- Verificabilità: controlla se è possibile formulare casi rappresentativi e osservarne il risultato senza dipendere da interpretazioni soggettive.
- Impatto e reversibilità: valuta cosa accade se la funzionalità non funziona e se è possibile tornare al percorso precedente senza perdere dati né ripetere effetti esterni.
- Preparazione operativa: verifica che siano disponibili responsabili, metriche e procedure per indagare le discrepanze prima di esporre il traffico reale.
È utile preparare un breve inventario: funzionalità, consumer, dati letti e modificati, effetti esterni, responsabile di prodotto e responsabile tecnico. Se non è possibile sapere chi usa un’operazione o quale sistema aggiorna un dato, occorre prima migliorare la conoscenza del sistema; migrarla subito non riduce l’incertezza.
Definire il routing e l’autorità sui dati
Il router deve decidere esplicitamente quale implementazione gestisce una richiesta. A seconda dell’architettura, può trattarsi di un livello applicativo, di un gateway o di una decisione presa nel punto di ingresso. L’importante è che il criterio sia osservabile e coerente: per funzionalità, cliente, operazione o coorte controllata. Evita che due percorsi possano elaborare lo stesso ordine senza coordinamento.
Per ogni confine, assegna un proprietario per ciascun dato o aggregato. Se, ad esempio, il nuovo sistema è proprietario degli ordini, quello vecchio non dovrebbe continuare a modificarli direttamente tramite l’accesso condiviso alle tabelle. Gli altri componenti possono consultare un’interfaccia definita oppure ricevere le modifiche tramite eventi, a seconda delle esigenze di coerenza. La condivisione di un database può essere una fase transitoria, ma non equivale a condividere l’autorità.
La sincronizzazione deve dichiarare direzione e finalità. Una copia in sola lettura può alimentare report o consumer legacy; non deve diventare accidentalmente una seconda fonte autorizzata per le scritture. Se si scambiano eventi, definisci identificatori, ordinamento quando necessario, nuovi tentativi, deduplicazione e gestione dei messaggi non riusciti. Chiarisci anche come vengono rilevati i ritardi e chi risolve le divergenze.
Evitare scritture doppie ambigue
Scrivere in due sistemi durante una richiesta sembra un modo semplice per mantenerli allineati, ma introduce errori parziali: una scrittura può riuscire e l’altra no. Ripetere la richiesta potrebbe duplicare un’operazione. Senza una strategia di idempotenza, riconciliazione e gestione degli errori, non esiste una transazione unica che garantisca la coerenza tra applicazioni indipendenti.
Dai priorità a un’unica autorità di scrittura per ogni operazione. Durante una transizione, il sistema proprietario può pubblicare le modifiche per aggiornare una proiezione o una copia di compatibilità. Per i processi asincroni, registra in modo affidabile la modifica e il relativo messaggio entro lo stesso confine transazionale, quando l’infrastruttura lo consente, e progetta consumer idempotenti. Se un vincolo specifico rende necessaria la scrittura duale, trattala come un’eccezione temporanea: specifica l’ordine, i possibili errori, la riconciliazione e la data o la condizione per eliminarla.
Anche una copia dei dati storici richiede regole. Definisci come caricare lo stato iniziale, applicare le modifiche concorrenti e verificare il risultato prima di cambiare il proprietario. Non presumere che un’importazione riuscita implichi la completezza di relazioni, stati derivati e autorizzazioni.
Confrontare il comportamento senza duplicare gli effetti
Il confronto riduce il rischio se distingue il calcolo dall’esecuzione. Una tecnica consiste nell’inviare una copia dell’input alla nuova implementazione in modalità osservazione e confrontarne la risposta con quella del sistema attivo, senza consentire alla copia di inviare email, addebitare pagamenti, modificare l’inventario o invocare altri effetti esterni. L’esecuzione deve usare dati e dipendenze controllati oppure sostituire gli effetti con adapter che si limitano a registrare l’intenzione.
Confronta i risultati semanticamente: stati, importi, decisioni ed errori rilevanti, non necessariamente l’ordine dei campi o i timestamp. Usa casi rappresentativi che includano valori limite, dati incompleti, autorizzazioni ed errori delle dipendenze. Aggiungi test automatizzati per le regole critiche e conserva esempi anonimizzati o sintetici quando i dati reali non sono adatti alla valutazione.
L’esecuzione in shadow non dimostra da sola che il nuovo sistema sia in grado di operare. Potrebbe non riprodurre latenza, concorrenza o integrazioni reali, e una differenza può rivelare tanto un difetto quanto una vecchia regola non documentata. Ogni discrepanza richiede una classificazione, un responsabile e una risoluzione: correggerla, accettare una modifica approvata oppure escludere il caso per un motivo verificabile.
Monitorare l’avanzamento e preparare il rollback
Registra il percorso scelto, la versione dell’implementazione, l’identificativo di correlazione e il risultato di ogni operazione. Misura errori, latenza, nuovi tentativi, ritardi di sincronizzazione e discrepanze, suddividendoli per funzionalità. Evita di registrare segreti o dati personali non necessari; definisci controlli di accesso e tempi di conservazione dei log.
Prima di aumentare l’esposizione, concorda le soglie di arresto e chi può fermare l’avanzamento. Un rollback non significa sempre modificare il routing: se il nuovo sistema ha già accettato scritture, tornare all’applicazione vecchia può lasciarla priva dello stato più recente. La procedura deve indicare cosa fare con le operazioni in corso, i messaggi in sospeso e i dati scritti; provala in un ambiente adeguato. La reversibilità dipende dallo stato e dagli effetti, non solo da un’opzione di configurazione.
Dismettere il sistema precedente in base a condizioni verificabili
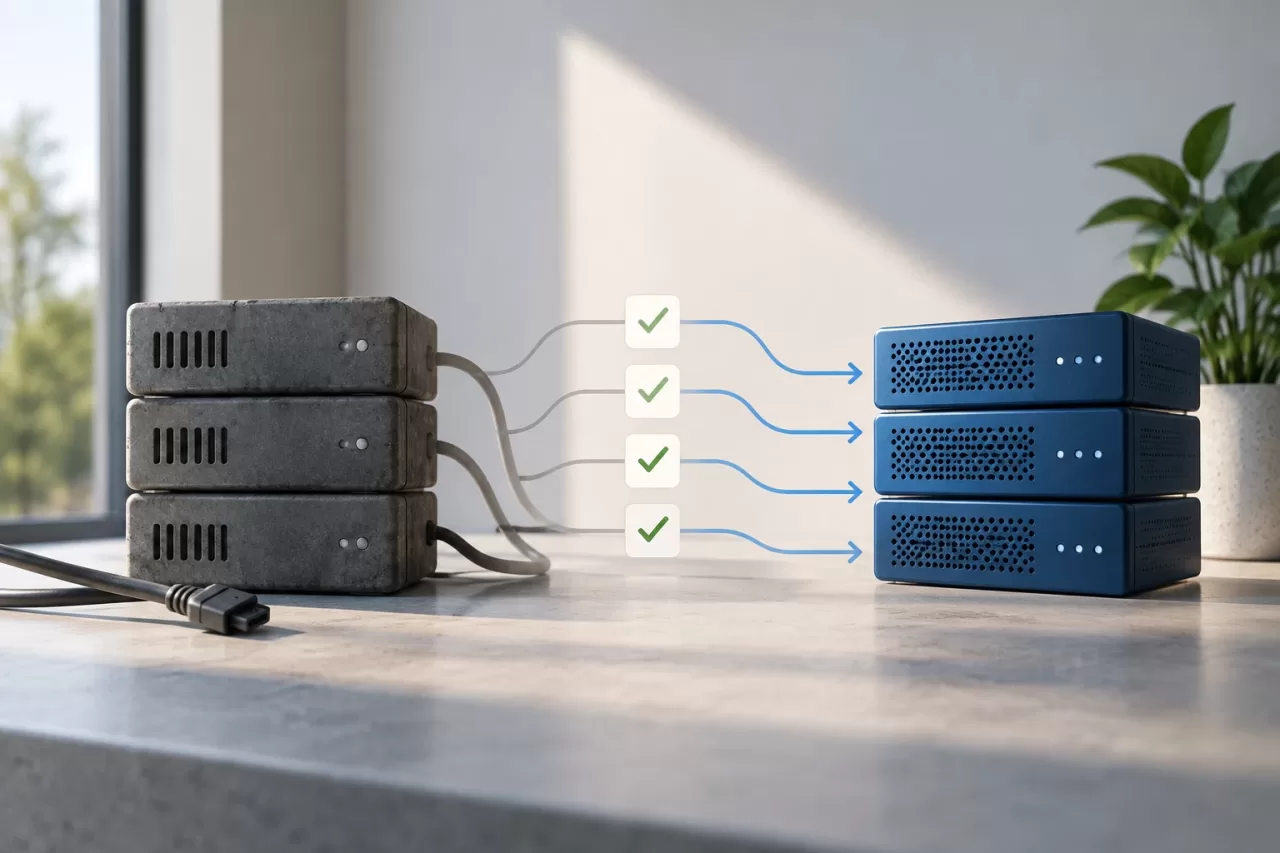
La dismissione deve basarsi su prove, non su una data isolata. Per una funzionalità, verifica che tutti i percorsi previsti arrivino al nuovo proprietario; che le operazioni critiche e i relativi casi di errore siano coperti; che consumer e attività pianificate non dipendano più dal componente vecchio; e che non rimangano scritture dirette o processi di riconciliazione senza responsabile.
Successivamente, osserva il funzionamento per un periodo concordato con i team di prodotto e operations, tenendo conto del carico e dei cicli rilevanti per quella funzionalità. Verifica i dati in sospeso, le copie di compatibilità e i requisiti di audit o conservazione prima di eliminare i componenti. Aggiorna la documentazione, gli alert e le procedure di supporto. Anche mantenere un componente vecchio “per ogni evenienza” ha un costo: può conservare autorizzazioni, vulnerabilità e percorsi di scrittura che rendono poco chiara la proprietà.
Una sequenza pratica è: delimitare la funzionalità, assegnare l’autorità sui dati, documentare il comportamento, preparare test e osservabilità, caricare o sincronizzare i dati, confrontare senza effetti collaterali, instradare un’esposizione controllata, esaminare i risultati e ritirare le dipendenze previa approvazione esplicita. Se una fase non ha criteri di accettazione o un responsabile, la migrazione non è ancora pronta per avanzare.