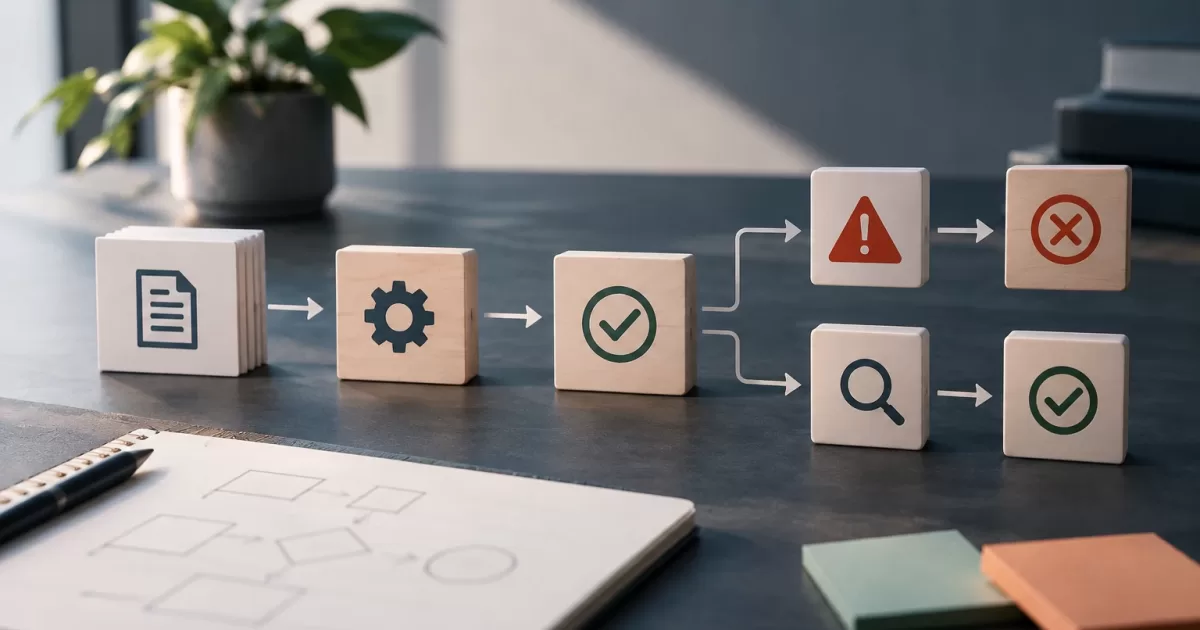
Remplacer une application PHP héritée n’exige pas de la réécrire d’un seul coup. Un remplacement progressif permet de transférer des fonctionnalités tout en maintenant l’activité de l’entreprise, mais il ne fonctionne que si l’on définit précisément quel système traite chaque opération et lequel fait autorité pour chaque donnée. Sans ces limites, les deux applications risquent d’appliquer des règles différentes, d’accepter des écritures incompatibles et de produire des résultats difficiles à rapprocher.
L’objectif n’est pas de maintenir indéfiniment deux implémentations en parallèle. Il s’agit de transférer les responsabilités de manière contrôlée, de vérifier que la nouvelle solution préserve le comportement nécessaire et de retirer les anciennes dépendances lorsque les éléments de preuve sont suffisants. Pour cela, il faut des frontières fonctionnelles, de l’observabilité, une source de vérité par domaine de données et des critères d’avancement convenus par les équipes techniques et produit.
Pourquoi deux applications en parallèle ne suffisent pas
La disponibilité d’une ancienne application et d’une nouvelle ne définit pas une migration. Si les deux acceptent la même opération, elles peuvent appliquer des règles différentes en matière de validations, d’autorisations, de tarifs, d’états ou d’effets secondaires. Le problème apparaît souvent tardivement : une facture est calculée de deux façons, une notification est envoyée deux fois ou un changement d’état n’est pas répercuté dans tous les systèmes.
Le remplacement progressif d’un système PHP hérité nécessite de décrire explicitement quelle fonctionnalité est transférée, qui reçoit les requêtes et où réside l’autorité sur les données. La frontière doit être fonctionnelle, et non se réduire à une simple liste de contrôleurs ou de tables. Une fonctionnalité comme « gérer un retour » peut impliquer une autorisation, une mise à jour des stocks et un remboursement ; la découper sans comprendre ces dépendances crée une frontière trompeuse.
Avant de modifier le routage, documentez le comportement observable : entrées, sorties, erreurs pertinentes, autorisations, effets secondaires et dépendances externes. Distinguez les règles métier des détails accidentels de l’implémentation. Il n’est pas nécessaire de préserver tous les comportements historiques, mais toute modification intentionnelle doit être approuvée et testée en tant que telle, et non attribuée silencieusement à la migration.
Choisir une première fonctionnalité vérifiable
La première candidate n’a pas besoin d’être la plus petite ni la plus visible. Il est préférable de privilégier une fonctionnalité dont les limites sont compréhensibles, le couplage raisonnable et le résultat vérifiable. La valeur opérationnelle compte aussi : une migration peut réduire un risque, débloquer des changements fréquents ou améliorer une partie que l’entreprise doit faire évoluer.
- Couplage : identifiez les appels à d’autres modules, l’accès direct à des tables partagées, les tâches planifiées et les dépendances à un état global. De nombreux liens n’empêchent pas la migration, mais augmentent le coût de définition de la frontière.
- Vérifiabilité : vérifiez s’il est possible de formuler des cas représentatifs et d’observer le résultat sans dépendre d’interprétations subjectives.
- Impact et réversibilité : évaluez ce qui se passe en cas de défaillance de la fonctionnalité et s’il est possible de revenir à la route précédente sans perdre de données ni répéter des effets externes.
- Préparation opérationnelle : vérifiez que des responsables, des métriques et des procédures sont disponibles pour enquêter sur les écarts avant d’exposer la fonctionnalité au trafic réel.
Un inventaire succinct est utile : fonctionnalité, consommateurs, données lues et modifiées, effets externes, responsable produit et responsable technique. S’il est impossible de savoir qui utilise une opération ou quel système met à jour une donnée, il faut d’abord améliorer la connaissance du système ; la migrer immédiatement ne réduit pas l’incertitude.
Définir le routage et l’autorité sur les données
Le routeur doit déterminer explicitement quelle implémentation traite une requête. Selon l’architecture, il peut s’agir d’une couche applicative, d’une passerelle ou d’une décision prise au point d’entrée. L’essentiel est que le critère soit observable et cohérent : par fonctionnalité, client, opération ou cohorte contrôlée. Évitez que deux routes puissent traiter la même commande sans coordination.
À chaque frontière, attribuez un propriétaire à chaque donnée ou agrégat. Si le nouveau système est propriétaire des commandes, par exemple, l’ancien ne devrait pas continuer à les modifier directement en accédant à des tables partagées. Les autres composants peuvent interroger une interface définie ou recevoir les modifications par événements, selon les besoins de cohérence. Le partage d’une base de données peut constituer une étape de transition, mais il ne signifie pas que l’autorité est partagée.
La synchronisation doit en préciser la direction et l’objectif. Une copie en lecture peut alimenter des rapports ou d’anciens consommateurs ; elle ne doit pas devenir accidentellement une deuxième source d’écriture autorisée. Si des événements sont échangés, définissez les identifiants, l’ordre lorsque nécessaire, les nouvelles tentatives, la déduplication et le traitement des messages en échec. Précisez également comment les retards sont détectés et qui résout les divergences.
Éviter les doubles écritures ambiguës
Écrire dans deux systèmes pendant une requête semble être un moyen simple de les maintenir alignés, mais cela introduit des défaillances partielles : une écriture peut réussir tandis que l’autre échoue. Répéter la requête risque de dupliquer une opération. Sans stratégie d’idempotence, de rapprochement et de gestion des erreurs, aucune transaction unique ne garantit la cohérence entre des applications indépendantes.
Privilégiez une seule autorité d’écriture pour chaque opération. Pendant une transition, le système propriétaire peut publier les modifications afin de mettre à jour une projection ou une copie de compatibilité. Pour les processus asynchrones, enregistrez de manière fiable la modification et son message dans une même frontière transactionnelle lorsque l’infrastructure le permet, et concevez des consommateurs idempotents. Si une contrainte particulière rend les doubles écritures nécessaires, traitez-les comme une exception temporaire : précisez l’ordre, les défaillances possibles, le rapprochement et la date ou la condition de suppression.
Une copie de données historiques nécessite également des règles. Définissez comment l’état initial est chargé, comment les modifications concurrentes sont appliquées et comment le résultat est vérifié avant de transférer la propriété. Ne supposez pas qu’une importation réussie signifie que les relations, les états dérivés et les autorisations sont complets.
Comparer les comportements sans dupliquer les effets
La comparaison réduit les risques si elle distingue le calcul de l’exécution. Une technique consiste à envoyer une copie de l’entrée à la nouvelle implémentation en mode observation et à comparer sa réponse à celle du système actif, sans permettre à cette copie d’envoyer des e-mails, d’encaisser un paiement, de modifier les stocks ni de déclencher d’autres effets externes. Cette exécution doit utiliser des données et des dépendances contrôlées, ou remplacer les effets par des adaptateurs qui consignent uniquement l’intention.
Comparez les résultats sur le plan sémantique : états, montants, décisions et erreurs pertinentes, et pas nécessairement l’ordre des champs ou les horodatages. Utilisez des cas représentatifs incluant des valeurs limites, des données incomplètes, des autorisations et des défaillances de dépendances. Ajoutez des tests automatisés pour les règles critiques et conservez des exemples anonymisés ou synthétiques lorsque les données réelles ne conviennent pas à l’évaluation.
L’exécution en mode miroir ne prouve pas à elle seule que le nouveau système peut fonctionner en production. Elle peut ne pas reproduire les latences, la concurrence ou les intégrations réelles, et un écart peut révéler aussi bien un défaut qu’une règle ancienne non documentée. Chaque divergence doit être classée, attribuée à un responsable et résolue : corriger, accepter une modification approuvée ou exclure le cas pour une raison vérifiable.
Instrumenter l’avancement et préparer le retour arrière
Consignez la route choisie, la version de l’implémentation, l’identifiant de corrélation et le résultat de chaque opération. Mesurez les erreurs, la latence, les nouvelles tentatives, les retards de synchronisation et les divergences, par fonctionnalité. Évitez de consigner des secrets ou des données personnelles inutiles ; définissez des contrôles d’accès et des durées de conservation pour les journaux.
Avant d’augmenter l’exposition, convenez de seuils d’arrêt et déterminez qui peut interrompre l’avancement. Un retour arrière ne consiste pas toujours à modifier le routage : si le nouveau système a déjà accepté des écritures, revenir à l’ancienne application peut la priver de l’état le plus récent. La procédure doit indiquer quoi faire des opérations en cours, des messages en attente et des données écrites ; répétez-la dans un environnement adapté. La réversibilité dépend de l’état et des effets, pas seulement d’une option de configuration.
Retirer l’ancien système selon des conditions vérifiables
Le retrait doit reposer sur des éléments probants, et non sur une date isolée. Pour une fonctionnalité, confirmez que toutes les routes prévues aboutissent au nouveau propriétaire ; que les opérations critiques et leurs cas d’erreur sont couverts ; que les consommateurs et les tâches planifiées ne dépendent plus de l’ancien composant ; et qu’il ne subsiste ni écritures directes ni processus de rapprochement sans responsable.
Ensuite, observez le fonctionnement pendant une période convenue avec les équipes produit et opérations, en tenant compte de la charge et des cycles pertinents pour cette fonctionnalité. Vérifiez les données en attente, les copies de compatibilité et les exigences d’audit ou de conservation avant de supprimer des composants. Mettez à jour la documentation, les alertes et les procédures de support. Conserver un élément ancien « au cas où » a aussi un coût : il peut maintenir des autorisations, des vulnérabilités et des routes d’écriture qui brouillent la propriété.
Une séquence pratique consiste à : délimiter la fonctionnalité, attribuer l’autorité sur les données, documenter le comportement, préparer les tests et l’observabilité, charger ou synchroniser les données, comparer sans effets secondaires, router une exposition contrôlée, examiner les résultats et retirer les dépendances avec une approbation explicite. Si une étape n’a ni critères d’acceptation ni responsable, la migration n’est pas encore prête à avancer.