Gdy zawiedzie wieloetapowy proces, ponowne uruchomienie go od początku może powtórzyć efekty, które już wystąpiły: utworzyć dwa zamówienia, wysłać dwa powiadomienia lub zaimportować ten sam rekord dwukrotnie. Częściowe odzyskiwanie nieudanych procesów PHP polega na ustaleniu, które kroki zostały potwierdzone, które można bezpiecznie powtórzyć, a które wymagają kompensacji lub weryfikacji przez człowieka.
Decyzja zależy od semantyki każdej operacji, a nie tylko od miejsca wystąpienia wyjątku. Na przykład brak odpowiedzi API nie dowodzi, że system zewnętrzny odrzucił żądanie. Proces mógł zakończyć się powodzeniem, a połączenie mogło zostać przerwane, zanim PHP otrzymało wynik. Projektowanie z myślą o takim przypadku pozwala uniknąć pomylenia przerwanego wykonania z niewykonanym procesem.
Wybór między ponowieniem, wznowieniem i kompensacją
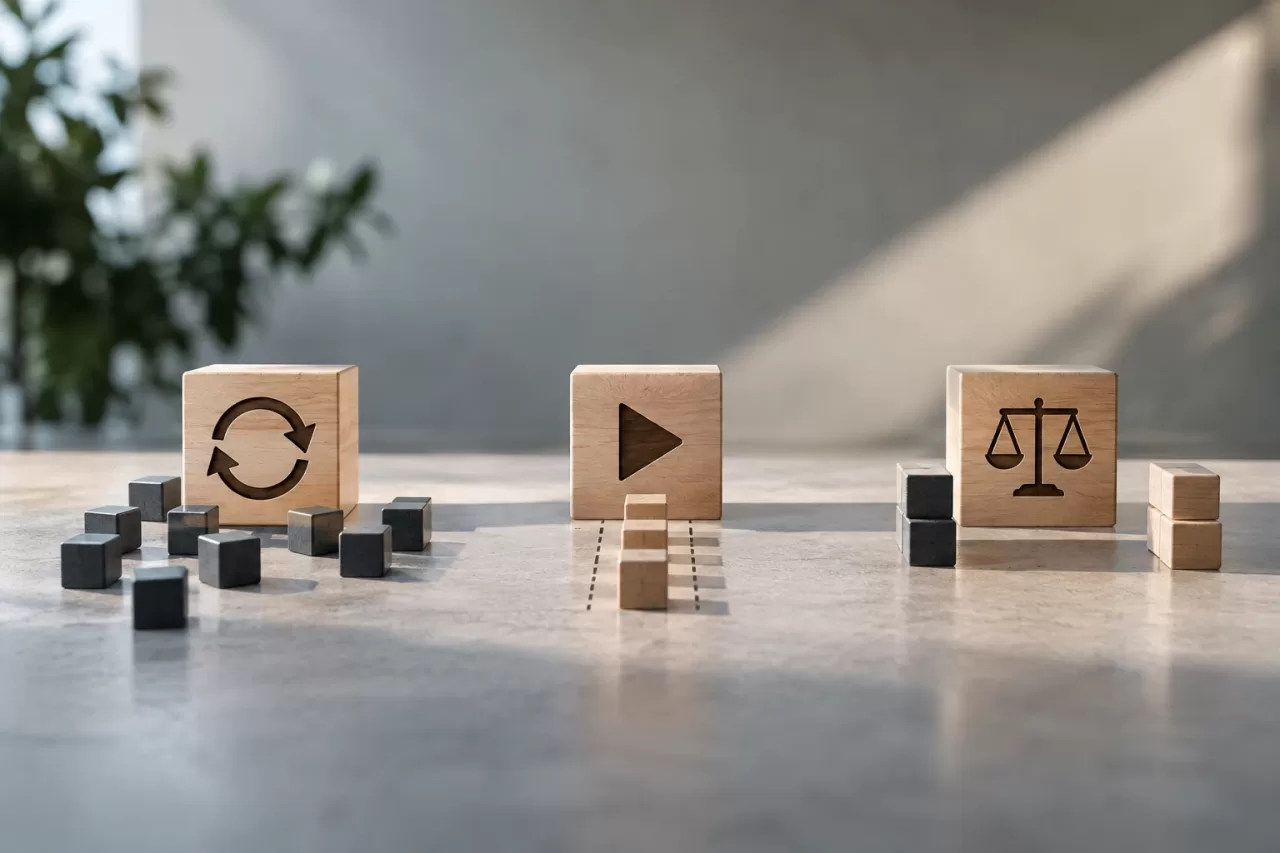
Pełne ponowienie uruchamia ponownie wszystkie kroki. Jest właściwe, gdy cały przepływ jest idempotentny — jego powtórzenie pozostawia taki sam stan końcowy — lub gdy nie wystąpiły jeszcze żadne efekty zewnętrzne. Jeśli nie można zagwarantować żadnego z tych warunków, ponowienie bez sprawdzenia jest ryzykowne.
Wznowienie oznacza kontynuację od pierwszego niepotwierdzonego kroku. Wymaga rejestrowania stanu kroków i ich wyników, a także możliwości odzyskania lub weryfikacji efektu wywołania o niejednoznacznym wyniku. Nie oznacza pomijania wszystkiego, co wydaje się ukończone: potrzebne są utrwalone dowody.
Kompensacja polega na wykonaniu działania, które neutralizuje wcześniejszy efekt, na przykład anulowaniu rezerwacji. Nie zawsze przywraca dokładnie pierwotny stan: wysłanego powiadomienia nie da się cofnąć, a pobrana płatność może wymagać zwrotu z własnym terminem i rejestrem. Dlatego kompensacja jest jawną operacją biznesową, a nie automatycznym rollbackiem bazy danych.
Modelowanie kroków przy użyciu utrwalanych stanów i wyników
Przedstaw przepływ jako sekwencję lub maszynę stanów, której kroki mają stabilne nazwy, identyfikowalne dane wejściowe i utrwalane wyniki. Początkowy model może obejmować stany takie jak pending, running, succeeded, retryable, failed i manual_review. Zdefiniuj dozwolone przejścia i nie pozwól, aby proces zmienił stan na końcowy bez zapisania wymaganych dowodów.
Rekord procesu może zawierać stabilny identyfikator, typ przepływu, stan globalny, wersję definicji procesu, daty rozpoczęcia i aktualizacji, numer próby oraz powód ostatniego przejścia. Dla każdego kroku należy zapisać jego stan, identyfikator operacji, znaczniki czasu i odwołanie do istotnego wyniku. Utrwalaj tylko informacje potrzebne do wznowienia procesu lub wyjaśnienia wyniku; nie kopiuj bez potrzeby pełnych odpowiedzi API ani sekretów.
W PHP koordynator może oddzielać zmianę stanu od wykonania kroku. Aktualizacja musi być atomowa, gdy to samo zadanie może przejąć wielu workerów: użyj transakcji lub odpowiedniego mechanizmu blokowania i zapisuj, kto przejął proces oraz do kiedy. Wygasająca blokada powinna umożliwiać odzyskanie porzuconych zadań, ale nie może oznaczać jako ukończonego kroku, który pozostał w trakcie.
Definiowanie punktów kontrolnych bez zakładania „dokładnie raz”
Zapisuj punkt kontrolny po każdym wyniku, który system może wiarygodnie potwierdzić. W przypadku operacji lokalnych może to być transakcja zapisująca jednocześnie zmianę biznesową i stan kroku. W przypadku wywołania zewnętrznego nie ma wspólnej transakcji między bazą danych a dostawcą: proces może zatrzymać się po wykonaniu działania przez dostawcę, ale przed zapisaniem odpowiedzi przez PHP.
W takiej sytuacji użyj klucza idempotencji, jeśli dostawca go obsługuje; utwórz go na podstawie stabilnego identyfikatora procesu i kroku. Jeśli dostawca nie obsługuje takiego klucza, przed ponowieniem żądania sprawdź zdalny stan za pomocą identyfikatora operacji. Gdy nie ma ani idempotencji, ani wiarygodnej metody sprawdzenia, potraktuj wynik jako niejednoznaczny i skieruj sprawę do weryfikacji. Sam timeout nie wystarcza, by stwierdzić, że operacja nie została wykonana.
W przypadku zadań asynchronicznych transakcyjny wzorzec outbox pozwala zapisać lokalną zmianę i oczekującą wiadomość w ramach jednej transakcji. Worker dostarcza później wiadomość; konsument również musi tolerować duplikaty, na przykład zapisując identyfikatory już przetworzonych wiadomości. Mechanizmy te ograniczają niespójności, ale nie sprawiają automatycznie, że cała integracja rozproszona staje się operacją atomową.
Ustalanie limitów ponownego wykonania i kompensacji
Dla każdego kroku określ, które błędy są przejściowe, które ostateczne, a które pozostawiają wynik nieznany. Błędy przejściowe mogą dopuszczać ponowienia z rosnącym czasem oczekiwania i losowym rozrzutem; ustal maksymalną liczbę prób i całkowity limit czasu. Błędy walidacji lub uprawnień zwykle nie znikną po ponowieniu: należy zatrzymać przepływ, usunąć przyczynę i zdecydować, czy ponowne wykonanie jest zasadne.
Udokumentuj dla każdego efektu zewnętrznego, czy można go powtórzyć, sprawdzić, skompensować lub czy nie da się go cofnąć. Zachowaj wynik, gdy operacja jest prawidłowa, a jej powtórzenie byłoby bardziej szkodliwe niż stan częściowy; kompensuj tylko wtedy, gdy istnieje bezpieczne i zatwierdzone działanie biznesowe. Zatrzymaj proces i eskaluj sprawę, gdy dane nie pozwalają ustalić, co się wydarzyło, kompensacja również zawiedzie albo działanie ma wpływ finansowy, prawny lub dotyczący klientów, który wymaga zatwierdzenia.
Polityka kompensacji powinna określać kolejność, warunki, osobę odpowiedzialną i oczekiwany wynik. Rejestruj kompensację jako nowy krok powiązany z pierwotnym efektem, zamiast usuwać jego historię. Dzięki temu zespół operacyjny może odróżnić działanie, które nigdy nie zostało wykonane, od wykonanego działania, które następnie skompensowano.
Zapewnianie zespołowi operacyjnemu kontroli i kontekstu do działania
Konsola lub procedura operacyjna powinna pokazywać stan globalny i stan każdego kroku, ostatni sklasyfikowany błąd, liczbę prób, odwołania zewnętrzne oraz dozwolone działania. Nie udostępniaj ogólnego przycisku „ponów wszystko”. Zamiast tego przedstaw ograniczone opcje: ponowienie idempotentnego kroku, sprawdzenie zdalnego stanu, wykonanie kompensacji lub eskalację.
Zabezpiecz te działania za pomocą kontroli dostępu opartej na rolach; wymagaj dodatkowego potwierdzenia w przypadku wrażliwych efektów oraz rejestruj, kto działał, kiedy, co wybrał i dlaczego. Jeśli ponowne wykonanie zmienia dane wejściowe, wymagaj utworzenia nowego wykonania lub jawnego przeglądu zamiast cichego zmieniania danych wejściowych procesu historycznego.
Aby umożliwić diagnostykę bez ujawniania wrażliwych informacji, przechowuj identyfikatory korelacyjne, kody błędów, wersję procesu i odwołania potrzebne do sprawdzenia systemów źródłowych. Maskuj tokeny, dane osobowe i pełne ładunki. Określ też czas przechowywania logów i osoby uprawnione do ich przeglądania. Użyteczny ślad wyjaśnia, co się wydarzyło, nie stając się zbędną kopią danych biznesowych.
Testowanie awarii i stopniowe wdrażanie mechanizmu odzyskiwania
Testuj przerwania w konkretnych punktach: przed wykonaniem kroku, po działaniu dostawcy, ale przed zapisaniem odpowiedzi, podczas kompensacji oraz wtedy, gdy dwóch workerów próbuje przejąć ten sam proces. Sprawdzaj w każdym przypadku, czy stan pozostaje spójny, efekty nie są duplikowane i czy ręczne działanie zostało zarejestrowane w audycie.
Uwzględnij testy niejednoznacznych odpowiedzi, powtarzających się kluczy idempotencji, nieprawidłowych danych, limitów ponowień i zmian wersji przepływu. Testy integracyjne z symulowanymi zależnościami mogą odtwarzać kontrolowane awarie; jeśli rzeczywisty dostawca zachowuje się inaczej, zweryfikuj również kontrakt i mechanizmy sprawdzania stanu w odpowiednim środowisku.
W przypadku istniejącego przepływu zacznij od sklasyfikowania jego kroków pod kątem odwracalności i idempotencji. Następnie utrwal stan ograniczonego etapu, wdroż odzyskiwanie dla awarii o największym ryzyku i obserwuj oczekujące przypadki, zanim rozszerzysz zakres. Nie usuwaj ani nie resetuj historycznych rekordów, aby ułatwić wdrożenie: zachowaj możliwość śledzenia i określ, jak interpretować procesy utworzone przy użyciu wcześniejszych wersji.
Lista kontrolna wdrażania mechanizmu odzyskiwania
- Czy każdy krok ma identyfikowalne dane wejściowe, utrwalony stan i weryfikowalny wynik?
- Czy wiadomo, które wywołania są idempotentne i co zrobić w przypadku niejednoznacznego wyniku?
- Czy określono limity prób, limity czasu i klasyfikację błędów?
- Czy kompensacje zdefiniowano jako działania biznesowe, z audytem i osobą odpowiedzialną?
- Czy zespół operacyjny może sprawdzać stan i działać z odpowiednimi uprawnieniami, bez dostępu do zbędnych danych?
- Czy przetestowano awarie między krokami, współbieżność, ponowne wykonania i nieudane kompensacje?
- Czy istnieje procedura eskalacji na wypadek, gdy automatyczne wznowienie nie jest bezpieczne?
Praktyczna zasada polega na zachowaniu wystarczających dowodów, by zdecydować o następnym kroku, i zatrzymaniu automatyzacji, gdy dowody są niewystarczające. Bezpieczne odzyskiwanie nie próbuje ukryć awarii: jasno pokazuje, co zostało ukończone, co pozostaje do zrobienia i kto może rozwiązać problem.