Quando um processo de várias etapas falha, executá-lo novamente por inteiro pode repetir efeitos que já ocorreram: criar dois pedidos, enviar duas notificações ou importar o mesmo registro duas vezes. A recuperação parcial de processos com falha em PHP consiste em determinar quais etapas estão confirmadas, quais podem ser repetidas sem risco e quais exigem compensação ou análise humana.
A decisão depende da semântica de cada operação, não apenas de onde ocorreu uma exceção. Uma resposta perdida de uma API, por exemplo, não prova que o sistema externo rejeitou a solicitação. O processo pode ter sido concluído, e a conexão ter falhado antes de o PHP receber o resultado. Projetar para esse caso evita confundir uma execução interrompida com uma execução inexistente.
Escolher entre tentar novamente, retomar e compensar
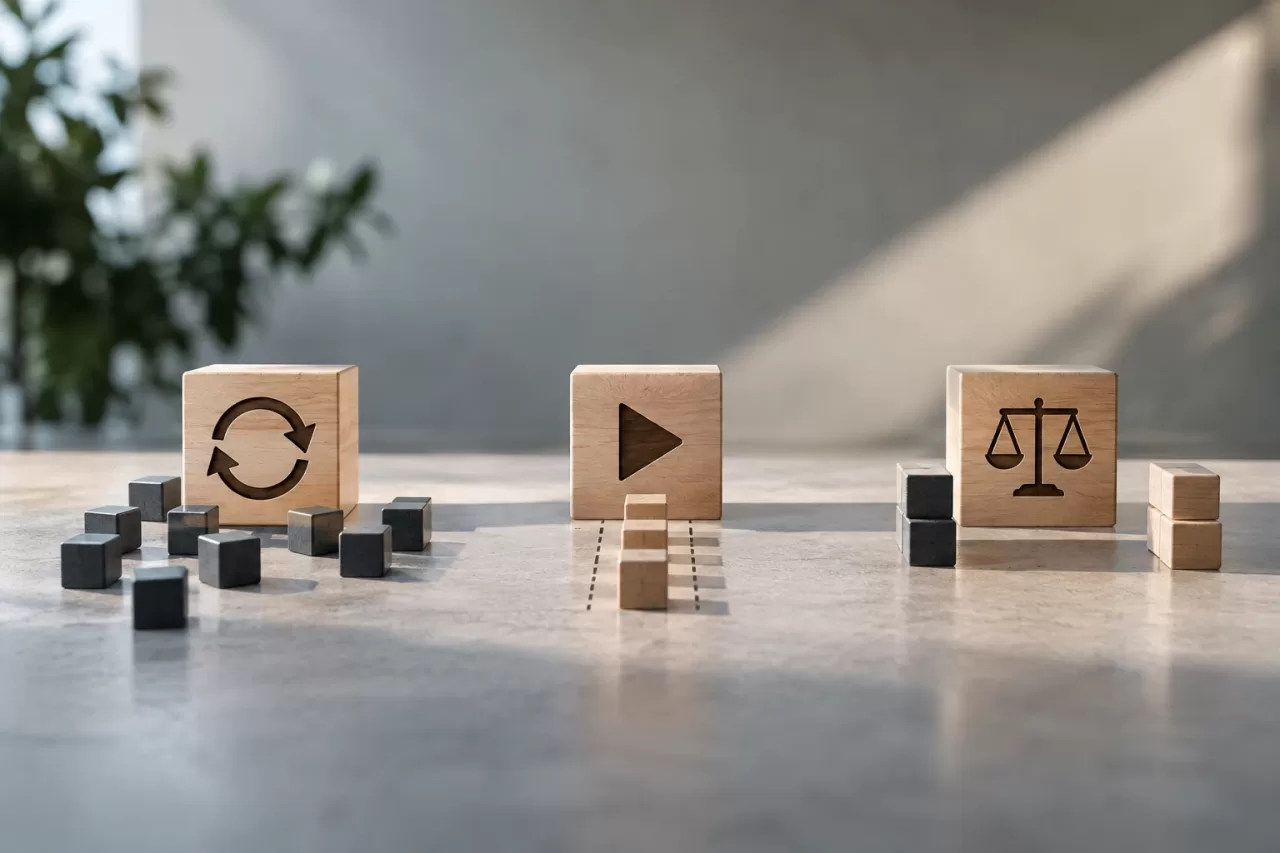
Uma nova tentativa completa executa todas as etapas novamente. Ela é adequada quando todo o fluxo é idempotente — repeti-lo mantém o mesmo estado final — ou quando ainda não ocorreram efeitos externos. Se nenhuma dessas condições puder ser garantida, repetir sem inspecionar é arriscado.
Retomar significa continuar a partir da primeira etapa que não está confirmada. Isso exige registrar o estado das etapas e seus resultados, além de poder recuperar ou verificar o efeito de uma chamada cujo resultado seja ambíguo. Não é o mesmo que pular tudo o que parece concluído: é preciso ter evidências persistidas.
Compensar consiste em executar uma ação que contrabalança um efeito anterior, como cancelar uma reserva. Nem sempre isso restaura exatamente o estado original: uma notificação já enviada não pode ser retirada, e um pagamento capturado pode exigir um reembolso com prazo e registro próprios. Por isso, uma compensação é uma operação de negócio explícita, não um rollback automático do banco de dados.
Modelar etapas com estados e resultados persistidos
Represente o fluxo como uma sequência ou máquina de estados cujas etapas tenham nomes estáveis, entradas identificáveis e resultados persistidos. Um modelo inicial pode incluir estados como pending, running, succeeded, retryable, failed e manual_review. Defina as transições permitidas e evite que um processo passe para um estado final sem salvar as evidências necessárias.
Um registro por processo pode incluir um identificador estável, o tipo de fluxo, o estado global, a versão da definição do processo, as datas de início e atualização, a tentativa e o motivo da última transição. Cada etapa deve salvar seu estado, um identificador de operação, timestamps e uma referência ao resultado relevante. Persista apenas as informações necessárias para retomar ou explicar o resultado; não copie indiscriminadamente respostas completas de APIs nem segredos.
Em PHP, o coordenador pode separar a transição de estado da execução da etapa. A atualização deve ser atômica quando vários workers puderem assumir o mesmo trabalho: use uma transação ou um mecanismo de bloqueio apropriado e registre quem assumiu o processo e até quando. Um bloqueio com prazo de validade deve permitir recuperar trabalhos abandonados sem considerar concluída uma etapa que ficou pela metade.
Definir pontos de verificação sem pressupor “exatamente uma vez”
Salve um ponto de verificação após cada resultado que o sistema possa confirmar de forma confiável. Para operações locais, isso pode ser uma transação que salve, em conjunto, a alteração de negócio e o estado da etapa. Para uma chamada externa, não existe uma transação compartilhada entre o banco de dados e o provedor: o processo pode parar depois que o provedor agir e antes de o PHP registrar a resposta.
Nesse limite, use uma chave de idempotência se o provedor oferecer suporte a ela, derivada de um identificador estável do processo e da etapa. Se não houver suporte, consulte o estado remoto usando um identificador de operação antes de repetir a solicitação. Quando não houver idempotência nem consulta confiável, trate o resultado como ambíguo e encaminhe o caso para análise. Um timeout não basta para concluir que a operação não ocorreu.
Para tarefas assíncronas, o padrão de transactional outbox (outbox transacional) permite salvar a alteração local e a mensagem pendente dentro da mesma transação. Em seguida, um worker entrega a mensagem; o consumidor também deve tolerar duplicatas, por exemplo, salvando os identificadores processados. Esses mecanismos reduzem inconsistências, mas não transformam automaticamente toda uma integração distribuída em uma operação atômica.
Estabelecer limites para novas execuções e compensações
Defina, para cada etapa, quais erros são transitórios, quais são definitivos e quais deixam o resultado desconhecido. Falhas transitórias podem permitir novas tentativas com espera crescente e variação aleatória; estabeleça um número máximo de tentativas e um prazo total. Erros de validação ou permissão geralmente não melhoram com novas tentativas: convém interromper o fluxo, corrigir a causa e decidir se uma nova execução é apropriada.
Documente para cada efeito externo se ele pode ser repetido, consultado, compensado ou se não pode ser revertido. Mantenha o resultado quando a operação for válida e repeti-la for mais prejudicial do que o estado parcial; compense apenas se houver uma ação de negócio segura e autorizada. Interrompa e encaminhe o caso para análise quando os dados não permitirem determinar o que ocorreu, quando a compensação também falhar ou quando a ação tiver impacto financeiro, jurídico ou sobre clientes que exija aprovação.
Uma política de compensação deve especificar ordem, condições, responsável e resultado esperado. Registre a compensação como uma nova etapa, vinculada ao efeito original, em vez de apagar seu histórico. Assim, a equipe de operações consegue distinguir entre uma ação nunca realizada, uma ação realizada e outra compensada.
Fornecer à equipe de operações controles e contexto para agir
O console ou procedimento operacional deve mostrar o estado global e o de cada etapa, o último erro classificado, o número de tentativas, as referências externas e a ação permitida. Evite oferecer um botão genérico de “tentar tudo novamente”. Apresente opções delimitadas: tentar novamente uma etapa idempotente, consultar o estado remoto, executar uma compensação ou encaminhar o caso para análise.
Proteja essas ações com autorização baseada em funções; exija confirmação adicional para efeitos sensíveis e registre quem agiu, quando, o que escolheu e por quê. Se uma nova execução alterar os dados de entrada, exija a criação de uma nova execução ou revisão explícita, em vez de alterar silenciosamente a entrada de um processo histórico.
Para diagnosticar sem expor informações sensíveis, mantenha identificadores de correlação, códigos de erro, a versão do processo e as referências necessárias para consultar os sistemas de origem. Oculte tokens, dados pessoais e payloads completos. Defina também por quanto tempo os registros serão mantidos e quem poderá consultá-los. Um rastreamento útil explica o que aconteceu sem se tornar uma cópia desnecessária dos dados de negócio.
Testar falhas e implantar a recuperação gradualmente
Teste interrupções em pontos específicos: antes de executar uma etapa, depois que o provedor agir mas antes de salvar a resposta, durante uma compensação e enquanto dois workers tentam assumir o mesmo processo. Verifique se o estado permanece coerente após cada caso, se os efeitos não são duplicados e se uma ação manual é auditada.
Inclua testes para respostas ambíguas, chaves de idempotência repetidas, dados inválidos, limites de novas tentativas e alterações de versão do fluxo. Testes de integração com dependências simuladas podem reproduzir falhas controladas; quando o provedor real tiver comportamentos diferentes, valide também o contrato e os mecanismos de consulta em um ambiente adequado.
Para um fluxo existente, comece classificando suas etapas por reversibilidade e idempotência. Depois, persista o estado de uma etapa limitada, implemente a recuperação para as falhas de maior risco e observe os casos pendentes antes de ampliar o escopo. Não apague nem reinicie registros históricos para facilitar a implantação: preserve a rastreabilidade e defina como interpretar processos criados com versões anteriores.
Lista de verificação para implementar a recuperação
- Cada etapa tem entradas identificáveis, um estado persistido e um resultado verificável?
- Está claro quais chamadas são idempotentes e o que fazer quando o resultado é ambíguo?
- Há limites de tentativas, prazos e classificação de erros?
- As compensações estão definidas como ações de negócio, com auditoria e responsável?
- A equipe de operações pode consultar e agir com as permissões adequadas, sem acessar dados desnecessários?
- Foram testadas falhas entre etapas, concorrência, novas execuções e compensações malsucedidas?
- Existe um procedimento de escalonamento quando não é seguro retomar automaticamente?
O critério prático é manter evidências suficientes para decidir a próxima etapa e interromper a automação quando essas evidências forem insuficientes. Uma recuperação segura não tenta ocultar que houve uma falha: deixa explícito o que foi concluído, o que continua pendente e quem pode resolver a situação.