Pipeline integracji ciągłej (CI) powinien odpowiadać na konkretne pytanie: czy tę zmianę można włączyć do współdzielonej bazy kodu bez wprowadzania znanych defektów ani naruszania uzgodnionych wymagań? Aby na nie odpowiedzieć, warto zdefiniować powtarzalne kontrole, ustalić kolejność ich wykonywania i zadbać o to, by każdy błąd dostarczał użytecznych informacji.
CI nie oznacza automatycznego wdrażania każdej zmiany. To praktyka częstego integrowania zmian i ich automatycznej walidacji. Continuous delivery stale przygotowuje wersję gotową do wdrożenia; continuous deployment dodatkowo automatycznie publikuje ją na produkcji po spełnieniu określonych warunków. Aplikacja może korzystać z CI bez automatyzacji dostarczania albo automatyzować je do środowiska testowego, zachowując wymóg akceptacji przed wdrożeniem na produkcję.
Zdefiniuj kontrakt pipeline’u
Zanim wybierzesz narzędzia, określ, jakie dane wejściowe otrzymuje wykonanie, co ma wytworzyć i jakie warunki powodują jego niepowodzenie. Użyteczna konfiguracja dokumentuje co najmniej:
- Dane wejściowe: weryfikowaną zmianę, odpowiednią konfigurację i zależności zadeklarowane przez projekt.
- Środowisko: system i wymagania dotyczące uruchomienia, konfigurację PHP oraz usługi potrzebne do testów. Powinno być wystarczająco podobne w kolejnych uruchomieniach, aby wyniki można było porównywać.
- Wynik: status końcowy, raporty z testów i analiz, a w razie potrzeby także identyfikowalny artefakt, który można później zweryfikować.
- Warunki niepowodzenia: błędy blokujące integrację, te powodujące ostrzeżenia oraz osoby uprawnione do zaakceptowania tymczasowego wyjątku.
Instalacja powinna korzystać z wersjonowanej konfiguracji zależności i respektować plik blokady, zamiast po cichu rozwiązywać zależności do nowych wersji przy każdym uruchomieniu. Ogranicza to jedno ze źródeł rozbieżności między środowiskami programistów i CI. Należy również zadeklarować wymagania dotyczące platformy i rozszerzeń oczekiwane przez aplikację oraz sprawdzić, czy środowisko uruchomieniowe je spełnia.
Unikaj uzależniania pipeline’u od plików lokalnych, usług osobistych lub nieudokumentowanych czynności ręcznych. Jeśli kontrola wymaga bazy danych, cache’a lub innej usługi, określ sposób jej uruchamiania, wymagane dane i sposób czyszczenia. Kontrakt nie musi w pełni naśladować produkcji, ale powinien jasno wskazywać różnice, które mogą wpłynąć na wynik.
Ustal kolejność kontroli według kosztu i skuteczności wykrywania
Praktyczna sekwencja zaczyna się od szybkich walidacji, a kończy na tych wymagających więcej czasu lub infrastruktury. Priorytetem nie jest gromadzenie zadań, lecz możliwie wczesne wykrywanie problemów bez utraty istotnego zakresu weryfikacji.
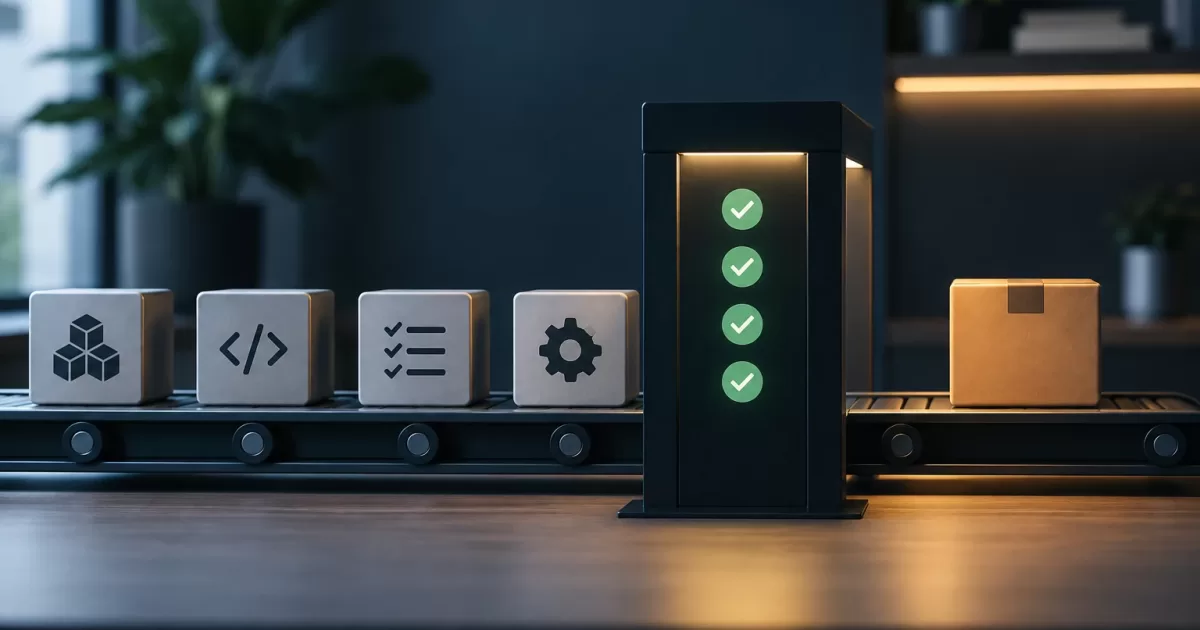
- Powtarzalna instalacja: rozwiązuje zależności na podstawie definicji projektu i pliku blokady. Jeśli się nie powiedzie, wiarygodność pozostałych wyników jest wątpliwa.
- Formatowanie i konwencje: sprawdza uzgodnione reguły formatowania lub stylu. Te kontrole są szybkie i zapobiegają trafianiu różnic w prezentacji do bardziej kosztownego przeglądu.
- Analiza statyczna: wykrywa niezgodności i błędy bez uruchamiania wszystkich ścieżek aplikacji. Dostosuj reguły do kodu i rzeczywistej konfiguracji projektu.
- Testy: najpierw uruchom testy jednostkowe, a następnie dodaj testy integracyjne lub end-to-end zależnie od ryzyka, które obejmują, i wymaganych usług.
- Walidacja artefaktu: sprawdza, czy wygenerowany pakiet lub obraz zawiera elementy potrzebne do uruchomienia i nie zawiera plików deweloperskich, danych lokalnych ani sekretów.
Nie każda aplikacja wymaga tych samych testów ani tej samej kolejności. Jeśli analiza statyczna trwa znacznie dłużej niż niewielki test jednostkowy, warto uruchomić obie kontrole równolegle po instalacji zależności. Niezależne zadania również można wykonywać równolegle, aby skrócić czas oczekiwania, pod warunkiem że korzystają z powtarzalnej bazy, a ich wyniki są przypisane do tej samej zmiany.
Nie warto natomiast bezrefleksyjnie równoleglić kroków, które modyfikują ten sam katalog lub zależą od wcześniejszych wyników. Oddziel wspólne przygotowanie od kolejnych zadań, ogranicz współbieżność współdzielonych usług i jasno określ zależności między etapami. Celem jest skrócenie czasu uzyskania informacji zwrotnej bez uczynienia pipeline’u nieprzewidywalnym.
Zdecyduj, co blokuje integrację, a co uruchamia się później
Na początek przyjmij zasadę, że integrację blokuje niepowodzenie kontroli istotnej dla bezpieczeństwa zmiany: instalacji, uzgodnionej analizy, wymaganych testów lub walidacji pakietu. Zadanie informacyjne — na przykład kontrola będąca jeszcze w fazie oceny — może raportować wyniki bez blokowania przez określony czas. Powinno mieć osobę odpowiedzialną, termin przeglądu i kryterium, po którego spełnieniu stanie się obowiązkowe; w przeciwnym razie ostrzeżenia stają się permanentne i tracą wartość.
Szybkie kontrole powinny wcześnie dostarczać informacji zwrotnej przy każdej zmianie. Kosztowne testy można uruchamiać równolegle, na późniejszym etapie lub z inną częstotliwością, jeśli uzasadnia to czas lub infrastruktura. Jednak pozostawienie całej istotnej walidacji na czas po integracji tworzy okres, w którym zmiany nie zostały sprawdzone. Określ, co jest wymagane przed integracją, a co stanowi dodatkową walidację, uwzględniając skutki późnego wykrycia błędu.
Pomyślne wykonanie CI nie jest równoznaczne z zatwierdzeniem wdrożenia. CI weryfikuje zmianę i może wygenerować artefakt; proces dostarczania decyduje, jak go promować, do jakiego środowiska i pod jakimi kontrolami. Jasne wyznaczenie tej granicy zapobiega przypadkowemu publikowaniu na produkcji przez zadanie walidacyjne. Jeśli wdrożenie jest automatyczne, osobno określ jego warunki, zatwierdzenia, strategię stopniowego udostępniania i mechanizm wycofania.
Chroń konfigurację i sekrety
Sekretów nie należy umieszczać w repozytorium, przykładowych plikach konfiguracyjnych ani raportach z wykonania. Korzystaj z mechanizmu zarządzania sekretami dostępnego w środowisku CI, ogranicz ich dostępność do zadań, które ich potrzebują, i nie udostępniaj poświadczeń produkcyjnych walidacjom wymagającym jedynie odizolowanych usług.
Sprawdzaj również logi: wyjątek, nieudany test lub polecenie diagnostyczne może wypisać wrażliwe zmienne. Maskowanie wartości pomaga, ale nie zastępuje zapobiegania ich zapisywaniu. Używaj danych testowych, które nie ujawniają prawdziwych informacji, i określ procedurę unieważniania poświadczeń, jeśli pojawią się w logu lub artefakcie.
Ułatw diagnozowanie błędów
Czerwony status bez kontekstu wymusza powtarzanie pracy i zamienia CI w czarną skrzynkę. Zachowuj raporty z testów i analiz, dane wyjściowe potrzebne do wskazania nieudanego kroku oraz identyfikatory wersji zależności lub artefaktu. Nie zapisuj natomiast danych osobowych, sekretów ani nieprzefiltrowanych zrzutów środowiska.
Gdy test sporadycznie kończy się niepowodzeniem, nie oznaczaj go jako pomyślnego po nieograniczonej liczbie ponowień. Rejestruj, które testy są niestabilne, jak często i w jakich warunkach; badaj przyczyny takie jak współbieżność, zależności zewnętrzne, współdzielony stan lub limity czasu. Jeśli niestabilny test zostanie tymczasowo odizolowany, udokumentuj ryzyko, wyznacz osobę odpowiedzialną i ustal termin przywrócenia jego blokującego charakteru.
Warto też odróżniać błąd kodu od problemu z infrastrukturą. Informuj, jeśli nie udało się uruchomić usług, pobrać zależności lub ukończyć zadania z powodu braku zasobów. Ponowienie może być uzasadnione w przypadku przejściowej awarii, ale powinno być ograniczone i widoczne; ukrywanie pierwszego niepowodzenia utrudnia wykrywanie powracających problemów.
Dostosuj CI do aplikacji legacy
W starszym systemie nagłe włączenie rygorystycznych reguł może zablokować przydatne zmiany i sprzyjać niekontrolowanym wyjątkom. Zacznij od ustalenia stanu bazowego: sprawdź, które testy obecnie przechodzą, jakie istniejące błędy zgłasza analiza i ile trwa każdy etap. Nie przedstawiaj istniejącego już problemu jako regresji, ale nie pozwól też, by stan bazowy stał się nieograniczoną wymówką.
- Najpierw uczyń obowiązkowymi powtarzalne i stabilne kontrole, takie jak instalacja i wiarygodny zestaw testów.
- Rejestruj istniejące problemy i wymagaj, aby nowe zmiany ich nie pogłębiały, jeśli narzędzie i projekt umożliwiają takie porównanie.
- Dodawaj testy w obszarach najbardziej narażonych na skutki zmian i stopniowo rozszerzaj ich zakres.
- Ograniczaj wyjątki w małych, łatwych do przeglądu zmianach; przypisuj osobę odpowiedzialną i termin każdemu tymczasowemu wyjątkowi.
- Mierz czas i przyczyny niepowodzeń, aby optymalizować konkretne etapy, zamiast usuwać walidacje bez wiedzy, jakie ryzyko obejmowały.
Dobra integracja ciągła w PHP nie jest definiowana liczbą etapów, lecz powtarzalnymi i zrozumiałymi wynikami. Jeśli zespół potrafi wyjaśnić, co weryfikuje każdy krok, co blokuje integrację i jak zbadać błąd, pipeline pomaga podejmować decyzje na podstawie faktów i ustalić, kiedy zmiana jest gotowa do dalszego procesu.