Сбой интеграции не всегда можно устранить повторной попыткой. Если отсутствуют данные, возникло коммерческое расхождение или целевая система требует принять решение, повтор того же запроса может привести к новым ошибкам или даже дублированию операций. Обработка исключений в PHP-интеграциях заключается в выявлении таких случаев, сохранении необходимой информации и предоставлении контролируемого пути для их изучения и разрешения.
Цель — не создавать ещё одну административную систему по умолчанию. Нужно сделать исключения видимыми, понятными и назначаемыми ответственным, а также обеспечить проверяемую запись любого действия, выполненного вручную. Хорошее решение отделяет логику каждой интеграции от общего процесса рассмотрения, не скрывая различий, влияющих на безопасность или результат для бизнеса.
Когда следует прекратить автоматические повторы
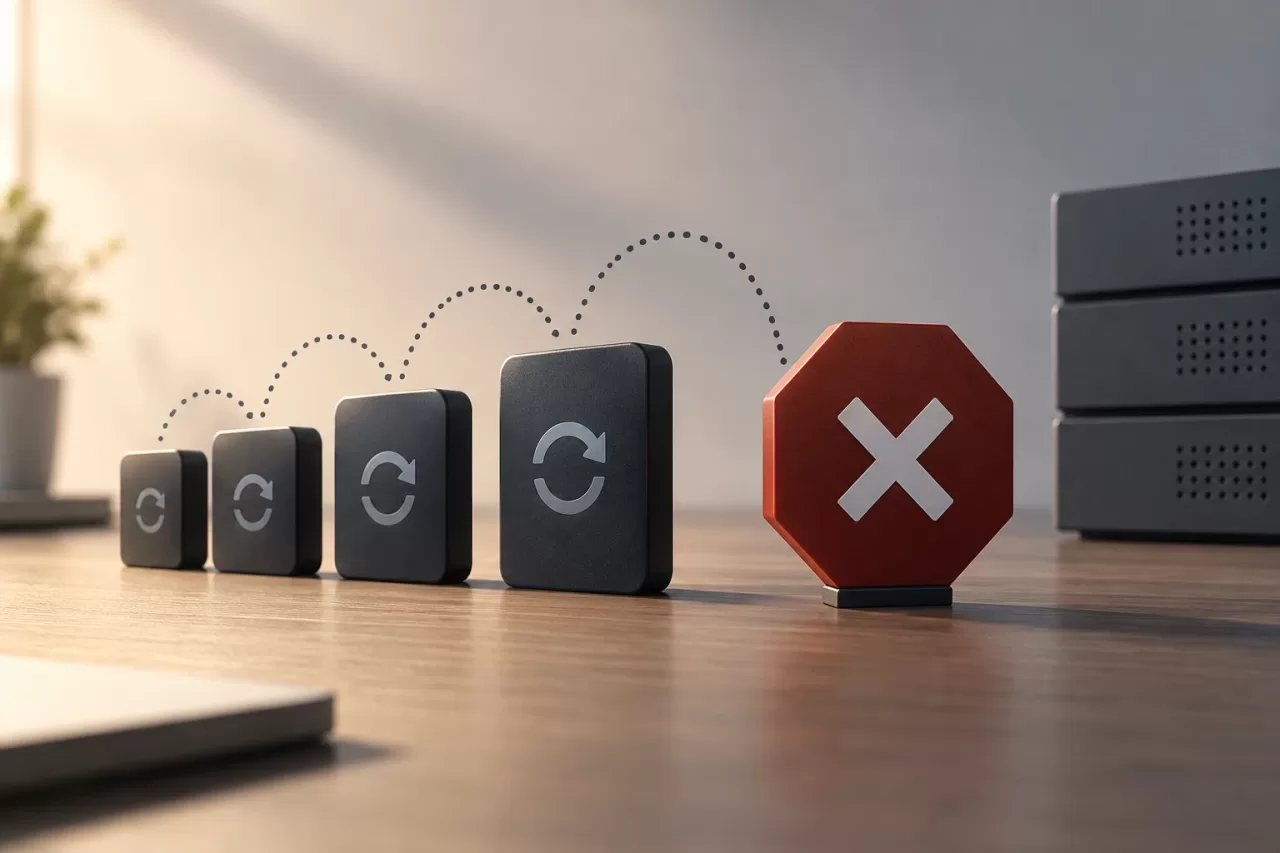
Повторные попытки уместны при сбоях, которые могут быть временными: разрыве соединения, временном ограничении частоты запросов или временной недоступности сервиса. Их следует ограничить явной политикой — например, задать максимальное число попыток и увеличивающийся интервал между ними. Если проблема сохраняется, процесс должен прекратить повторы и перейти в состояние, допускающее исследование.
Отказ из-за некорректных данных, отсутствующей ссылки или нарушения бизнес-правила обычно требует другой реакции. Повтор без изменения условий не устранит проблему. Вмешательство также может потребоваться, если результат операции неизвестен: например, соединение было потеряно после отправки запроса, и непонятно, обработала ли его внешняя система. В этом случае перед повтором нужно проверить состояние или применить механизм защиты от дублирования.
Для каждой интеграции определите, какие ошибки являются временными, какие — окончательными, а какие требуют проверки. Храните эту классификацию рядом с контрактом интеграции, а не распределяйте её по отдельным условиям в контроллерах. Это поможет избежать случайного изменения операционного поведения при технических изменениях.
Сохранение контекста, необходимого для расследования
Человек не должен восстанавливать картину транзакции, отдельно изучая журналы приложения, базы данных и внешние системы. Для каждого исключения нужно собрать сведения, необходимые, чтобы понять произошедшее и решить, что делать дальше, соблюдая ограничения по защите данных.
- Идентификаторы: идентификатор исключения, процесса и связанной бизнес-сущности.
- Источник и назначение: задействованная интеграция, операция и внешняя система — без сохранения секретов и учётных данных.
- Техническое состояние: дата, число попыток, результат, код ответа и нормализованное описание ошибки.
- Бизнес-контекст: важные поля и ссылки, необходимые для разрешения случая; чувствительные данные следует минимизировать или редактировать.
- Корреляция: идентификаторы, позволяющие находить связанные записи в разных сервисах.
Сохраняйте снимок контекста, объясняющий сбой, а при необходимости — ссылки на актуальные данные. Если записи изменятся позже, расследование должно позволять отличить первоначально отправленные данные от существующих сейчас. Установите ограничения доступа и сроки хранения с учётом чувствительности информации.
Моделирование состояний и явных переходов
Состояния описывают операционную ситуацию, а не просто служат визуальными метками. Начальный набор может включать ожидает рассмотрения, расследуется, решено и отброшено. Добавляйте промежуточные состояния только в том случае, если они меняют доступные системе действия или ожидания от ответственного лица.
Определите допустимые переходы. Например, исключение, ожидающее рассмотрения, можно назначить ответственному и перевести в состояние расследования; для решённого исключения следует сохранить результат исправления и, если применимо, идентификатор нового запуска. Отбрасывание не должно означать удаление: для него требуется указать причину, а его влияние на процесс должно быть ясно. Не допускайте произвольной смены состояния с любого экрана или процесса.
Если это повышает ясность, отделяйте состояние рассмотрения от технического результата. Исключение может быть решено с операционной точки зрения, в то время как повторная попытка ещё ожидает подтверждения. Раздельное представление этих параметров предотвращает неоднозначность состояний и упрощает определение оставшейся работы.
Назначение ответственных, сроков и эскалации
Очередь без ответственного накапливает неразобранные случаи. Назначайте ответственных по понятным правилам: например, по типу операции, команде, поддерживающей процесс, или бизнес-подразделению, которое может исправить данные. Разрешите переназначение с указанием причины и сохраняйте как прежнее, так и новое назначение.
Сроки должны задавать операционные ожидания, а не автоматически обещать решение. Определите, как долго случай может оставаться без рассмотрения и что произойдёт по истечении этого времени: уведомление ответственного, эскалация команде или перенос в приоритетную очередь. Не прописывайте конкретных людей в каждой интеграции: используйте настраиваемые правила и предусмотрите альтернативу на случай недоступности ответственного.
Интерфейс должен сразу показывать, какие случаи требуют внимания, кто ими занимается и как долго они ожидают. Если важны объём обращений или часы обслуживания, задайте отдельные правила для разных приоритетов и типов исключений, а не применяйте единый срок ко всем случаям.
Аудит действий и безопасный повтор операций
Каждое вмешательство должно создавать событие аудита: кто действовал, когда, какое действие выполнил, по какой причине и каким было состояние до и после него. Отдельно регистрируйте ручные изменения, автоматические запуски и ответы внешней системы. Не перезаписывайте историю, оставляя только текущее состояние.
Прежде чем предлагать повтор операции, определите, является ли она идемпотентной. Если целевая система это поддерживает, используйте стабильный ключ идемпотентности, чтобы повтор той же операции не создавал второго эффекта. Если такой гарантии нет, сначала проверьте состояние на удалённой стороне или добавьте этап сверки; если проверить результат невозможно, явно покажите эту неопределённость и требуйте решения от уполномоченного лица.
Перед выполнением повторно проверьте данные и бизнес-правила. Ручное действие не должно обходить проверки, защищающие процесс. Сохраните связь между исходным исключением и новой попыткой и однозначно сообщите, была ли операция принята, отклонена или ожидает подтверждения. Опция исправления данных должна указывать, какие поля изменятся и затронет ли исправление исходную запись или только отправляемый запрос.
Оценка работы очереди
Общего числа исключений недостаточно для диагностики процесса. Отслеживайте время до первого рассмотрения и до решения, возраст открытых случаев, повторно открытые случаи, число попыток на исключение и долю исключений, заканчивающихся отбрасыванием. Анализируйте показатели по интеграции, типу ошибки и команде, не создавая стимулов закрывать случаи без решения проблемы.
Рост числа повторяющихся исключений может указывать на изменение API-контракта, недостаточную валидацию или дефектные исходные данные. Увеличение времени ожидания при неизменном объёме может свидетельствовать о нехватке ресурсов или неэффективных правилах назначения. Сочетайте метрики с оповещениями о стареющих элементах очереди и проверяйте выборки случаев, чтобы подтвердить причину.
Выбор между консолью и административной системой
Для решения ограниченного круга задач может быть достаточно интерфейса, позволяющего изучать контекст, назначать ответственных, оставлять заметки, менять состояния и запрашивать контролируемый повтор. Он должен упрощать часто выполняемые действия, предоставлять подходящие права доступа и показывать историю, не раскрывая лишнюю информацию.
Более широкую административную систему стоит рассматривать, если работа включает связанные процессы, редактирование бизнес-сущностей, согласования, сквозной поиск или сложное управление правами доступа. Не путайте операционную очередь с полноценной административной системой: расширяйте область её применения только при наличии реальных потребностей, которые ограниченный интерфейс не может безопасно покрыть.
Контрольный список перед внедрением обработки исключений
- Классифицировать временные ошибки, окончательные ошибки и случаи с неизвестным результатом.
- Определить состояния, переходы, причины закрытия и правила повторного открытия.
- Сохранять достаточный контекст, минимизируя и защищая чувствительные данные.
- Назначить ответственных, сроки и пути эскалации, предусмотрев альтернативный вариант.
- Регистрировать изменения в аудите и связывать каждое вмешательство с последующими попытками.
- Проверять данные перед повтором и защищаться от дублирования эффектов.
- Отслеживать возраст случаев, время обработки и повторяющиеся закономерности, а не только объём.
- Выбрать интерфейс, соответствующий задачам, и проверить права доступа и сроки хранения.
Надёжная обработка исключений не устраняет все сбои. Она явно определяет, что должно происходить, когда автоматизации недостаточно, предотвращает повторы вслепую и позволяет каждому действовать с учётом контекста, ответственности и прослеживаемости.