Un error de integración no siempre se resuelve reintentando. Si falta un dato, hay una discrepancia comercial o el sistema de destino requiere una decisión, repetir la misma petición puede generar más errores o incluso duplicar efectos. La gestión de excepciones en integraciones PHP consiste en detectar estos casos, conservar la información necesaria y ofrecer una ruta controlada para investigarlos y resolverlos.
El objetivo no es construir otro backoffice por defecto. Es hacer que las excepciones sean visibles, comprensibles y asignables, y que cualquier acción manual deje un registro verificable. Una buena solución separa la lógica de cada integración del proceso común de revisión, sin ocultar las diferencias que afectan a la seguridad o al resultado de negocio.
Cuándo dejar de reintentar automáticamente
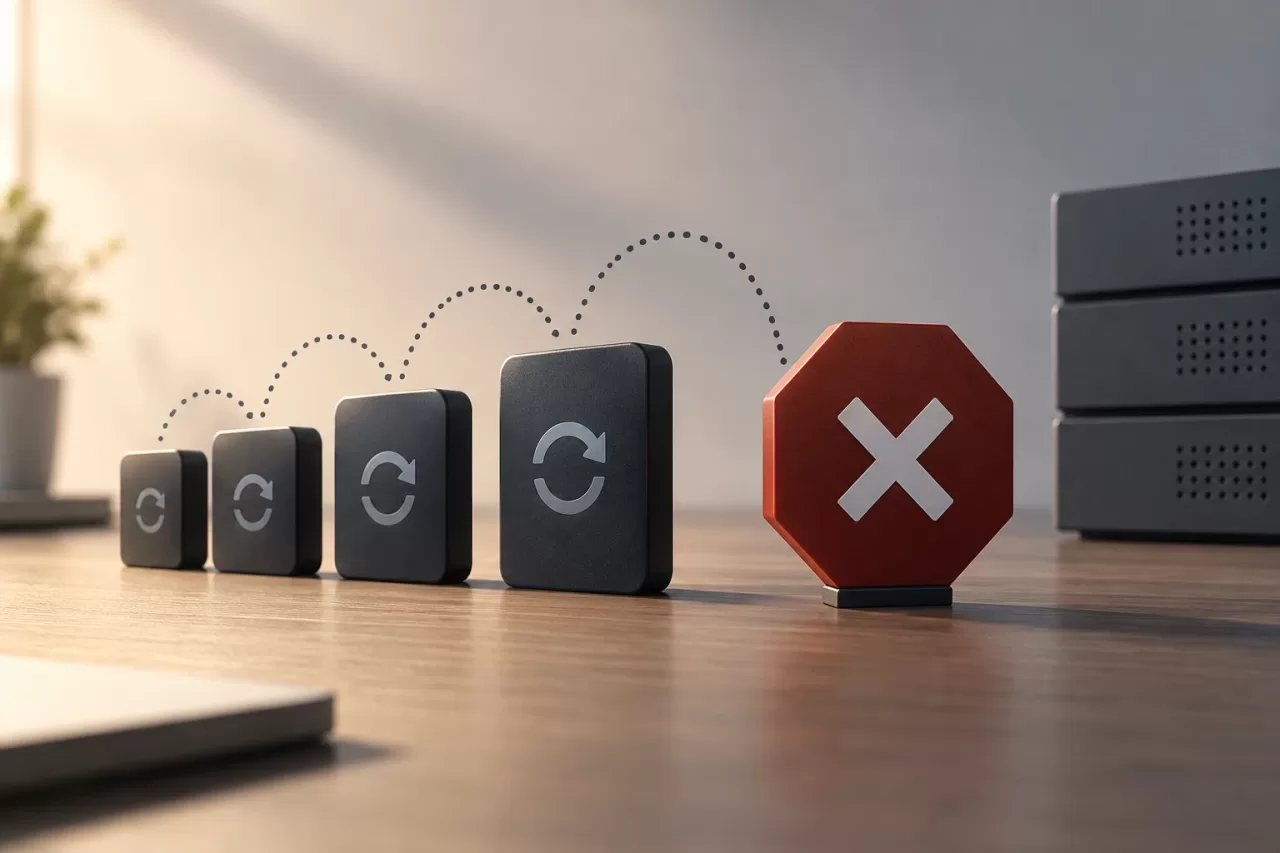
Los reintentos sirven ante fallos posiblemente transitorios: una desconexión, un límite temporal de solicitudes o una respuesta temporalmente no disponible. Conviene limitarlos con una política explícita, por ejemplo, un número máximo de intentos y un intervalo creciente entre ellos. Si el problema persiste, el flujo debe dejar de insistir y pasar a una condición que pueda investigarse.
En cambio, un rechazo por datos inválidos, una referencia inexistente o una regla de negocio incumplida normalmente requiere otra respuesta. Reintentar sin cambiar las condiciones no la corregirá. También puede necesitar intervención una operación cuyo resultado sea incierto: por ejemplo, si se perdió la conexión después de enviar una solicitud y no se sabe si el sistema externo la procesó. En ese caso, antes de repetir hay que comprobar el estado o aplicar un mecanismo que evite duplicados.
Defina para cada integración qué errores son transitorios, cuáles son definitivos y cuáles requieren verificación. Mantenga esa clasificación junto al contrato de la integración, no dispersa en condiciones distintas dentro de los controladores. Así se evita que un cambio técnico modifique accidentalmente la respuesta operativa.
Conservar contexto útil para la investigación
Una persona no debería reconstruir una transacción consultando registros de aplicación, bases de datos y sistemas externos por separado. Cada excepción debe reunir lo necesario para entender qué ocurrió y decidir qué hacer, respetando los límites de protección de datos.
- Identidad: identificador de la excepción, del flujo y de la entidad de negocio relacionada.
- Origen y destino: integración implicada, operación y sistema externo, sin guardar secretos ni credenciales.
- Estado técnico: fecha, número de intentos, resultado, código de respuesta y una descripción normalizada del error.
- Contexto de negocio: campos relevantes y referencias necesarias para resolver el caso, con datos sensibles minimizados o redactados.
- Correlación: identificadores que permitan localizar los registros relacionados en servicios distintos.
Guarde una instantánea del contexto que explique el fallo, además de las referencias a los datos actuales cuando sea necesario. Si los registros se modifican después, la investigación debe poder distinguir lo que se envió originalmente de lo que existe ahora. Establezca límites de acceso y retención acordes con la sensibilidad de la información.
Modelar estados y transiciones explícitas
Los estados describen la situación operativa; no son sólo etiquetas visuales. Un conjunto inicial puede incluir pendiente de revisión, en investigación, resuelta y descartada. Añada estados intermedios únicamente si cambian qué puede hacer el sistema o qué se espera de la persona responsable.
Defina qué transiciones están permitidas. Por ejemplo, una excepción pendiente puede asignarse y pasar a investigación; una excepción resuelta debería conservar el resultado de la corrección y, si procede, el identificador de la nueva ejecución. Descartar no debe equivaler a borrar: requiere un motivo, y su efecto sobre el flujo debe estar claro. Evite permitir cambios arbitrarios de estado desde cualquier pantalla o proceso.
Separe el estado de revisión del resultado técnico cuando aporte claridad. Una excepción puede estar resuelta en términos operativos, mientras que la repetición todavía está esperando confirmación. Representar esas dimensiones por separado evita estados ambiguos y facilita saber si queda trabajo pendiente.
Asignar responsables, vencimientos y escalado
Una cola sin propietario acumula casos. Asigne responsables por reglas comprensibles, como el tipo de operación, el equipo que mantiene el proceso o el área de negocio que puede corregir los datos. Permita reasignar con motivo y conserve tanto la asignación anterior como la nueva.
Los vencimientos deben expresar una expectativa operativa, no una promesa automática de resolución. Determine cuánto tiempo puede permanecer un caso sin revisión y qué ocurre al superarlo: aviso al responsable, escalado a un equipo o incorporación a una cola prioritaria. Evite codificar la identidad de personas concretas en cada integración; mantenga reglas configurables y una alternativa cuando el responsable no esté disponible.
La interfaz debe mostrar con rapidez qué casos requieren atención, quién se ocupa de ellos y cuánto llevan esperando. Si el volumen o los horarios de atención son relevantes, defina reglas distintas por prioridad y tipo de excepción en lugar de aplicar un único vencimiento a todo.
Registrar acciones y repetir de forma segura
Cada intervención debe producir un evento de auditoría: quién actuó, cuándo, qué acción realizó, con qué motivo y cuál era el estado antes y después. Registre por separado los cambios manuales, las ejecuciones automáticas y las respuestas del sistema externo. No sobrescriba el historial para mostrar sólo el estado actual.
Antes de ofrecer una acción de repetición, determine si la operación es idempotente. Cuando el sistema de destino lo permita, utilice una clave idempotente estable para que repetir la misma operación no cree un segundo efecto. Si no existe esa garantía, consulte primero el estado remoto o establezca un paso de conciliación; cuando no pueda verificarse el resultado, muestre esa incertidumbre y exija una decisión autorizada.
Valide de nuevo los datos y las reglas de negocio antes de ejecutar. La acción manual no debe saltarse las validaciones que protegen el flujo. Guarde el vínculo entre la excepción original y el nuevo intento, y comunique de forma inequívoca si la operación quedó aceptada, rechazada o pendiente de confirmación. Una opción para corregir datos debe indicar qué campos cambiará y si la corrección afecta al registro de origen o sólo a la solicitud enviada.
Medir el funcionamiento de la cola
El número total de excepciones es insuficiente para diagnosticar el proceso. Observe el tiempo hasta la primera revisión y hasta la resolución, la antigüedad de los casos abiertos, los casos reabiertos, los intentos por excepción y la proporción que termina descartada. Segmente por integración, tipo de error y equipo, sin convertir las métricas en incentivos para cerrar casos sin resolverlos.
Un aumento de excepciones repetidas puede indicar un contrato de API cambiado, una validación insuficiente o datos de origen defectuosos. Un aumento del tiempo de espera, aunque el volumen no cambie, puede señalar falta de capacidad o reglas de asignación ineficaces. Combine las métricas con alertas de cola envejecida y revise muestras de casos para confirmar la causa.
Elegir entre una consola y un backoffice
Una interfaz de resolución acotada puede bastar si las personas necesitan revisar contexto, asignar casos, dejar notas, cambiar estados y solicitar una repetición controlada. Debe facilitar las tareas frecuentes, ofrecer permisos adecuados y mostrar el historial sin exponer información innecesaria.
Hace falta valorar un backoffice más amplio cuando el trabajo incluye procesos relacionados, edición de entidades de negocio, aprobaciones, búsqueda transversal o gestión de permisos compleja. No confunda una cola operativa con un sistema de administración completo: amplíe el alcance sólo cuando haya necesidades reales que la interfaz limitada no pueda cubrir con seguridad.
Lista de comprobación antes de incorporar la gestión
- Clasificar los errores transitorios, definitivos y de resultado incierto.
- Definir estados, transiciones, motivos de cierre y reglas de reapertura.
- Guardar contexto suficiente, con datos sensibles minimizados y protegidos.
- Asignar responsables, vencimientos y vías de escalado con una alternativa.
- Auditar cambios y relacionar cada intervención con sus intentos posteriores.
- Validar antes de repetir y protegerse frente a efectos duplicados.
- Medir antigüedad, tiempos de atención y patrones recurrentes, no sólo volumen.
- Elegir una interfaz proporcional a las tareas y revisar permisos y retención.
Una gestión fiable de excepciones no elimina todos los fallos. Hace explícito qué debe ocurrir cuando la automatización no basta, evita reintentos a ciegas y permite que cada persona actúe con contexto, responsabilidad y trazabilidad.