Une erreur d’intégration ne se résout pas toujours en réessayant. S’il manque une donnée, s’il existe une divergence commerciale ou si le système cible exige une décision, répéter la même requête peut générer davantage d’erreurs, voire dupliquer des effets. La gestion des exceptions dans les intégrations PHP consiste à détecter ces situations, à conserver les informations nécessaires et à proposer une procédure contrôlée pour les examiner et les résoudre.
L’objectif n’est pas de construire systématiquement un nouveau back-office. Il s’agit de rendre les exceptions visibles, compréhensibles et attribuables, et de laisser une trace vérifiable de toute action manuelle. Une bonne solution sépare la logique propre à chaque intégration du processus commun de révision, sans masquer les différences qui ont une incidence sur la sécurité ou le résultat métier.
Quand arrêter les nouvelles tentatives automatiques
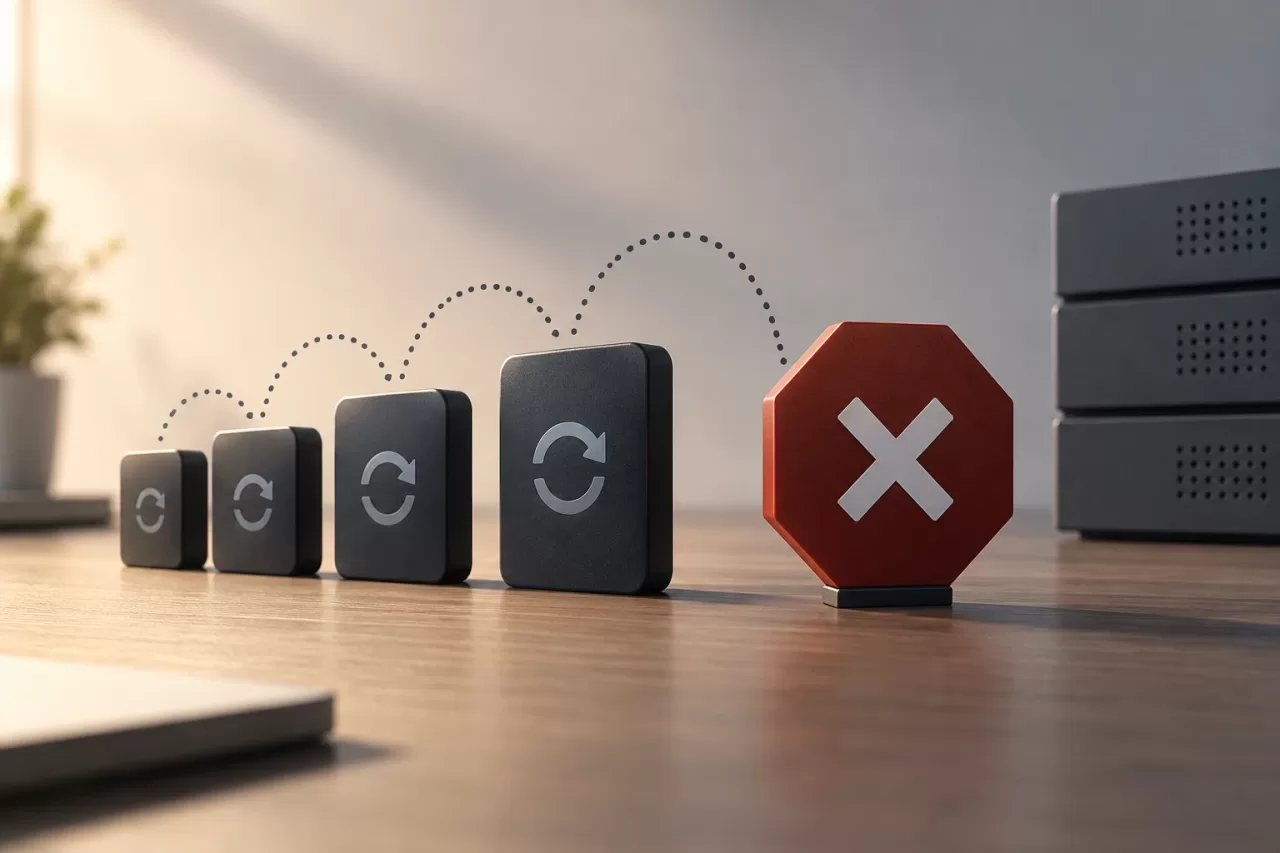
Les nouvelles tentatives sont utiles face à des défaillances potentiellement transitoires : une déconnexion, une limite temporaire de requêtes ou une réponse momentanément indisponible. Il convient de les encadrer par une politique explicite, par exemple un nombre maximal de tentatives et un intervalle croissant entre celles-ci. Si le problème persiste, le flux doit cesser d’insister et passer à un état qui peut faire l’objet d’une investigation.
En revanche, un rejet dû à des données invalides, une référence inexistante ou une règle métier non respectée appelle normalement une autre réponse. Réessayer sans modifier les conditions ne corrigera pas le problème. Une intervention peut également être nécessaire lorsque le résultat d’une opération est incertain : par exemple, si la connexion a été perdue après l’envoi d’une requête et que l’on ignore si le système externe l’a traitée. Dans ce cas, il faut vérifier l’état ou appliquer un mécanisme évitant les doublons avant de réessayer.
Définissez, pour chaque intégration, quelles erreurs sont transitoires, lesquelles sont définitives et lesquelles nécessitent une vérification. Conservez cette classification avec le contrat de l’intégration, plutôt que de la disperser dans différentes conditions des contrôleurs. Vous éviterez ainsi qu’une modification technique change accidentellement la réponse opérationnelle.
Conserver un contexte utile à l’investigation
Une personne ne devrait pas avoir à reconstituer une transaction en consultant séparément les journaux de l’application, les bases de données et les systèmes externes. Chaque exception doit réunir les éléments nécessaires pour comprendre ce qui s’est passé et décider de la suite à donner, dans le respect des limites liées à la protection des données.
- Identité : identifiant de l’exception, du flux et de l’entité métier concernée.
- Origine et destination : intégration concernée, opération et système externe, sans enregistrer de secrets ni d’identifiants d’accès.
- État technique : date, nombre de tentatives, résultat, code de réponse et description normalisée de l’erreur.
- Contexte métier : champs pertinents et références nécessaires à la résolution du cas, avec minimisation ou masquage des données sensibles.
- Corrélation : identifiants permettant de retrouver les journaux associés dans différents services.
Enregistrez un instantané du contexte expliquant l’échec, ainsi que des références aux données actuelles lorsque cela est nécessaire. Si les enregistrements sont modifiés par la suite, l’investigation doit permettre de distinguer ce qui a été envoyé à l’origine de ce qui existe maintenant. Définissez des limites d’accès et de conservation adaptées à la sensibilité des informations.
Modéliser des états et des transitions explicites
Les états décrivent la situation opérationnelle ; ce ne sont pas de simples étiquettes visuelles. Un ensemble initial peut inclure à examiner, en cours d’investigation, résolue et écartée. N’ajoutez des états intermédiaires que s’ils modifient les actions possibles du système ou les attentes envers la personne responsable.
Définissez les transitions autorisées. Par exemple, une exception à examiner peut être attribuée et passer à l’état « en cours d’investigation » ; une exception résolue doit conserver le résultat de la correction et, le cas échéant, l’identifiant de la nouvelle exécution. Écarter ne doit pas équivaloir à supprimer : cette action nécessite un motif et son effet sur le flux doit être clair. Évitez d’autoriser des changements d’état arbitraires depuis n’importe quel écran ou processus.
Séparez l’état de révision du résultat technique si cela apporte davantage de clarté. Une exception peut être résolue sur le plan opérationnel, alors que la nouvelle tentative attend encore une confirmation. Représenter ces dimensions séparément évite les états ambigus et permet de savoir plus facilement s’il reste du travail à effectuer.
Attribuer des responsables, des échéances et des voies d’escalade
Une file d’attente sans responsable accumule les cas. Attribuez-les selon des règles compréhensibles, telles que le type d’opération, l’équipe qui assure la maintenance du processus ou le domaine métier en mesure de corriger les données. Autorisez la réattribution avec indication d’un motif et conservez à la fois l’ancienne et la nouvelle attribution.
Les échéances doivent exprimer une attente opérationnelle, et non une promesse de résolution automatique. Déterminez combien de temps un cas peut rester sans examen et ce qui se passe une fois ce délai dépassé : notification au responsable, escalade vers une équipe ou transfert vers une file prioritaire. Évitez de coder en dur le nom de personnes précises dans chaque intégration ; privilégiez des règles configurables et prévoyez une solution de repli lorsque la personne responsable n’est pas disponible.
L’interface doit montrer rapidement quels cas nécessitent une attention, qui s’en occupe et depuis combien de temps ils attendent. Si le volume ou les horaires de prise en charge sont importants, définissez des règles différentes selon la priorité et le type d’exception, au lieu d’appliquer une échéance unique à tous les cas.
Consigner les actions et réessayer en toute sécurité
Chaque intervention doit générer un événement d’audit : qui a agi, quand, quelle action a été effectuée, pour quel motif et quel était l’état avant et après. Enregistrez séparément les modifications manuelles, les exécutions automatiques et les réponses du système externe. N’écrasez pas l’historique pour n’afficher que l’état actuel.
Avant de proposer une action de nouvelle tentative, déterminez si l’opération est idempotente. Lorsque le système cible le permet, utilisez une clé d’idempotence stable afin que répéter la même opération ne produise pas un second effet. Si cette garantie n’existe pas, vérifiez d’abord l’état à distance ou mettez en place une étape de rapprochement ; si le résultat ne peut pas être vérifié, signalez cette incertitude et exigez une décision autorisée.
Validez à nouveau les données et les règles métier avant l’exécution. L’action manuelle ne doit pas contourner les validations qui protègent le flux. Enregistrez le lien entre l’exception d’origine et la nouvelle tentative, et indiquez sans ambiguïté si l’opération a été acceptée, rejetée ou reste en attente de confirmation. Une option de correction des données doit préciser quels champs elle modifiera et si la correction concerne l’enregistrement source ou uniquement la requête envoyée.
Mesurer le fonctionnement de la file d’attente
Le nombre total d’exceptions ne suffit pas à diagnostiquer le processus. Suivez le délai avant le premier examen et avant la résolution, l’ancienneté des cas ouverts, les cas rouverts, le nombre de tentatives par exception et la proportion de cas finalement écartés. Segmentez les données par intégration, type d’erreur et équipe, sans transformer les indicateurs en incitations à clôturer les cas sans les résoudre.
Une hausse des exceptions récurrentes peut indiquer une modification du contrat d’API, une validation insuffisante ou des données sources défectueuses. Une augmentation du temps d’attente, même si le volume reste stable, peut signaler un manque de capacité ou des règles d’attribution inefficaces. Combinez les indicateurs avec des alertes sur le vieillissement de la file et examinez des échantillons de cas pour confirmer la cause.
Choisir entre une console et un back-office
Une interface de résolution limitée peut suffire si les personnes doivent examiner le contexte, attribuer les cas, ajouter des notes, modifier des états et demander une nouvelle tentative contrôlée. Elle doit faciliter les tâches courantes, proposer des autorisations adaptées et afficher l’historique sans exposer d’informations inutiles.
Il convient d’envisager un back-office plus étendu lorsque le travail comprend des processus connexes, la modification d’entités métier, des approbations, une recherche transversale ou une gestion complexe des autorisations. Ne confondez pas une file opérationnelle avec un système d’administration complet : n’élargissez le périmètre que si des besoins réels ne peuvent pas être couverts en toute sécurité par l’interface limitée.
Liste de contrôle avant d’intégrer la gestion des exceptions
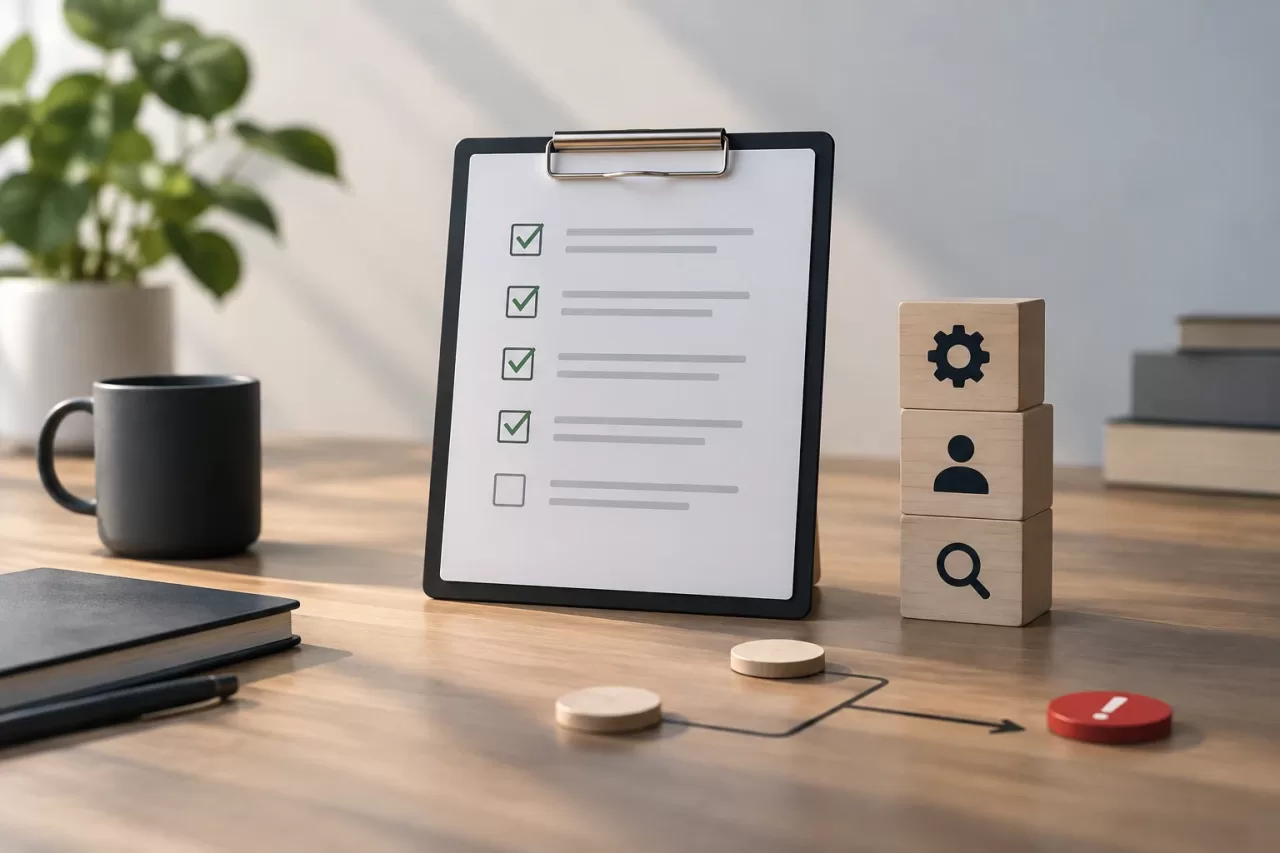
- Classer les erreurs transitoires, définitives et celles dont le résultat est incertain.
- Définir les états, les transitions, les motifs de clôture et les règles de réouverture.
- Enregistrer un contexte suffisant, en minimisant et en protégeant les données sensibles.
- Attribuer des responsables, définir des échéances et des voies d’escalade avec une solution de repli.
- Auditer les modifications et relier chaque intervention aux tentatives ultérieures.
- Valider les données avant toute nouvelle tentative et se protéger contre les effets en double.
- Mesurer l’ancienneté, les délais de prise en charge et les tendances récurrentes, pas seulement le volume.
- Choisir une interface adaptée aux tâches et vérifier les autorisations et la durée de conservation.
Une gestion fiable des exceptions n’élimine pas toutes les défaillances. Elle précise ce qui doit se passer lorsque l’automatisation ne suffit pas, évite les nouvelles tentatives à l’aveugle et permet à chaque personne d’agir avec le contexte, la responsabilité et la traçabilité nécessaires.