連携エラーは、再試行すれば必ず解決するとは限りません。データが不足している、商取引上の不一致がある、あるいは接続先システムで判断が必要な場合、同じリクエストを繰り返すと、エラーが増えたり副作用が重複したりするおそれがあります。PHP連携における例外管理とは、こうしたケースを検出し、必要な情報を保持したうえで、調査と解決に向けた統制された経路を用意することです。
目的は、最初から別のバックオフィスを構築することではありません。例外を可視化して理解しやすくし、担当者を割り当てられるようにするとともに、手動操作の記録を検証可能な形で残すことです。優れた仕組みでは、連携ごとのロジックと共通の確認プロセスを分離しつつ、安全性や業務上の結果に影響する違いは隠しません。
自動再試行を止めるタイミング
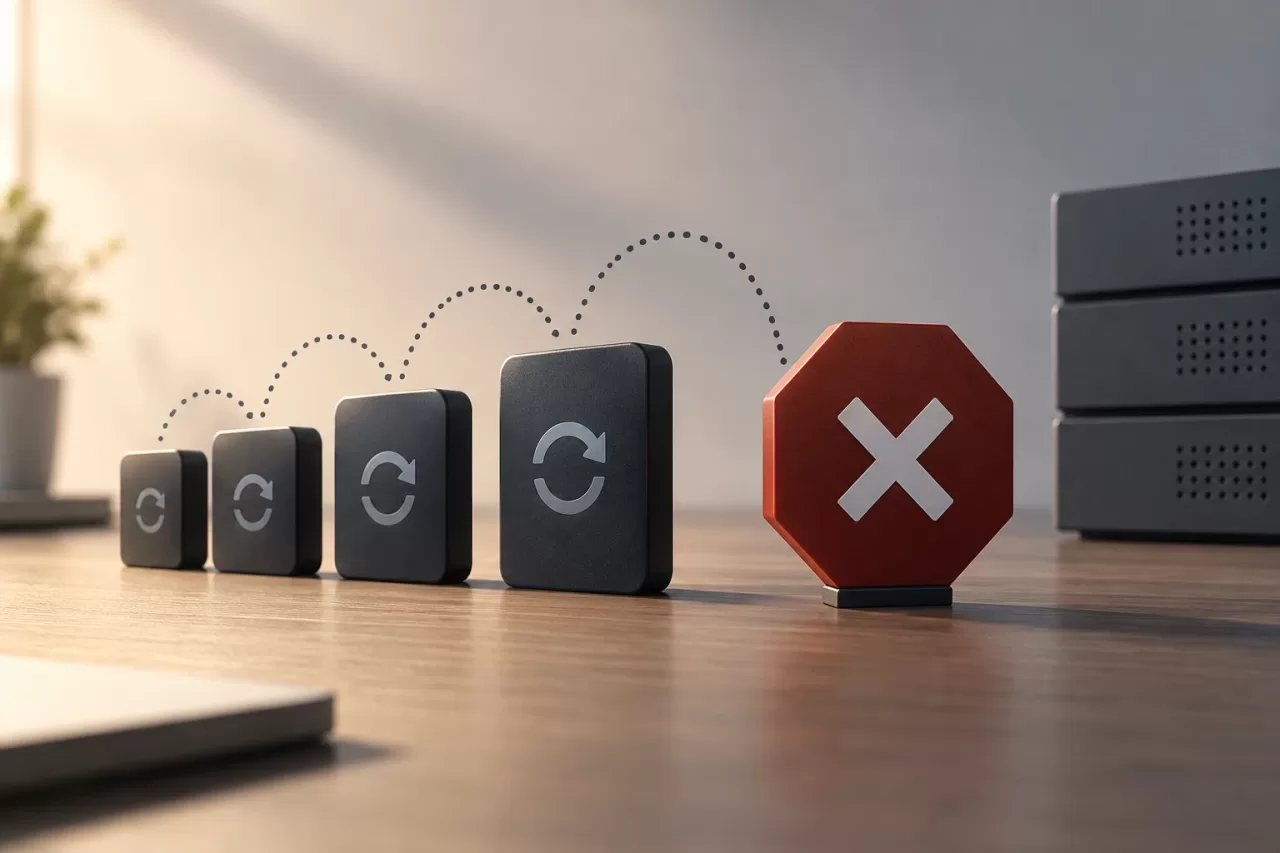
再試行が有効なのは、接続の切断、一時的なリクエスト制限、一時的に応答できない状態など、一過性の可能性がある障害です。最大試行回数や、間隔を徐々に延ばす方法など、明示的なポリシーで制限するのが適切です。問題が続く場合は、処理を繰り返すのをやめ、調査可能な状態へ移行させます。
一方、無効なデータによる拒否、存在しない参照、業務ルール違反には、通常、別の対応が必要です。条件を変えずに再試行しても解決しません。また、結果が不明な操作にも人の介入が必要な場合があります。たとえば、リクエスト送信後に接続が切れ、外部システムが処理したかどうか分からないケースです。この場合、再試行する前に状態を確認するか、重複を防ぐ仕組みを適用します。
連携ごとに、どのエラーが一過性か、恒久的か、確認を要するかを定義します。この分類は連携の契約と併せて管理し、コントローラー内の個別の条件に分散させないでください。そうすることで、技術的な変更が運用上の対応を意図せず変えてしまうのを防げます。
調査に役立つコンテキストを保持する
担当者が、アプリケーションログ、データベース、外部システムを個別に調べてトランザクションを再構成する必要があってはなりません。各例外には、何が起きたかを理解し、対応を判断するために必要な情報をまとめます。その際、データ保護上の制約を守ります。
- 識別情報:例外、フロー、および関連する業務エンティティの識別子。
- 送信元と接続先:関係する連携、操作、外部システム。シークレットや認証情報は保存しません。
- 技術的な状態:日時、試行回数、結果、応答コード、標準化されたエラーの説明。
- 業務コンテキスト:ケース解決に必要な関連フィールドや参照情報。機微データは最小限にするか、マスキングします。
- 相関情報:異なるサービスにある関連ログを特定できる識別子。
障害の説明に必要なコンテキストのスナップショットを保存し、必要に応じて現在のデータへの参照も保持します。後から記録が変更されても、調査時に当初送信した内容と現在の内容を区別できる必要があります。情報の機微性に応じて、アクセス制限と保存期間を定めます。
状態と遷移を明示的にモデル化する
状態は運用上の状況を表すものであり、単なる表示用ラベルではありません。初期状態の例として、確認待ち、調査中、解決済み、破棄済みがあります。システムが実行できること、または担当者に期待される対応が変わる場合に限り、中間状態を追加します。
許可する遷移を定義します。たとえば、確認待ちの例外は担当者を割り当てて調査中にできます。解決済みの例外には、修正結果と、該当する場合は新たな実行の識別子を残します。破棄は削除と同じではありません。理由が必要であり、フローへの影響も明確にしなければなりません。どの画面やプロセスからでも任意に状態を変更できるようにするのは避けます。
明確さにつながる場合は、確認状態と技術的な結果を分けます。運用上は解決済みでも、再実行の確認を待っている例外があり得ます。この2つの側面を分けて表現すれば、状態の曖昧さを防ぎ、残作業の有無を把握しやすくなります。
担当者、期限、エスカレーションを設定する
担当者のいないキューにはケースがたまります。操作の種類、プロセスの保守チーム、データを修正できる業務部門など、理解しやすいルールで担当者を割り当てます。理由を添えて再割り当てできるようにし、変更前後の担当者を両方記録します。
期限は、運用上の目安を示すものであり、自動的な解決を約束するものではありません。確認されないままケースを維持できる期間と、期限を超えた場合の対応を定めます。担当者への通知、チームへのエスカレーション、優先キューへの追加などが考えられます。連携ごとに特定の個人を固定するのは避け、設定可能なルールと、担当者不在時の代替策を用意します。
インターフェースでは、対応が必要なケース、担当者、待ち時間をすぐに確認できるようにします。件数や対応時間帯が重要な場合は、すべてに同じ期限を適用するのではなく、優先度や例外の種類に応じたルールを定めます。
操作を記録し、安全に再実行する
すべての介入について、誰が、いつ、どのような操作を、どの理由で行い、前後の状態がどう変化したかを監査イベントとして記録します。手動変更、自動実行、外部システムからの応答は、それぞれ分けて記録します。現在の状態だけを残すために履歴を上書きしてはいけません。
再実行操作を提供する前に、その操作が冪等かどうかを判断します。接続先システムが対応している場合は、安定した冪等性キーを使い、同じ操作を繰り返しても副作用が重複しないようにします。その保証がない場合は、先にリモート側の状態を確認するか、照合手順を設けます。結果を確認できない場合は、その不確実性を示し、権限を持つ人の判断を必須にします。
実行前に、データと業務ルールを改めて検証します。手動操作によって、フローを保護する検証を回避してはなりません。元の例外と新たな試行の関連付けを保存し、操作が受理、拒否、確認待ちのどの状態になったかを明確に伝えます。データ修正の操作では、どのフィールドが変更されるのか、修正が元のレコードに反映されるのか、送信リクエストだけに適用されるのかを明示します。
キューの運用状況を測定する
例外の総数だけでは、プロセスを診断するには不十分です。最初の確認までの時間、解決までの時間、未解決ケースの経過時間、再オープンされたケース、例外あたりの試行回数、破棄に至った割合を把握します。ケースを未解決のまま閉じる動機にならないよう注意しながら、連携、エラーの種類、チームごとに分析します。
同じ例外の増加は、API契約の変更、不十分なバリデーション、または不正な元データを示している可能性があります。件数が変わらないのに待ち時間が延びている場合は、対応能力の不足や、効果のない割り当てルールが考えられます。キューの滞留アラートと指標を組み合わせ、ケースのサンプルを確認して原因を特定します。
コンソールとバックオフィスのどちらを選ぶか
担当者がコンテキストを確認し、ケースを割り当て、メモを残し、状態を変更し、制御された再実行を依頼できればよい場合は、範囲を絞った解決用インターフェースで十分なことがあります。頻度の高い作業を行いやすくし、適切な権限を設定するとともに、不要な情報を公開せずに履歴を表示できる必要があります。
関連プロセス、業務エンティティの編集、承認、横断検索、複雑な権限管理が必要な場合は、より広範なバックオフィスの導入を検討します。運用キューを管理システム全体と混同せず、限定的なインターフェースでは安全に対応できない実際のニーズがある場合にのみ、対象範囲を広げます。
例外管理を導入する前のチェックリスト
- エラーを一過性、恒久的、結果不明に分類する。
- 状態、遷移、終了理由、再オープンのルールを定める。
- 機微データを最小限にして保護しながら、十分なコンテキストを保存する。
- 代替策を含め、担当者、期限、エスカレーション経路を設定する。
- 変更を監査し、各介入とその後の試行を関連付ける。
- 再実行前に検証し、副作用の重複を防ぐ。
- 件数だけでなく、滞留時間、対応時間、再発パターンを測定する。
- 作業に見合ったインターフェースを選び、権限と保存期間を確認する。
信頼できる例外管理を導入しても、すべての障害をなくせるわけではありません。自動化だけでは不十分な場合に何をすべきかを明確にし、無計画な再試行を防ぎ、各担当者が適切なコンテキストと責任、追跡可能性をもって対応できるようにします。