Quando o suporte recebe várias solicitações semelhantes, a reação habitual é pedir uma alteração. No entanto, a repetição, por si só, não demonstra a existência de um novo requisito: pode indicar um defeito, uma interface confusa, falta de treinamento ou uma exceção mal gerenciada. Alterar uma aplicação PHP antes de entender a causa pode automatizar o problema ou introduzir uma regra que não representa o trabalho real.
Transformar incidentes recorrentes em requisitos de software exige passar de relatos individuais para uma decisão verificável: quem precisa de qual resultado, em que condições e com quais exceções. Esse processo ajuda produto, operações e desenvolvimento a acordar o escopo antes de estimar e alterar o código.
Por que um incidente repetido não equivale automaticamente a um requisito
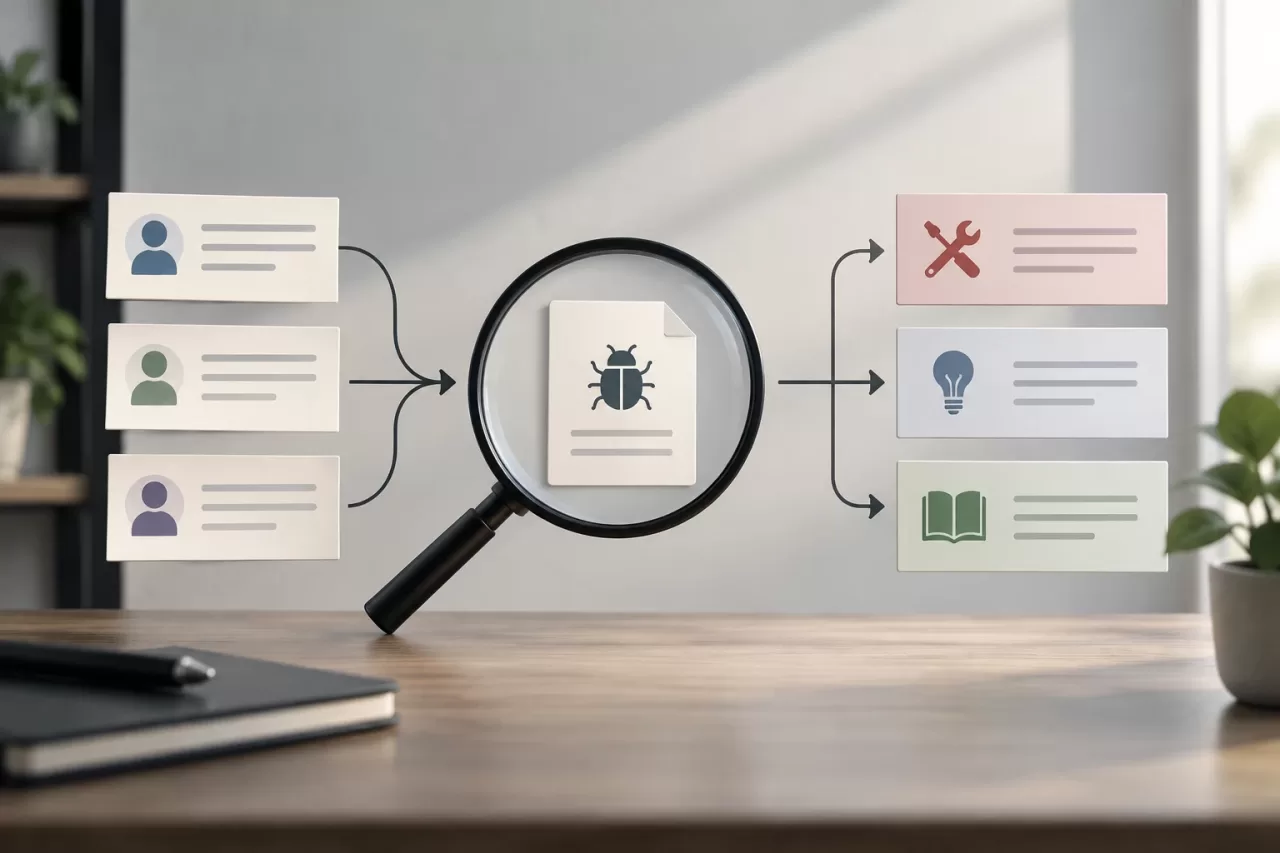
Um incidente descreve algo que aconteceu; um requisito expressa uma capacidade ou restrição que o sistema deve atender. Por exemplo, vários usuários que pedem ajuda para corrigir uma fatura podem estar encontrando o mesmo defeito de cálculo. Também podem desconhecer uma funcionalidade existente ou trabalhar com um procedimento que não está documentado.
Contar solicitações sem classificá-las pode distorcer a prioridade. Um mesmo usuário pode abrir vários tickets sobre um único problema, enquanto um risco importante talvez apareça apenas uma vez. Convém agrupar por causa e resultado afetado, não apenas por frases semelhantes ou pelo número de tickets.
Classificar: defeito, treinamento, exceção ou nova necessidade
Antes de propor uma melhoria, identifique que tipo de situação está sendo observada:
- Defeito: o sistema não atende a uma regra já acordada. Compare o comportamento real com a especificação, os registros e os casos reproduzíveis.
- Falta de treinamento ou clareza: a capacidade existe, mas os usuários não a encontram ou interpretam o fluxo de maneiras diferentes. Revise instruções, rótulos e etapas.
- Exceção: um caso legítimo não se encaixa no fluxo habitual, como uma devolução parcial ou uma aprovação fora do horário. Determine se é uma exceção válida e quem pode autorizá-la.
- Nova necessidade: o processo mudou ou falta uma capacidade que não fazia parte do comportamento esperado. É preciso avaliar seu valor, escopo e consequências.
A classificação pode mudar durante a investigação. Não encerre a decisão com base apenas no título do ticket: pergunte o que a pessoa estava tentando fazer e de qual resultado precisava.
Coletar contexto e evidências que ajudem a entender o caso
Um relato útil reconstrói o percurso, não apenas a última mensagem de erro. Registre o papel de quem executa a tarefa, o objetivo, as etapas anteriores, os dados relevantes, o resultado obtido e o resultado esperado. Acrescente frequência, impacto operacional e evidências disponíveis, como uma captura de tela, um identificador de operação ou um registro técnico.
Em aplicações PHP, a equipe pode correlacionar o relato com logs, respostas da API, validações do servidor e dados persistidos, sempre com as permissões e os controles de privacidade adequados. Evite copiar informações pessoais ou credenciais para os tickets; use dados anonimizados ou referências seguras. As evidências ajudam a reproduzir o caso, mas não substituem a explicação da regra de negócio.
Perguntas práticas para suporte ou produto:
- Quem executa a tarefa e com quais permissões?
- O que estava tentando concluir e por quê?
- Quais etapas e condições antecederam o problema?
- O que esperava que acontecesse e o que aconteceu de fato?
- Há exemplos que funcionaram e outros que falharam?
- Qual é o impacto e existe uma alternativa manual aceitável?
Encontrar a regra de negócio e registrar suas exceções
Vários exemplos permitem formular uma hipótese, mas não bastam para declarar uma regra. Compare os casos com as pessoas que executam o processo e com quem responde por suas políticas. Procure identificar qual condição altera o resultado: estado da operação, tipo de cliente, valor, prazo, permissões ou relação entre registros.
Escreva a regra de forma direta e indique seus limites. Por exemplo: “Uma solicitação pode ser aprovada se estiver completa e pertencer a um período aberto”. Em seguida, esclareça o que significa “completa”, quem determina que o período está aberto e o que acontece com solicitações corrigidas, duplicadas ou recebidas no encerramento. Se as pessoas responsáveis não concordarem sobre essas respostas, ainda não há uma especificação estável.
As exceções não são detalhes que devam ser ocultados em uma observação. Elas podem exigir permissões diferentes, revisão humana, registro de uma justificativa ou um fluxo separado. Se uma exceção for rara, mas tiver alto impacto, sua baixa frequência não a torna irrelevante.
Redigir critérios de aceitação observáveis
Um requisito pode ser validado quando descreve resultados que alguém consegue verificar. Evite expressões como “gerenciar corretamente” ou “facilitar” se elas não vierem acompanhadas de condições concretas. Os critérios devem cobrir o fluxo normal, os dados inválidos, as permissões e os casos-limite identificados.
Uma forma simples de redigi-los é: “Dado [contexto], quando [ação], então [resultado observável]”. Por exemplo: “Dado um usuário autorizado e um período aberto, quando ele envia uma solicitação completa, então o sistema a registra com o status pendente e exibe seu identificador”. Acrescente outro critério para um período fechado e especifique se a solicitação é rejeitada, mantida como rascunho ou exige aprovação.
Em uma aplicação PHP, os critérios podem orientar testes unitários de regras de domínio, testes de integração de persistência ou da API e testes funcionais do fluxo. Não prescreva uma implementação antes de entender a necessidade: uma regra pode corresponder a uma validação, autorização, transição de estado ou alteração de processo.
Priorizar e validar com produto, operações e desenvolvimento
Priorize de acordo com impacto, risco, escopo e custo de oportunidade, não apenas pelo volume de tickets. Esclareça quantas pessoas ou processos são afetados, quais são as consequências da falha, se existe um controle temporário e quanto trabalho é necessário para cobrir também as exceções. Um problema pouco frequente pode merecer atenção prioritária se causar perda de dados ou descumprimento de uma obrigação.
Antes de estimar, produto deve confirmar o resultado e os limites; operações, que o fluxo descreve a prática real; e desenvolvimento, que os critérios são tecnicamente compreensíveis e verificáveis. Se ainda houver dúvidas, combinem uma investigação delimitada, um teste manual ou a observação do processo. Não transformem uma hipótese em automação apenas para fechar tickets mais rapidamente.
Após a alteração, valide os critérios com casos representativos e monitore se a causa original diminui sem criar novos bloqueios. Implementação, implantação e ativação para usuários são decisões distintas: se o risco justificar, uma versão pode ser disponibilizada gradualmente, com métricas e uma opção de reversão. Documente o que é considerado sucesso e quem decide interromper ou ajustar a entrega.
Modelo breve para levar um incidente a uma decisão
Use esta ficha como ponto de partida e preencha apenas o que puder sustentar com evidências:
- Grupo de incidentes e período: tickets relacionados, datas e critério usado para agrupá-los.
- Pessoa e tarefa: papel, objetivo e contexto operacional.
- Comportamento observado: etapas, dados pertinentes e resultado real.
- Resultado esperado: necessidade expressa sem ainda propor uma solução.
- Classificação e hipótese: defeito, treinamento, exceção ou nova necessidade; causa a confirmar.
- Regra e exceções: condição que determina o resultado, responsável pela regra e limites conhecidos.
- Impacto e alternativa: consequências, escopo e procedimento temporário.
- Critérios de aceitação: casos normais, inválidos, permissões e limites, com resultados observáveis.
- Decisão e validação: prioridade, responsáveis, testes previstos e sinal para revisar o resultado.
Se não for possível definir a regra, as exceções ou os resultados esperados, a conclusão correta pode ser investigar, melhorar o treinamento ou corrigir o defeito existente, em vez de criar uma nova funcionalidade. Essa distinção transforma o suporte recorrente em decisões de produto mais claras e reduz alterações baseadas em suposições.